Hermes Agent에서 provider 이름을 바꿔도 청구서가 거의 그대로인 경우가 많다. 이유는 벤치마크 순위가 아니라 설정 구조에 있다. 보조 작업 슬롯이 기본값 auto로 메인 모델을 그대로 쓰고, 컨텍스트 압축은 기본 50% 근처에서 걸리며, /model 전환이나 폴백이 한 번 일어나면 프롬프트 캐시가 깨져 다음 요청이 대화를 정가로 다시 읽는다.
세션 제목 생성, 압축, 승인 판정, 웹 추출처럼 사소해 보이는 작업이 같은 고가 모델을 물고 들어가면, OpenRouter를 Anthropic으로, Anthropic을 Portal로 갈아탔다고 생각하는데 실제 과금 구조는 거의 남는다. 반대로 로컬 모델로 비용을 아끼려 해도 컨텍스트가 부족하면 시작 단계에서 거부된다.
원문과 공식 Quickstart는 Hermes가 64,000 토큰 미만 모델을 시작 시점에 거부한다고 적는다. 시스템 프롬프트와 도구 스키마가 기본 공간을 많이 먹기 때문이라는 설명이다. 호스팅 provider는 대체로 이 조건을 넘지만, Ollama 기본 컨텍스트는 VRAM에 따라 4,096 또는 32,768로 뜨는 경우가 많다.
순서는 provider 이름보다 인증 경로, 64K 컨텍스트, 보조 슬롯, 압축, 그다음 폴백이다. 이 순서를 뒤집으면 provider를 갈아타도 청구서와 실패 패턴이 거의 그대로 남는다. hermes model은 새 provider를 붙이고, 세션 안의 /model은 이미 붙은 provider 사이를 바꾼다.
auto 슬롯 11개
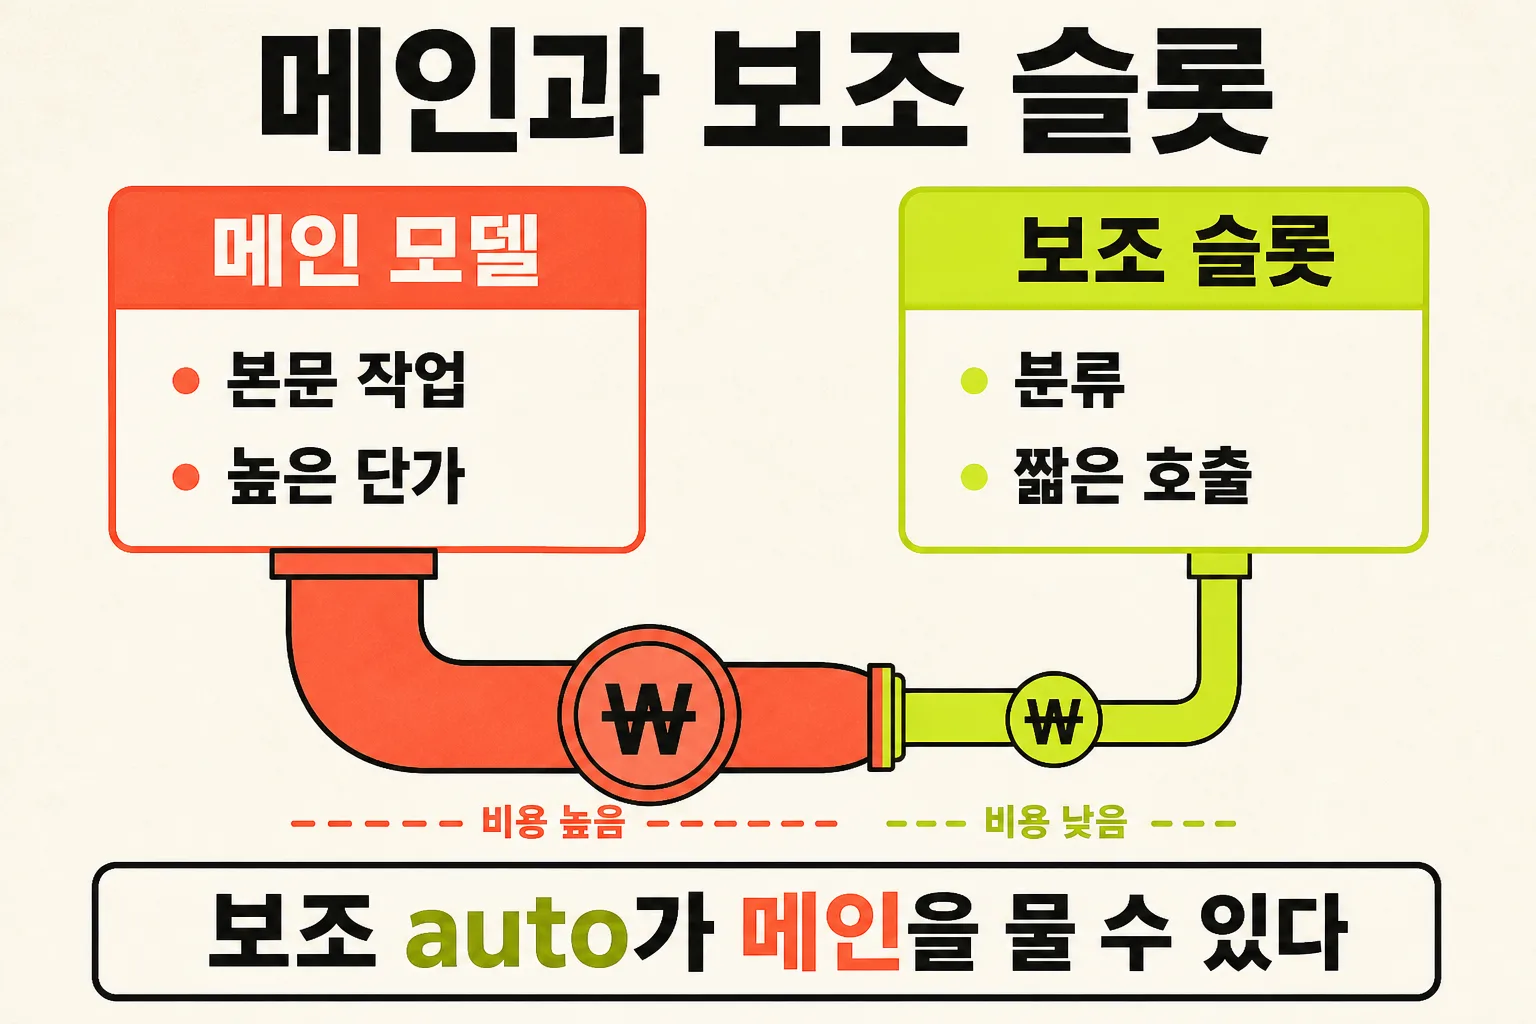
Hermes는 두 종류의 모델 슬롯을 쓴다. 메인 모델은 에이전트가 생각하는 경로다. 사용자 메시지, 도구 호출 루프, 스트리밍 응답이 여기를 지난다. 보조 모델은 컨텍스트 압축, 비전, 웹 요약, 승인 점수, MCP 라우팅, 세션 제목, 스킬 검색처럼 옆일을 맡는다. 대시보드 Models 화면에서 Show auxiliary를 누르면 작업 슬롯 11개가 나온다.
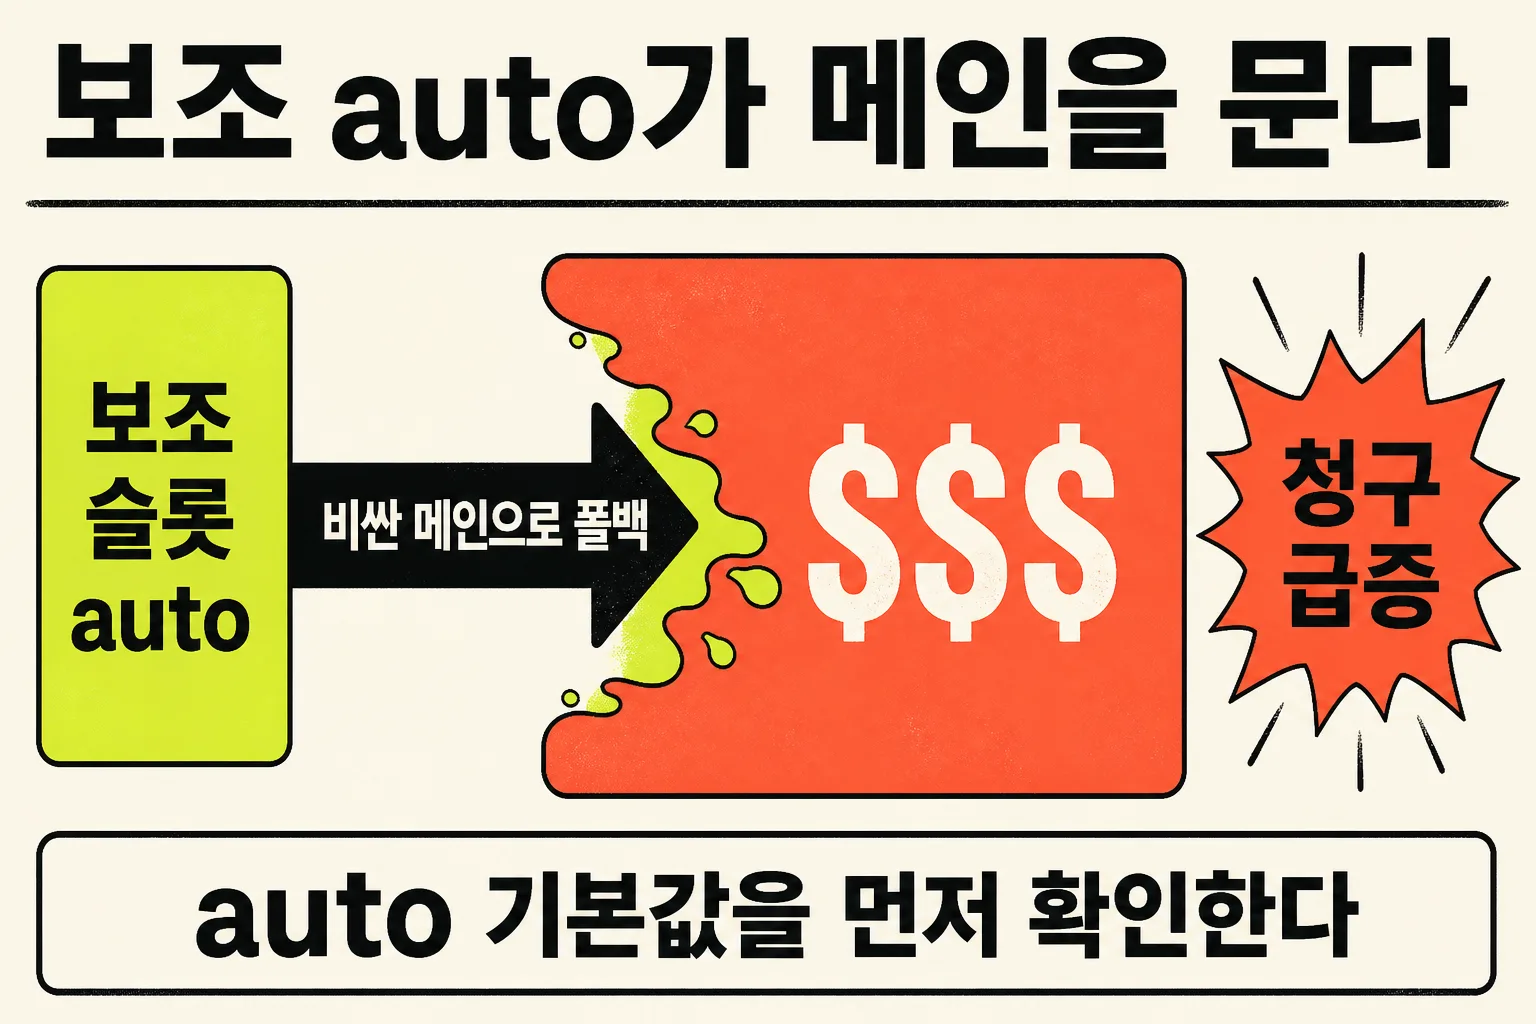
모든 보조 작업의 기본값은 auto다. auto는 대체로 메인 모델을 먼저 사용한다. 그 경로가 없거나 용량 실패가 나면, 작업별 auxiliary.<task>.fallback_chain, 그다음 메인 fallback_providers, 그다음 내장 보조 탐색 순으로 간다. 메인 모델을 Opus나 고가 추론 모델로 두면, 세션 제목 짓기나 압축 요약 같은 작은 작업도 같은 가격표로 처리될 수 있다. 그래서 provider를 바꿨는데도 비용이 안 내려가는 일이 생긴다.
설정은 대시보드 Models 화면의 Show auxiliary에서 슬롯별로 바꾸거나, 모델 카드의 Use as로 한 번에 배정한다. YAML 기준으로는 auxiliary.title_generation에 provider와 model을 적는 형태다. provider: auto에 model: ''이면 그 작업은 메인을 쓴다.
보조 슬롯에 지정한 provider가 실제로 인증되지 않았으면 조용히 기본값으로 떨어지고 로그에만 경고가 남을 수 있다. 슬롯을 바꾼 뒤 새 세션을 연다. 이미 열린 채팅은 config.yaml을 다시 읽지 않는다. Reset all to auto는 11개 슬롯을 다시 메인으로 되돌린다.
| 먼저 볼 것 | 이유 | 빠뜨리면 |
|---|---|---|
| 인증 경로 | 구독이 실제로 연결 가능한지 | provider 추가 자체가 안 됨 |
| 64K 컨텍스트 | 시작 가능 여부 (원문·Quickstart 주장) | 로컬 모델이 즉시 거부됨 |
| 보조 슬롯 11개 | 작은 작업 과금 | 세션 제목까지 비싼 모델이 처리 |
| 압축 임계값 | 긴 세션 기억 유지 | 요약 실패 후 중간 대화 손실 |
| 프롬프트 캐시 | 멀티턴 입력 비용 | 모델 전환 때 재읽기 비용 급증 |
핵심 포인트: 비싼 청구서는 메인 답변 한 번보다, 작은 보조 작업이 같은 고가 모델을 계속 물고 들어갈 때 더 자주 생긴다. provider 교체보다 앞선 확인 항목은 슬롯이 auto인지다.각 슬롯이 하는 일
공식 Configuring Models 문서가 적는 11개 작업과 덮어쓰는 때는 아래와 같다. 슬롯 이름은 대시보드 라벨과 YAML 키가 조금 다르다. YAML은 소문자 밑줄이다.
| 슬롯 (YAML) | 하는 일 | 덮어쓰는 때 |
|---|---|---|
title_generation | 세션 제목 생성 | 지연·비용이 메인과 같을 이유가 없을 때. prefer_fast_model: true면 그 provider의 빠른 티어를 고른다 |
vision | 이미지 분석 | 메인이 비전을 지원하지 않을 때 |
compression | 컨텍스트 요약 | 비싼 추론 모델로 요약만 하고 있을 때 |
approval | approval_mode: smart에서 저위험 명령 자동 승인 여부 | smart 모드 호출이 잦을 때. 비싼 모델은 낭비 |
web_extract | 웹 페이지 요약 | web_extract 사용량이 많을 때. 압축과 같은 비용 구조 |
skills | hermes skills search | 보통 auto 유지 |
mcp | MCP 도구 라우팅 | 보통 auto 유지 |
| triage specifier | Kanban hermes kanban specify. 한 줄을 구체 스펙으로 펼침 | 싼 모델로 충분한 경우가 많음 |
| kanban decomposer | 트리아지 작업을 자식 작업 그래프로 나눔 | 분해가 잦을 때 |
| profile describer | hermes profile describe --auto / 대시보드 자동 생성 | 짧은 호출 |
| curator | 스킬 사용 리뷰. 추론 모델에서는 수 분이 걸릴 수 있음 | 싼 aux가 유리한 경우가 많음 |
제목과 압축을 플래시급으로 나누는 YAML 예는 아래와 같다.
auxiliary:
  title_generation:
    provider: openrouter
    model: google/gemini-3-flash-preview
  compression:
    provider: openrouter
    model: google/gemini-3-flash-preview
CLI로 같은 키를 쓰는 예는 hermes config set auxiliary.title_generation.provider openrouter와 hermes config set auxiliary.title_generation.model google/gemini-3-flash-preview다. Use as → All auxiliary tasks는 11개 슬롯에 한 모델을 한꺼번에 넣는다.
작업별 fallback_chain은 그 슬롯만의 보조 목록이다. 없으면 메인 fallback_providers가 먼저 쓰인다.
hermes model vs /model
hermes model과 세션 안의 /model은 다른 명령이다. hermes model은 대화형 프로바이더·모델 고르기다. OAuth는 브라우저를 열고, API 키 provider는 키를 받는다. 선택은 model.provider와 model.default로 ~/.hermes/config.yaml에 기록된다. 새 세션만 그 값을 읽는다. 이미 열린 채팅은 시작한 모델을 유지한다.
/model은 이미 설정된 provider 사이 전환이다. 새 provider 추가나 OAuth 재인증은 세션을 나간 뒤 hermes model에서 한다. 원하는 provider가 목록에 아예 없으면 /model만 반복한 상태일 가능성이 크다. 피커 왼쪽은 인증된 provider만 보여 준다. 키가 없으면 Keys 화면이나 hermes setup이 먼저다.
세션 안에서 쓰는 형태는 아래와 같다.
/model gpt-5.4 --provider openrouter
/model gpt-5.4 --provider openrouter --global
/model claude-opus-4.6 --once--global은 대시보드 Change와 같이 yaml에 남기고, 실행 중 세션도 바꾼다. --once는 한 턴만 올리고 성공, 오류, 중단 모두에서 이전 모델로 되돌린다. 게이트웨이가 그 턴 중간에 재시작되면 원래 모델로 돌아온다. 한 턴 전환은 캐시 프리픽스를 두 번 깨뜨린다. 짧은 세션의 비싼 질문 한 번은 이득일 수 있고, 긴 세션의 곁다리 질문은 재읽기 비용이 더 클 수 있다.
대시보드에서 메인을 바꿔도 실행 중 채팅은 그대로다. 핫스왑은 그 채팅 안의 /model이다. 게이트웨이(Telegram, Discord, Slack)도 다음 새 세션부터 적용된다. 모든 세션을 강제로 바꾸려면 hermes gateway restart다.
설치 직후 config.yaml의 model: ""는 아직 설정되지 않았다는 센티널이다. hermes setup 또는 hermes model이 그 키를 provider, default, base_url, api_mode 매핑으로 올린다.
Anthropic Max extra credits
많이 하는 오해는 이미 구독 중이니 Hermes에 그냥 붙으면 된다는 것이다. 공식 문서 기준으로는 provider마다 시작 조건이 다르다.
Anthropic OAuth는 Claude Max 플랜과 별도 구매한 extra usage credits가 있어야 동작한다. Max에 기본 포함된 사용량이 아니라 추가로 충전한 크레딧만 Hermes 경로에서 차감된다. Max만 있고 extra credits가 없으면 인증 화면은 열려도 호출이 거절될 수 있다.
Nous Portal은 OAuth 한 번으로 여러 모델과 Tool Gateway까지 연결되는 쪽이라, 새로 시작하는 사람에게 마찰이 가장 적다. hermes setup --portal이 그 경로다. hermes portal info는 무엇이 연결됐는지 본다. Portal 구독자는 토큰 과금 provider에 10% 할인이 문서에 적혀 있다.
OpenAI Codex는 device code 방식이라 별도 CLI 설치 없이도 붙을 수 있지만, 인증 파일 위치와 저장 방식은 일반 API 키 흐름과 다르다. xAI처럼 모델 은퇴가 빠른 provider는 반년만 지나도 가격표와 목록이 낡아 버린다.
Copilot 토큰 접두
GitHub Copilot은 ghp_* 클래식 PAT를 받지 않는다. 허용하는 접두는 gho_, github_pat_, ghu_ 계열이다. 클래식 PAT를 넣으면 인증이 실패하거나 목록에 provider가 안 나온다. 접두가 다른 토큰을 같은 칸에 넣으면, 「이미 Copilot 구독 중인데 Hermes가 안 붙는다」로 보인다.
피커에 「No authenticated providers」가 나오면 키가 없는 상태다. Keys 화면에 API 키, 성공한 OAuth, 커스텀 엔드포인트 URL 중 하나가 있어야 왼쪽 열에 이름이 뜬다.
64K
원문과 Hermes Agent Quickstart는 컨텍스트 64,000 토큰 미만 모델을 시작 시점에 거부한다고 적는다. 이유는 시스템 프롬프트와 도구 스키마만으로도 기본 공간을 많이 먹기 때문에, 그 아래로는 멀티스텝 툴 호출이 안정적으로 성립하지 않는다는 설명이다.
호스팅 provider는 대체로 이 조건을 넘지만 로컬 엔드포인트는 자주 여기서 걸린다. 로컬 모델이 대답은 되는 것과 Hermes에서 실전 세션이 버티는 것은 같은 말이 아니다. 64K 미만이면 시작 단계에서 걸러진다는 것이 원문·Quickstart의 주장이다.
커스텀 엔드포인트의 모델 별칭에 context_length를 적는 구성이 문서에 있다. 게이트웨이가 요청 뒤에야 별칭을 해석하면, prompt_caching: true로 캐시 마커를 켜는 경로가 있다. openai_chat과 anthropic_messages는 마커 레이아웃이 다르다.
Ollama -c
Ollama 기본 컨텍스트는 VRAM에 묶여 있다.
| VRAM | Ollama 기본 컨텍스트 |
|---|---|
| 24GB 미만 | 4,096 |
| 24GB 이상 48GB 미만 | 32,768 |
| 48GB 이상 | 256,000 |
일반적인 데스크톱에서 ollama serve를 그대로 켜면 4K나 32K로 뜰 수 있다. OpenAI 호환 API 경로에서는 요청마다 컨텍스트를 올리는 방식이 아니라 서버 쪽 설정 자체를 바꾼다.
서버 전체에 적용하는 예는 아래와 같다.
OLLAMA_CONTEXT_LENGTH=64000 ollama serve모델 Modelfile에서는 PARAMETER num_ctx 64000 형태다. llama.cpp 계열은 --ctx-size 65536 같은 방식이다. Hermes 문서 예는 Ollama -c 65536이다. 로컬 모델로 비용을 아끼고 싶다면 단가보다 먼저 이 숫자가 가능한지부터 본다.
discover_models: false는 엔드포인트 /models 목록을 건너뛰고 설정에 적은 모델만 쓴다. 목록이 느리거나 잡음이 많을 때 피커가 그 목록 대신 설정 목록을 보여 준다.
압축 50%
Hermes 압축은 두 층이다. 에이전트 내부 압축은 기본적으로 컨텍스트의 50% 근처에서 걸리고, 게이트웨이 쪽 검사는 더 높은 비율에서 안전망처럼 한 번 더 작동한다. 긴 세션을 유지하는 데는 이 구조가 도움이 되지만, 보조 압축 모델이 메인보다 작은 컨텍스트를 가지면 상황이 거꾸로 나빠진다.
가장 조용하고 가장 아픈 함정은 이것이다. 요약 모델 컨텍스트가 메인 모델보다 작으면, 중간 대화가 요약 없이 버려질 수 있다. 압축해야 하는 구간 전체를 요약 모델이 한 번에 받아야 하는데, 여기서 컨텍스트 초과가 나면 경고만 남기고 요약을 포기한 채 오래된 턴을 떨궈 버릴 수 있다. 사용자는 갑자기 앞 대화를 잊는다고 느끼고, 원인을 provider 품질 탓으로 오해하게 된다.
1M 컨텍스트 모델과 128K 모델을 오가는데 모든 모델에 같은 임계값 50%를 두는 것도 낭비다. compression.threshold와 model_thresholds로 모델별 값을 나누면 긴 세션에서 압축 호출 빈도를 더 현실적으로 조정할 수 있다.
compression:
  threshold: 0.50
  model_thresholds:
    "glm-5.2": 0.40
    "claude-sonnet": 0.35
세션 중간 모델 전환은 새 창의 압축 임계값을 미리 추정한다. 세션이 이미 그 근처면 전환 응답에 경고가 붙는다. 전환은 즉시 적용되고, 압축은 전환 후 첫 사용자 메시지 앞에 돈다.
핵심 포인트: 싼 압축 모델이 메인보다 창이 작으면 요금은 줄어도 기억이 잘린다. 비용 최적화와 세션 유지가 같은 축이 아니다.
캐시 리셋
Claude 계열처럼 프롬프트 캐싱이 잘 붙는 provider는 멀티턴 입력 비용을 크게 줄인다. 캐시 키는 보통 모델과 계정에 묶여 있다. 세션 중간에 /model로 모델을 바꾸거나, 폴백이 발동해 다른 provider로 넘어가거나, credential pool이 다른 계정으로 돌면, 다음 요청이 전체 대화를 할인 없이 다시 읽을 수 있다.
fallback_providers는 세션 단위가 아니라 턴 단위다. 새 사용자 메시지가 들어올 때마다 primary부터 다시 시도하고, 그 턴에서만 보조 provider를 쓴다. 장애를 피하는 데는 좋지만, 긴 세션에서는 provider를 자주 오갈수록 캐시 손실 가능성이 커진다. 모델 전환은 세션 초반이나 새 세션에서 하고, 긴 세션 중간에는 가급적 그대로 가는 편이 캐시에 유리하다.
model:
  provider: anthropic
  default: claude-sonnet-4-6

fallback_providers:
  - provider: openrouter
    model: anthropic/claude-sonnet-4
대시보드의 메인 변경은 실행 중 세션의 캐시를 깨지 않는다. 의도된 동작이다. 시스템 프롬프트에 모델별 내용이 들어 있어서, 캐시 리셋은 채팅 안의 명시적 /model에 맡긴다.
config.yaml과 .env
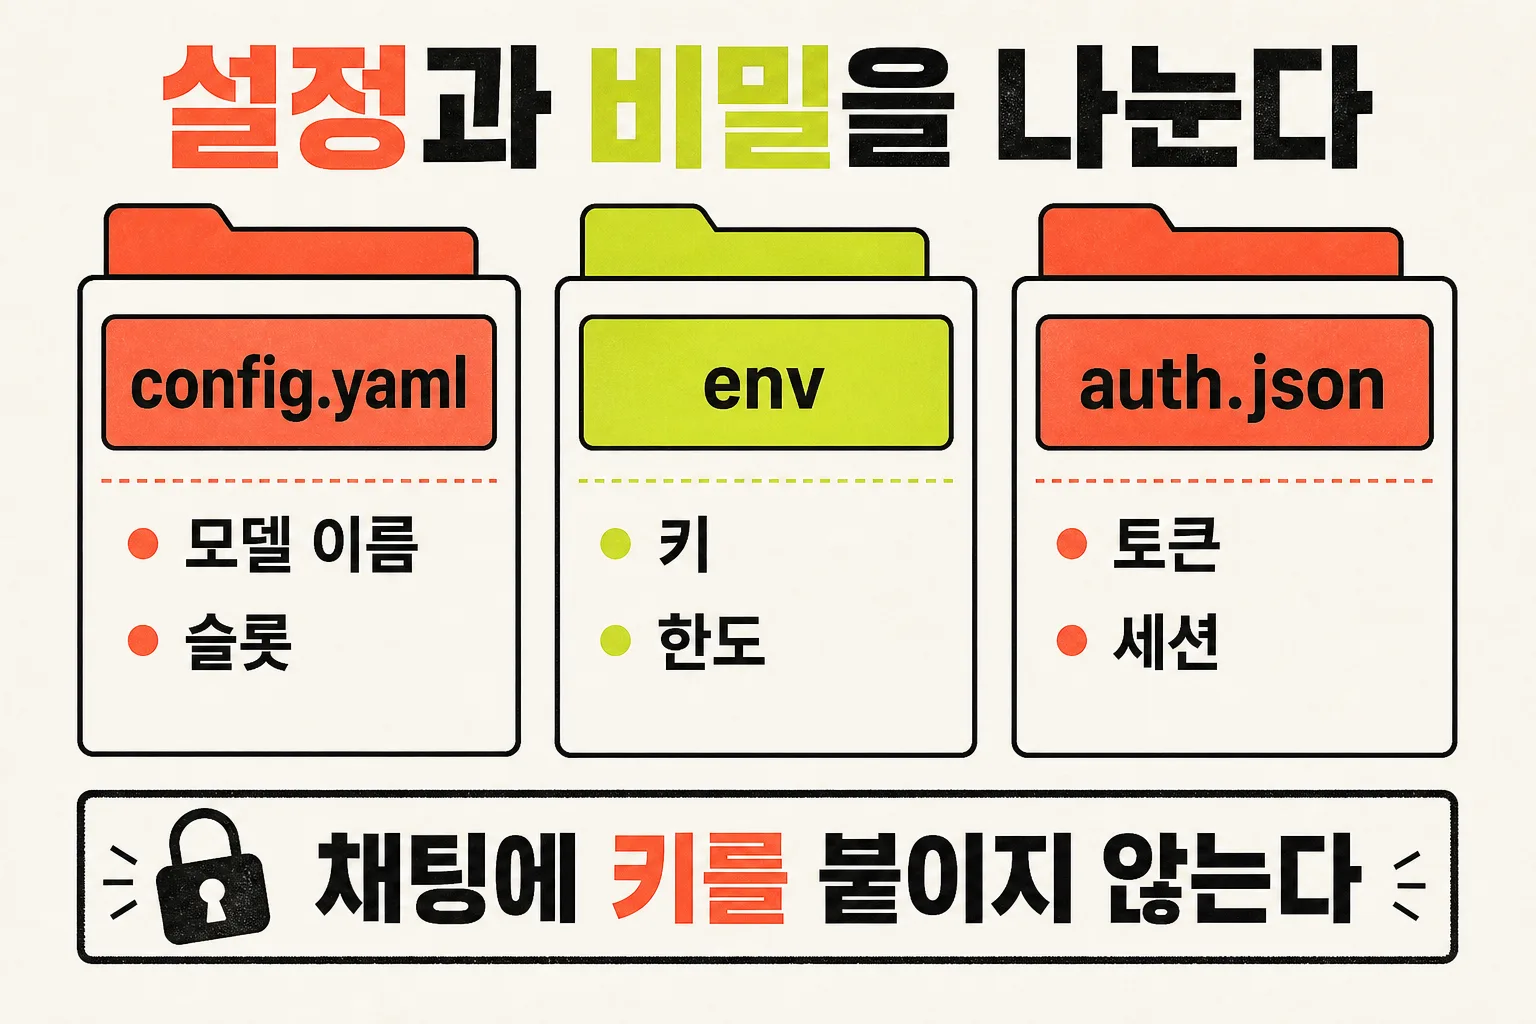
Hermes는 일반 설정과 시크릿을 파일 단위로 나눈다.
~/.hermes/
├── config.yaml
├── .env
├── auth.json
└── logs/config.yaml에는 모델, 터미널 백엔드, 압축 같은 비밀이 아닌 설정이 들어간다. .env와 auth.json에는 API 키와 OAuth 자격증명이 들어간다. 회사 키와 개인 키가 섞이면 감사 대응이 어려워지고, Docker 백엔드에서 컨테이너로 넘기는 환경 변수 화이트리스트까지 헷갈리기 시작한다.
조직 환경이면 managed scope, egress 프록시, docker_forward_env 같은 경계 도구가 있는지까지 본다. 회사 저장소에서 Hermes를 돌릴 때는 어떤 키가 config.yaml, .env, auth.json, 컨테이너 전달 목록 중 어디에 놓였는지 한 번에 설명할 수 있어야 한다.
providers.<name>.extra_headers는 그 엔드포인트로 가는 모든 LLM 요청에 헤더를 붙인다. Cloudflare Access 서비스 토큰 같은 값이다. 헤더 값은 자격증명이므로 Hermes는 로그에 남기지 않는다. anthropic_messages와 bedrock_converse API 모드는 이 키를 쓰지 않는다.
공식 문서 흐름에서 반복해서 나오는 원칙은 평범하다. 평범한 대화 한 번이 안 되면 기능을 더 붙이지 않는다. provider를 붙이고, 세션을 열고, 재개를 확인하고, 그 다음에야 보조 슬롯과 샌드박스를 만진다.
hermes model
hermes --tui
hermes --continue
hermes config set auxiliary.title_generation.provider openrouter
hermes config set terminal.backend docker
hermes egress setup
hermes egress start
hermes doctor
hermes config get model --json
hermes model은 provider를 붙인다. --tui는 평범한 대화를 본다. --continue는 세션 재개다. auxiliary와 Docker, egress는 그 다음이다. hermes fallback add는 폴백을 마지막에 넣는다. docker run으로 이미지를 직접 돌리는 예시는 공식 표준 설치 경로라기보다 특정 작성자 환경에 가깝다.
사용량은 총액보다 비율을 봐야 원인이 보인다. Models 화면 하단의 모델별 사용량 카드에서 실제로 어떤 모델이 메인인지, 어떤 모델이 aux 슬롯으로 올라오는지를 같이 본다. 보조 작업 모델이 상위 사용량에 자주 보이면 슬롯 정리가 안 된 상태다. 압축 호출이 유난히 많으면 threshold를 올리거나 model_thresholds로 모델별 조정이 필요하다. 폴백 모델이 자주 보이면 primary가 불안정하고 캐시도 자주 깨지고 있을 가능성이 크다.
| 분류 | 대표 | 쓰는 때 | 실제 걸림돌 |
|---|---|---|---|
| 구독 통합 | Nous Portal | 오래 켜두는 기본 엔진 | 초기 마찰이 적지만 조직 정책 확인은 필요 |
| 구독 OAuth | Anthropic, Codex, Copilot, xAI, Qwen | 이미 구독 중일 때 | 플랜 조건, 토큰 종류 제한, 원격 환경 인증 |
| 종량제 API | OpenRouter, DeepSeek, GLM, Kimi, Fireworks | 비교 실험, 특정 작업 검증 | 한도 관리 안 하면 테스트만으로도 크레딧 소진 |
| 로컬/셀프호스트 | Ollama, LM Studio, vLLM | 민감 자료, 반복 초안 | 64K 컨텍스트가 실질 진입장벽 |
| 엔터프라이즈 | Bedrock, Vertex, Azure Foundry | 회사 계약이 이미 있을 때 | 인증 체인이 API 키보다 복잡 |
| 증상 | 먼저 의심할 원인 | 조치 | |
| 원하는 provider가 목록에 없음 | 세션 안에서 /model만 사용 | 세션 종료 후 hermes model | |
| 시작 시 모델이 거부됨 | 컨텍스트 64K 미만 (원문 주장) | 서버 쪽 num_ctx, --ctx-size | |
| 커스텀 엔드포인트 응답이 이상함 | base URL 또는 모델명 오류 | 다른 클라이언트에서 먼저 검증 | |
| 긴 세션에서 앞 맥락을 잊음 | 압축 모델 컨텍스트가 더 작음 | auxiliary.compression 재검토 | |
| 비용이 예상의 몇 배로 뜸 | 보조 슬롯이 전부 auto | auxiliary 슬롯부터 분리 | |
| 모델을 바꿨는데 진행 중 채팅은 그대로 | 실행 중 세션이 기존 모델 유지 | 새 세션 또는 /model 핫스왑 |
별칭과 적용 시점
자주 쓰는 모델에 짧은 이름을 붙이면 /model fav처럼 세션 안에서 부른다. 정본 형식은 최상위 model_aliases:다. provider와 base_url까지 적을 수 있다. 짧은 문자열 형식은 model.aliases.fav에 anthropic/claude-opus-4.6처럼 넣는 쪽이다. hermes config set이 스칼라와 인라인 리스트, 매핑 리터럴을 받는다. 짧은 형식은 커스텀 base_url을 못 싣는다. 같은 이름이면 model_aliases:가 model.aliases:보다 앞선다. 사용자 별칭은 내장 짧은 이름(sonnet, kimi, opus)을 가린다.
CLI 채팅은 다음 hermes chat 호출부터 메인을 읽는다. 게이트웨이(Telegram, Discord, Slack)는 다음 새 세션부터다. 대시보드 /chat 탭은 다음 새 PTY다. 이미 열린 채팅은 시작한 모델을 유지한다. 핫스왑은 그 안의 /model이다. 모든 게이트웨이 세션을 강제로 바꾸려면 hermes gateway restart다. 대시보드의 메인 변경은 실행 중 세션의 캐시를 깨지 않는다.
비대화형 경로(Kanban worker, cron)는 데이터 학습 할인 티어를 묻지 못하므로 실패 닫힘이다. 무인 작업의 학습이 허용되면 hermes config set security.allow_data_training_tiers_noninteractive true가 지속 확인이다. 무인 기동마다 경고와 확인 키가 로그에 남는다. 이 설정은 비싼 모델 경고나 라우팅 경고를 승인하지 않고, 대화형 확인을 대체하지 않는다. 해제는 hermes config unset security.allow_data_training_tiers_noninteractive다.
OpenRouter 같은 집계기에서 맨 모델 이름은 그 집계기 안에서 먼저 해석된다. claude-sonnet-4를 OpenRouter에 두면 anthropic/claude-sonnet-4.6으로 남고 인증은 OpenRouter다. 네이티브 Anthropic 인증에 같은 문자열을 치면 그 계정의 모델 ID로 남는다. 예상과 다른 provider로 바뀌면 피커 상단의 현재 메인이 먼저다.
레거시 custom_providers: 리스트는 base_url을 썼다. 지금도 동작하고 hermes update(config v12)에서 providers: 딕셔너리로 옮겨진다. 새 설정은 providers.<name>.api다. discover_models: false는 /models 목록을 건너뛰고 설정에 적은 모델만 피커에 보여 준다.
사용량 카드가 가리는 원인
Models 화면 하단의 모델별 사용량 카드는 총액보다 비율이 원인 분리에 가깝다. 메인 뱃지와 aux 뱃지가 같은 기간의 토큰과 비용을 나란히 보여 준다. 보조 작업 모델이 상위 사용량에 자주 보이면 11개 슬롯이 아직 auto이거나, 지정한 provider가 인증되지 않아 메인으로 떨어진 상태다. 압축 호출이 유난히 많으면 threshold 0.50이 그 모델 창에 비해 이르게 걸린다. model_thresholds로 창이 큰 모델은 더 늦게, 작은 모델은 더 이르게 나눌 수 있다. 폴백 모델이 자주 보이면 primary가 불안정하고 캐시도 자주 깨지고 있을 가능성이 크다.
보조 슬롯 덮어쓰기가 「안 먹는 것 같으면」 세 가지가 먼저다. 새 세션을 열었는지. provider가 여전히 auto인지. 지정한 provider에 키가 있는지. MiniMax를 슬롯에 넣었는데 키가 없으면 OpenRouter 기본으로 떨어지고 agent.log에만 경고가 남을 수 있다.
hermes config get model --json은 CLI가 지금 쓸 메인을 보여 준다. hermes doctor는 인증과 설정 경로를 같이 본다. 단가표는 몇 달 안에 낡는다. 이 두 명령이 더 오래 간다.
hermes --tui에서 저장소 요약 같은 평범한 대화가 성립한 뒤에야 보조 슬롯과 샌드박스, 게이트웨이를 만진다. hermes --continue는 세션 재개다. hermes egress setup과 hermes egress start는 Docker 백엔드에서 키가 컨테이너에 직접 들어가지 않게 한다. hermes fallback add는 폴백을 마지막에 넣는다. 폴백을 먼저 켜면 어느 provider가 실패했는지 잊히기 쉽다.
대시보드 REST는 스크립트용이다. /api/model/options는 인증된 provider와 큐레이트 모델 목록이다. /api/model/auxiliary는 현재 메인과 보조 배정이다. POST /api/model/set의 scope: main은 메인을 바꾸고, scope: auxiliary에 task가 있으면 그 슬롯만, task가 빈 문자열이면 11개 전부, task: __reset__이면 전부 auto다. 세션 토큰은 대시보드 HTML에 주입되고 서버 재시작마다 바뀐다.
Ollama VRAM 표의 4,096과 32,768과 256,000은 서버 기본값이다. OLLAMA_CONTEXT_LENGTH=64000은 프로세스 전체에 적용되고, Modelfile PARAMETER num_ctx 64000은 그 모델에만 적용된다. Hermes 문서 예 -c 65536과 llama.cpp --ctx-size 65536은 같은 하한을 서버 쪽에 맞추는 다른 플래그다.
압축 슬롯은 컨텍스트가 약 50%를 넘으면 요약을 돌린다. 캐시 리셋은 프로바이더나 모델을 바꾼 뒤에 옛 프롬프트 캐시가 새 요청에 붙지 않게 한다. Dashboard의 Show auxiliary와 Use as, Reset all to auto는 11개 보조 슬롯을 한 화면에서 고른다. hermes model은 CLI에서 기본 채팅 모델을 바꾸고, 채팅의 /model은 그 세션만 바꾼다. REST /api/model 계열은 TUI와 대시보드가 같은 설정을 읽는 경로다. Copilot 토큰 접두는 문서가 적는 공급자별 식별 문자열이다.
마무리
앞에서 다룬 Hermes provider 선택과 비용 구조의 핵심만 짧게 정리한다.
- provider 이름보다 인증 경로, 64K 컨텍스트, 보조 슬롯이 앞선다.
- 보조 슬롯 11개가
auto면 제목 생성도 메인 단가를 문다. hermes model은 새 provider,/model은 이미 붙은 provider 사이 전환이다.- Anthropic은 Max extra credits, Copilot은
gho_,github_pat_,ghu_접두다. - 압축 모델 창이 메인보다 작으면 중간 대화가 잘릴 수 있다. 기본 임계값은 50%다.
/model과 폴백은 프롬프트 캐시를 깨뜨린다. 긴 세션 중간 전환은 비싸다.- 평범한 대화가 성립하기 전에 게이트웨이와 폴백을 얹지 않는다.
「청구서는 provider 이름이 아니라 auto 슬롯과 캐시 리셋에서 커진다」
적용 시점의 hermes config check와 hermes doctor가 현재 버전 기준이다. 모델 은퇴와 인증 조건은 릴리스마다 바뀐다.
출처와 링크
- Hermes Agent Quickstart: https://hermes-agent.nousresearch.com/docs/getting-started/quickstart
- Hermes Agent AI Providers: https://hermes-agent.nousresearch.com/docs/user-guide/ai-providers
- Hermes Agent Configuration: https://hermes-agent.nousresearch.com/docs/user-guide/configuration
- Hermes Agent Configuring Models: https://hermes-agent.nousresearch.com/docs/user-guide/configuring-models
- Hermes Agent Fallback Providers: https://hermes-agent.nousresearch.com/docs/user-guide/fallback-providers
- Hermes Agent Context Compression and Caching: https://hermes-agent.nousresearch.com/docs/user-guide/context-compression-and-caching
조사 기준: 2026년 8월. 설정 키와 기본값, provider 목록, 모델 은퇴 여부는 릴리스마다 바뀔 수 있다.