바이브코딩
Jev ai 가 뭐길래 이리 난리일까? | TypeSafe 개발 어디에 어떻게 쓰며 단점 한계는?
뭔지 → 추가 설명 → 사용 예시 → 한계. 생성은 LLM, 판단은 Jev
TypeSafe는 2026년 9월 System One 모델 클래스와 플래그십 Jev를 공개했다. Jev는 LLM이 아니다. 자연어 state를 읽고 Choice, Score, Noul 같은 typed 결정과 확률을 돌려, 소프트웨어 if와 라우팅에 바로 붙이는 판단 전용 모델이다. ChatGPT, Claude처럼 답장, 코드, 설명을 토큰 스트림으로 쓰지 않고, 미리 정한 스키마에 맞춰 「이 중 뭐야」「어느 정도야」「맞아?」만 찍는다.
조사 기준일은 2026년 9월 19일(Asia/Seoul)이다. 가격, 컨텍스트, 입력 형태, jaggedness는 docs.typesafe.ai를 정본으로 쓴다. OpenRouter의 typesafe/jev-1.13은 호스팅 목록이며 원 제작사는 TypeSafe다. 홈의 193.6배, 444.6배 속도와 비용 주장, YouTube 대본의 20~200배, 40~400배, 결정당 비용 숫자는 공식 Models 표와 분리해 읽는다.
핵심 포인트: 정리, 작성, 요약은 LLM, 갈래, 게이트, 후보는 Jev, 합계, 날짜, 환율은 코드. 마케팅 배수와 영상 데모 실측은 docs 가격표와 섞지 않는다.
바로가기: TypeSafe 홈 / OpenRouter typesafe/jev-1.13 / System One 문서
Jev는 뭔지: 글을 안 쓰는 판단 AI
핵심 포인트 — 뭔지
한 줄: Jev는 글을 쓰지 않는 AI 판단기다. 「이 중 뭐야」(Choice), 「어느 정도야」(Score), 「맞아?」(Noul)처럼 코드가 바로 if로 쓸 답과 확률만 돌려준다.
TypeSafe의 판단 전용 모델이다. ChatGPT처럼 글을 쓰지 않고, 소프트웨어 if에 붙일 답과 확률만 준다.
한 줄 흐름
자료나 LLM 초안을 넣는다 → Jev가 확률로 갈래·통과·확신만 찍는다 → 코드가 LLM(작성·요약)·자동·사람 중 어디로 보낼지 정한다. 정리·작성은 LLM, 판단은 Jev.
이럴 때 잘 맞는다 (닫힌 선택·게이트·라우팅)
- A냐 B냐: 환불 vs 교환, 승인 vs 반려, 낮 vs 밤 톤
- 셋 이상 갈래: 티켓을 환불 / 재예약 / 안내로 나누기
- 후보 고르기: 제목·훅·이미지 프롬프트 N개 중 통과 top-k
- 온도계: 화남·긴급도·관련성을 Score로 재고, 임계값 넘기면 사람 큐
- 예/아니오 게이트: 「스팸이냐」, 「환불 요청이냐」, 「이 문장이 출처를 지지하냐」(Noul)
- 게임·시뮬: NPC가 싸울까/도망갈까, 퀘스트 A/B 분기, 난이도 상향 여부처럼 상태만 보고 다음 행동 고르기
- 에이전트 앞단: 도구 호출 전에 의도·위험만 빠르게 가르기
이럴 때 안 쓴다 (자세한 한계는 후반)
답장·대본·코드 생성, 합계·날짜 계산, 이미지 픽셀 판정. 긴 전략 설명이나 「최선 경로를 짜 줘」 같은 뭉뚱그린 질문도 비권장이다.
ChatGPT·Claude처럼 대화하거나 답장·코드를 생성하는 모델이 아니다. 입력(이메일 본문, 티켓, 후보 목록 같은 state)을 넣고, 미리 정해 둔 출력 스키마에 맞춰 확률 있는 결정만 받는다. TypeSafe docs는 이를 System One이라 부르며, 이름 유래는 대니얼 카너먼 Thinking, Fast and Slow의 System 1(빠르고 직관적인 판단)이다. 홈 서술은 RLCD(Reinforcement Learning for Calibrated Decisions)를 내세운다.
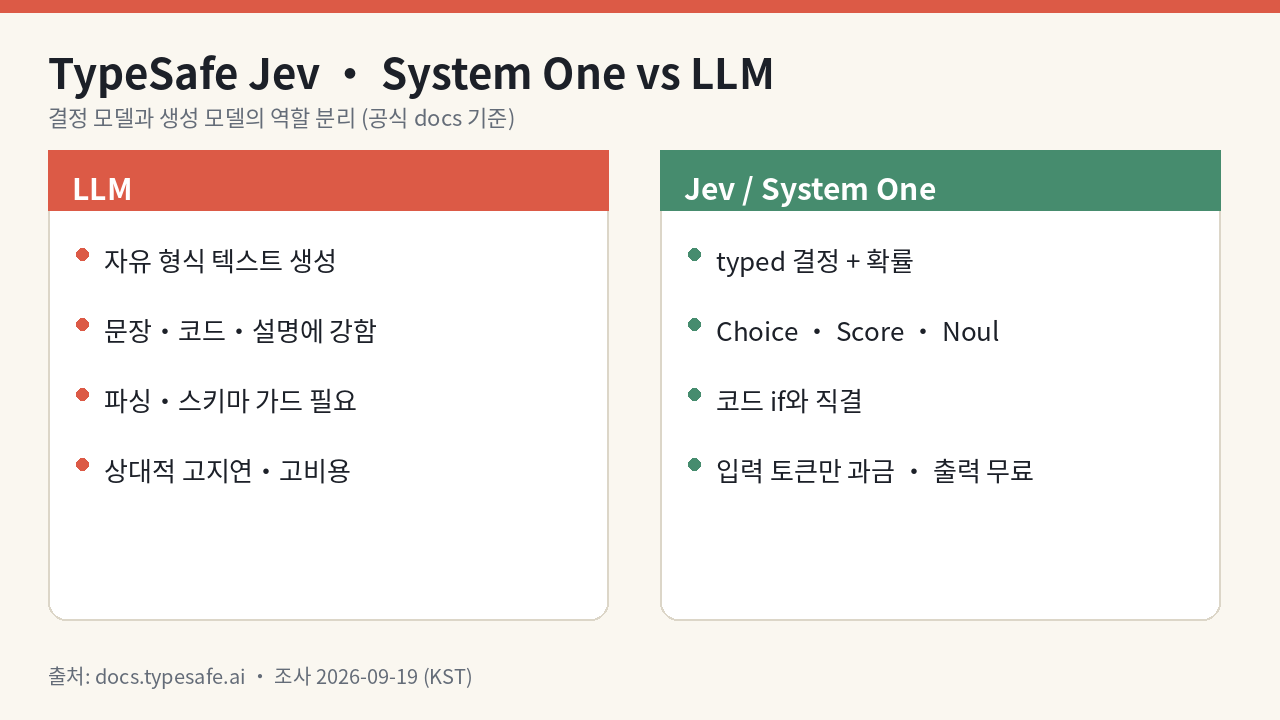
소프트웨어를 「if 결정의 연속」으로 보면 Jev의 자리가 분명해진다. 분류·라우팅·점수·랭킹·가드레일처럼 닫힌 갈래가 핵심인 자리에는 맞고, 문장·이메일·코드·단계적 추론 설명을 써야 하는 자리에는 맞지 않는다. 후자는 generative LLM(또는 사람)이 맡고, Jev는 그 앞이나 뒤에서 갈래만 가른다.
청구서 사기 같은 예시를 영상들이 자주 든다. LLM은 문장 토큰을 이어 붙여 「이 청구서는…」를 쓰고, Jev는 fraud/clean/review 같은 닫힌 갈래와 확률만 찍는다(대본 그래픽 수치·시간은 제품 벤치가 아니다).
어떻게 동작하나: Choice·Score·Noul과 스펙
누가 만들었나. Diogo Almeida(@CompleteSkeptic)는 TypeSafe AI 창업자·CEO다. 본인 소개와 출시 영상 자막 기준으로 OpenAI에서 ChatGPT·RLHF 계열 작업에 참여한 뒤, 약 2년간 스텔스로 RLCD(Reinforcement Learning for Calibrated Decisions)와 System One 계열 결정 모델 Jev를 만들었다고 밝혔다. 조사일 기준 X 팔로워는 약 11만 명대다.
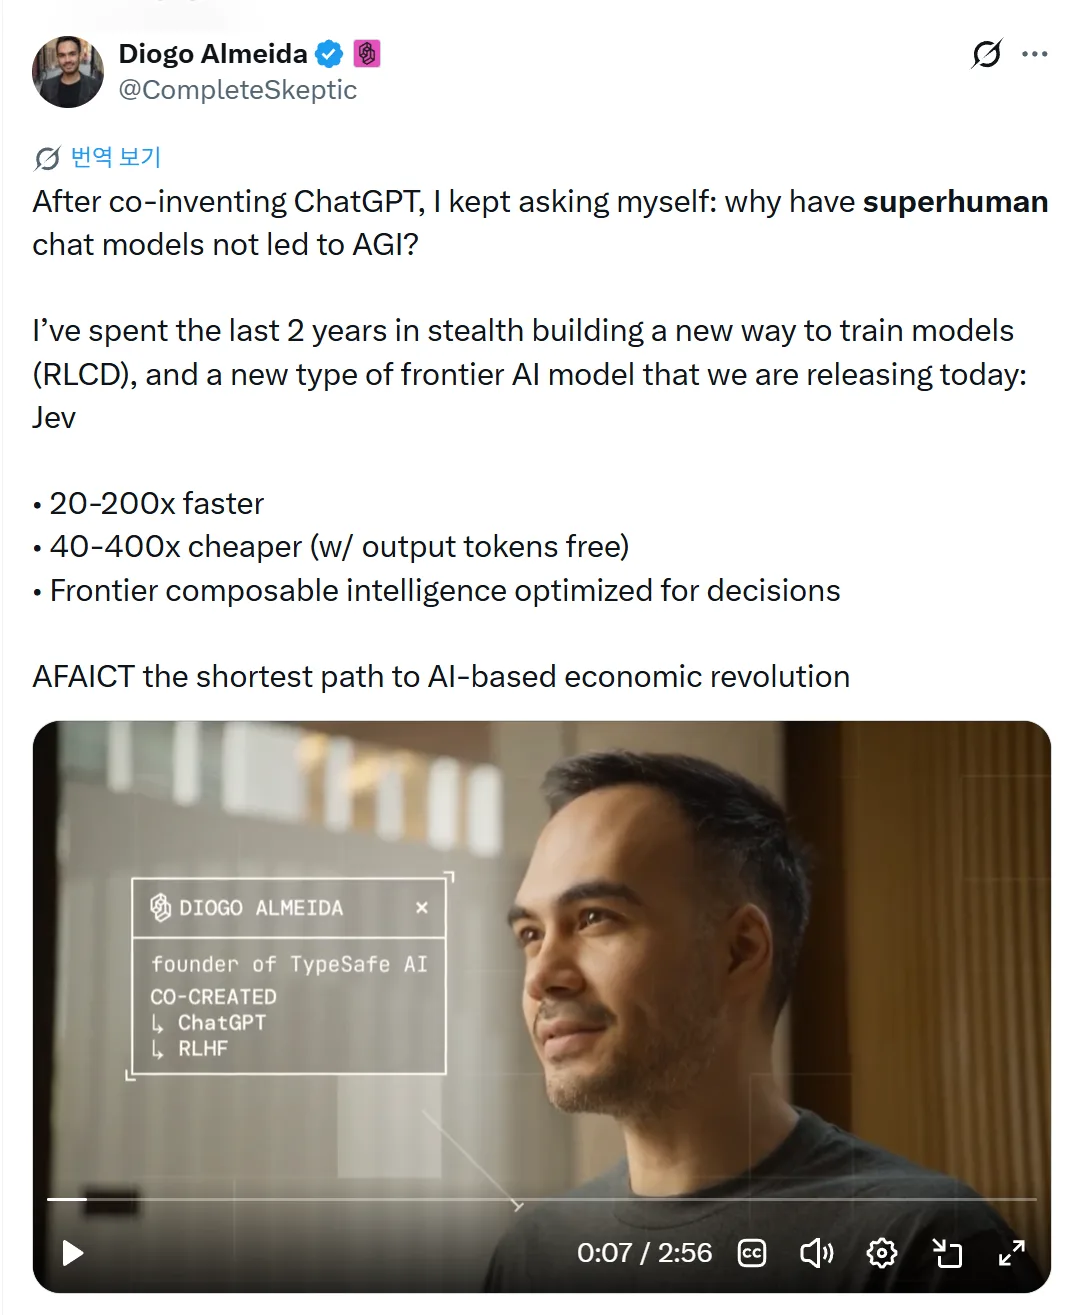
출시 포스트(2026-09-15)에서는 「초인적 채팅 모델이 왜 AGI로 이어지지 않았는가」라는 질문에서 출발했다고 적는다. Jev를 결정에 최적화된 frontier composable intelligence로 소개하고, 20~200배 빠르고 40~400배 싸다, 출력 토큰은 무료라고 적는다. 이 배수·혁명 프레이밍은 출시 마케팅이다. 제품 가격·한도의 정본은 아래 공식 Models 표와 docs다.
X 영상은 사이트에서 YouTube처럼 iframe으로 붙지 않아, 위 스크린샷과 원문 링크로 둔다. 영상 길이는 약 2분 56초다.
System One은 state를 평가하고 typed answers와 probabilities를 반환한다. 캘리브레이션은 예측 집단에 대해 최적화되며, 개별 답이 항상 맞다는 보장은 없다. docs는 「지식이 있는 사람이 1초 만에 내릴 판단」을 좋은 질문으로 두고, 「분석해서 최선 경로를 정해 달라」 같은 뭉뚱그린 질문을 피하라고 한다. 복합 판단은 원자 질문으로 쪼갠 뒤 코드에서 가중한다.
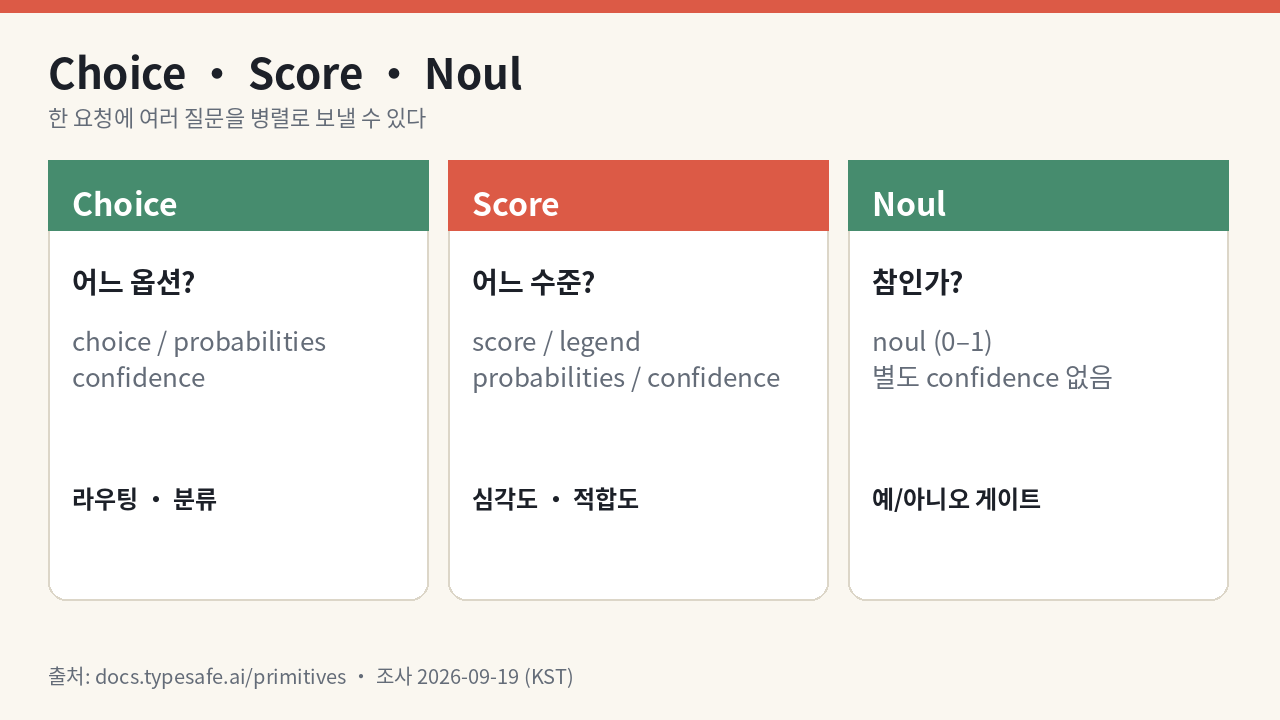
| 타입 | 묻는 것 | 반환 | 코드에서 쓰기 |
|---|---|---|---|
| Choice | 어느 옵션인가 | choice, probabilities, confidence | 라우팅·분류 분기 |
| Score | 어느 수준인가 | score, legend, probabilities, confidence | 임계값·가중 합 |
| Noul | 참인가 | noul 0~1 (별도 confidence 없음) | if·게이트 |
같은 state에 질문을 여러 개 보내면 병렬 평가된다. 질문 토큰만 추가로 들고, 한 요청에 Choice, Score, Noul을 섞을 수 있다. 「항상 세 개를 동시에」라는 영상 단순화와 달리, 공식은 필요한 질문만 여러 개 보내라고 한다. Noul에는 별도 confidence 필드가 없으므로, 임계값은 noul 값 자체로 잡는다. Choice의 yes 확률과 Noul을 동일시하지 말라고 jaggedness도 경고한다.
공식 스펙 (조사일 기준)
| 항목 | 값 | 출처 |
|---|---|---|
| 플래그십 | Jev (System One 첫 모델) | docs Models |
| ID | jev-1.13.0 (별칭 jev-latest, jev-preview → 조사일 기준 동일) | docs |
| 가격 | 입력 $0.042/Mtok ($42/Btok), 출력 무료 | docs |
| Rate limits | 250,000 tok/s, 1,200 rpm (dynamic) | docs |
| 컨텍스트 | 요청 합계 64k, state+최장 질문 32k | docs |
| 입력 | 텍스트만(string/JSON/array). 이미지, 오디오, 비디오 미지원 | docs |
| API | POST /v1/systemone · Python/JS SDK | docs |
| Fine-tune | 고객별 fine-tune 없음. state + instructions/criteria | docs |
| 고객 데이터 | 요청으로 학습하지 않음 | docs |
| 언어 | 영어 주력. CJK는 더 약함(자체 테스트 권고) | docs |
OpenRouter 카드는 조사일 기준 컨텍스트 32K, 가격 $0.042/M in·$0/M out, 출시 Sep 18, 2026, Latency P50 약 0.19~0.20초로 적힌다. docs의 64k/32k와 표기가 어긋날 수 있으니 배포 전 양쪽을 확인한다. 호출은 TypeSafe SDK/HTTP 또는 OpenRouter slug typesafe/jev-1.13, 영상에서 언급된 Vercel AI Gateway 경로도 있다(대본: 약간 비쌀 수 있음).
LLM structured JSON과의 차이
| 축 | LLM + JSON 스키마 | Jev / System One |
|---|---|---|
| 출력 | 자유 텍스트를 파싱·스키마로 강제 | typed decision + probabilities만 |
| 실패 모드 | 형식 이탈, 환각, try/catch | 틀릴 수 있음. confidence/noul로 게이트 |
| 출력 토큰 | 과금·지연에 영향 | 공식 Models: 출력 무료 |
| 목표 | 생성, 설명, 추론 서술 | 빠른 구조화 판단 |
| 소프트웨어 접점 | 파싱·프롬프트 가드 필요 | Choice/Score/Noul이 if와 직결 |
| 생성 | 문장, 코드, 단계적 추론 | 비권장(jaggedness) |
| 입력 | 멀티모달 모델 다수 | text only (아직) |
LLM structured output은 「문장을 쓰되 형식을 맞추라」에 가깝고, Jev는 「형식이 곧 답」이다. 그래서 에이전트 루프에서 try/catch로 JSON을 고치는 비용을 줄이려는 팀이 Jev를 앞단에 둔다. 반대로 답장, 대본, 코드가 필요하면 LLM이 본체이고 Jev는 게이트다.
바이브 코딩·에이전트 패턴
바이브 코딩 에이전트 루프에서는 보통 앞단에 둔다. 도구 호출 전 의도·위험을 가르고, LLM 후보만 남기며, 관련 문단만 짧게 넘긴다. confidence가 높으면 자동, 낮으면 사람이나 더 느린 LLM으로 넘기는 패턴이 docs 권고에 가깝다.
대표 6패턴은 이렇다.
- Router + Writer: 입력 → Jev Choice → 분기 → LLM 생성(의도 라우팅).
- Writer + Judge: LLM 초안/후보 → Jev Score/Choice → 채택, 재작성(제목, 훅 데모).
- Guard then Act: 에이전트 tool 제안 → Jev Noul → 코드 실행/차단.
- Short context: 후보 검색 → Jev 관련성 → 짧은 컨텍스트만 LLM(메모리 축소 데모와 같은 축).
- Fan-out: 한 요청에 질문 다수(카테고리, 스팸, 답장 필요를 동시).
- Confidence gate: 자동 / 사람 / 더 큰 LLM 삼분.
질문 설계 팁을 docs 톤으로 옮기면 이렇다. 「이 메일이 스팸인가?」(Noul), 「어느 팀으로 보낼까? 옵션: A/B/C」(Choice), 「긴급도는? 낮음/보통/긴급」(Score)처럼 한 호흡에 답할 수 있는 원자 질문이 좋다. 「이 케이스를 분석해서 최선의 고객 여정을 설계해 달라」처럼 생성, 기획이 섞인 질문은 System One 자리이 아니다. 같은 state에 스팸 Noul, 카테고리 Choice, 긴급 Score를 한 번에 보내 fan-out하면, 왕복 횟수와 프롬프트 중복을 줄일 수 있다.
홈과 런치 대본의 「can't hallucinate / like code」류 문구는 마케팅이다. 운영에서는 confidence, noul 임계값과 사람 에스컬레이션을 기본값으로 두고, jaggedness에 적힌 산술, 날짜, 생성 금지를 코드 리뷰 체크리스트에 넣는 편이 안전하다.
홈 마케팅은 System One 워크플로 기준 193.6배 빠르고 444.6배 싸다고 적고, 예시로 TypeSafe 쪽 0.114초, 0.000081달러와 LLM 쪽 8.566초, 0.013880달러를 나란히 둔다. 「238x Lower input price than Claude Fable 5.1」 문구도 홈에 있다. 이 배수는 벤치 리포트 전문이 공개된 표가 아니라 홈 proof 문구이므로 제품 정의, 공식 Models 표와 분리한다. 「Zero Hallucinations」는 매 결정에 confidence가 붙는다는 프레이밍이지, 오답 불가가 아니다.
어디에 어떻게 쓰나
아래 영상은 「Jev가 뭔지 / 어디에 붙이면 되는지」를 데모 중심으로 풀어 준다. 이메일 분류, 리드 스코어, 라우팅, 클립 고르기, 브라우저 유즈 같은 쓰는 자리를 먼저 보고, 한계는 다음 장에서 묶는다.
같은 축의 다른 데모 영상이다. 500통 메일 분류, 스캠 Noul, 중요도 Score, 그리고 입력에 따라 nano/균형/프론티어 LLM을 고르는 모델 라우터를 보여 준다. Choice, Score, Noul을 UI에서 추가하며 돌리는 흐름이 「스키마만 정하면 된다」는 감각을 잡기 좋다.
이메일, 인박스, 리드, 라우터 (영상 데모, 라벨 주의)
이메일, 인박스. 메일 객체(제목, 본문, 발신자)를 state로 넣고, 카테고리(Choice), 우선순위(Score 또는 Choice), 스팸 정도(Noul/Score), 답장 필요 여부(Noul)를 한 요청에 여러 질문으로 묻는다. 사용법 영상(4mTLpuQpB80) 화자가 든 데모 주장은 약 1,700통, 입력 토큰 수백만 단위(약 4.2M in / 500k out), 비용 약 0.18달러다. 공식 벤치가 아니라 영상 실측 주장이므로 그대로 제품 스펙으로 인용하지 않는다. o1CogAtWdBk 쪽에서는 500통 분류, 파이 차트, 브랜드딜 Noul, 스캠 Noul, 중요도 Score를 UI에서 붙이는 흐름을 보여 준다. 패턴 자체는 「대량, 반복 분류」에 Jev가 잘 맞는 자리로 읽으면 된다.
리드, 문의 게이트. 웹 문의 폼을 넣고 「좋은 리드인가」를 0~1로 재어, 높은 점수만 사람에게 보내고 애매하면 LLM 초안, 낮은 점수는 무시하는 식이다. 그래픽 디자인 에이전시 인바운드처럼 비싼 사람 시간 앞에 큐를 두는 자리와 맞는다. 다른 대본에서는 700 warm leads 개인화 전환 스코어를 약 40초, 약 0.08달러라고 주장하기도 한다(대본, 실시간 주장).
CS, 이슈 트리아지. 「어느 제품팀으로 보낼까」처럼 닫힌 라우팅. 정보 큐의 앞단에 붙여 트래픽 경찰처럼 쓰는 비유가 영상에도 나온다. 서비스 중개, 견적 라우팅(instant-match) 아이디어도 같은 축이다.
모델 라우터. 요청 내용을 state로 넣고 tiny/nano, balanced/sonnet, frontier처럼 닫힌 모델 목록에서 Choice한다. 답장과 코드는 고른 LLM이 쓰고, Jev는 어느 모델을 쓸지만 결정한다. Sentry Junior류로 「질문 두 개로 라우터」를 짜는 대본 사례도 있다.
크리에이터 파이프라인
크리에이터에게 Jev가 되는 일은 후보 고르기와 게이트다. 제목, 훅, 이미지 프롬프트, 댓글 유형, 문장 유형, 출처 일치 여부다. 안 되는 일은 대본 작성, 이미지 픽셀 판정, 무출처 팩트체크, 「왜 틀렸는지」 설명 생성이다.
프롬프트×대본 파이프. (1) 대본 beat, must_include, must_avoid를 state에 넣는다. (2) LLM이 이미지 프롬프트 후보 N개를 만든다. (3) Jev가 Choice(best_prompt_id) 또는 후보별 Score, Noul(「핵심 소품 포함?」「must_avoid 회피?」)로 top-k만 통과시킨다. (4) 실제 JPG/PNG 생성과 그림 검수는 비전 모델이나 사람이 맡는다. Jev 입력은 텍스트뿐이므로 픽셀을 보지 않는다.
팩트 게이트. 출처 원문을 state에 넣은 뒤에만 의미가 있다. 대본 문장마다 Choice(확정팩트/의견/추정/CTA/미확인) → 확정팩트만 Noul(「이 출처 문단과 충돌 없이 지지되는가?」). 웹 조사·설명 문장은 LLM/도구다. 쇼츠 대본 본문을 Jev에게 쓰라고 시키지 않는다.
인박스·협찬. 유튜브 댓글 Choice(질문/칭찬/스팸/혐오/협업), 협찬 메일 Noul(유료협찬?) + Score(채널 적합), 소재 메모 Choice(이번주촬영/백로그/폐기). 적합↑만 사람 알림으로 보낸다.
클립·제목. 롱폼을 전사한 뒤 순간(moment)을 Score로 매겨 숏폼 후보를 고르는 데모가 사용법 영상에 있다(화자 주장: 17 moments 약 3초대). Moritz 데모3는 LLM이 제목 후보 다수를 만들고 Jev가 score/rank한다(대본: 0.35면 underperformer, 임계값 0.5는 화자 설정).
Driving, 고증. 대본, 캡션, 파일명 텍스트로 게이트한다. 「한국 시설/표지/보도 컷으로 보이는 설명인가?」 같은 Noul은 캡션 기준이며, 최종 KR/해외 확정은 SOURCES와 사람이 한다. 이미지 픽셀 단독 판정은 불가하다.
브라우저 유즈·에이전트 하이브리드 (제한적)
브라우저 유즈. HTML과 클릭 가능 ID를 주고 다음에 누를 ID를 Choice로 고른다. 픽셀을 보는 비전 에이전트가 아니다. 접근성 좋은 마크업에서는 빠르고 싸게 돌아갈 수 있고, Canvas, WebGL, 자유 타이핑은 약하다. 타이핑이 보이면 대개 문자열 세트를 미리 준 것이다. 사용법 영상 항공권(Zurich→London) 픽 데모는 화자 주장 약 7.1초다. Moritz 음성 브라우저는 STT → 페이지 요소 퀴즈 → threshold 코드로 click/navigate/type한다(대본).
에이전트 하이브리드. 도구, 스킬, 리소스 설명이 많을 때 Jev로 지금 프롬프트에 관련 있는 것만 고른 뒤 LLM 컨텍스트에 넣는다. 생성은 LLM, 선별은 Jev다. Claudia memory OS 데모(대본)는 recall 토큰을 2756 vs 13,000, 다른 질문은 293 vs 13,000, 없으면 0 tokens라고 주장한다. 수치는 비공식 실측이지만, 「결정 모델로 컨텍스트 비용을 줄인다」는 패턴 설명으로는 쓸 만하다.
무LLM 툴챗(데모). 날씨, 위키, 단위변환, 스마트홈처럼 닫힌 툴 목록만 Choice하고 문장 생성은 안 하는 챗봇 연출이 있다(대본: 응답 약 200~300ms). 대화, 작성 본체가 필요하면 결국 LLM이 붙는다.
사무, 통계, 무역, PPT
숫자, 합계, 환율, 날짜 비교는 엑셀과 코드만 쓴다. Jev에게 맡기지 않는다(공식 jaggedness).
사무. 수신함 Choice(액션필요/참고/스팸/결재/외부고객), 결재 상신 Noul(필수 첨부, 금액, 기한 문구?) + Score(긴급도), 회의록 문장별 Choice(결정/할일/의견/잡담), 사내 규정은 검색으로 조항 후보를 모은 뒤 Choice, 채용은 JD 충족 Noul/Score(최종 합격은 사람).
통계. 집계는 스프레드시트/코드. 자유응답 라벨은 Choice, 「주장 문장이 표 요약과 지지되나?」는 Noul, 지표 정의 모호도는 Score. p-value, 회귀, 정확한 카운트는 Jev 금지.
무역, 물류. 인코텀즈, 결제조건 Choice(FOB/CIF/DDP 등을 criteria에 고정), BL/인보이스 Noul(필수 필드 누락?) + Choice(문서 종류), HS는 DB 후보 중 Choice(최종 세번, 관세는 관세사/사람), 클레임, 디머리지 Score/Noul, 제재 리스크 메모는 「추가 스크리닝 필요?」 Noul. 금액, 환율, 일자 파싱은 코드. confidence 낮으면 무조건 사람. 한/영 혼용 서류는 샘플 검증이 필수다.
PPT, 제안서. LLM이 슬라이드 초안 → Jev가 Choice(남김/합치기/삭제) + Noul(한 슬라이드 한 메시지?) + 주장×표 요약 지지 Noul + 과장 Score → 사람 디자인. 차트, 레이아웃 생성은 LLM/PPT다.
접근·호출 한 줄
시작은 typesafe.ai 웨이리스트 → 콘솔 API 키, 또는 OpenRouter slug typesafe/jev-1.13, 또는 영상에서 언급된 Vercel AI Gateway다. 요청 한 방은 state(판단 재료)와 questions(Choice, Score, Noul 하나 이상)를 POST /v1/systemone으로 보내고, 응답 확률을 코드 if로 소비한다. 별칭 jev-latest로 따라가거나 jev-1.13.0으로 고정한다. 고객별 fine-tune은 없고, 형태는 state와 instructions/criteria로 잡는다. 요청 데이터로 모델을 학습하지 않는다고 docs에 적혀 있다.
실무에서는 임계값을 코드에 둔다. noul 0.85 이상만 자동, 0.5~0.85는 사람 큐, 미만은 무시처럼 구간을 나누면 「틀린 답」을 제품 사고로 키우지 않기 쉽다. Choice confidence가 낮을 때도 같은 식으로 에스컬레이션한다. Score는 스펙트럼 위치와 legend를 같이 보고, 「정확한 수치 보간」이 아니라 「어느 구간에 있나」로 쓴다.
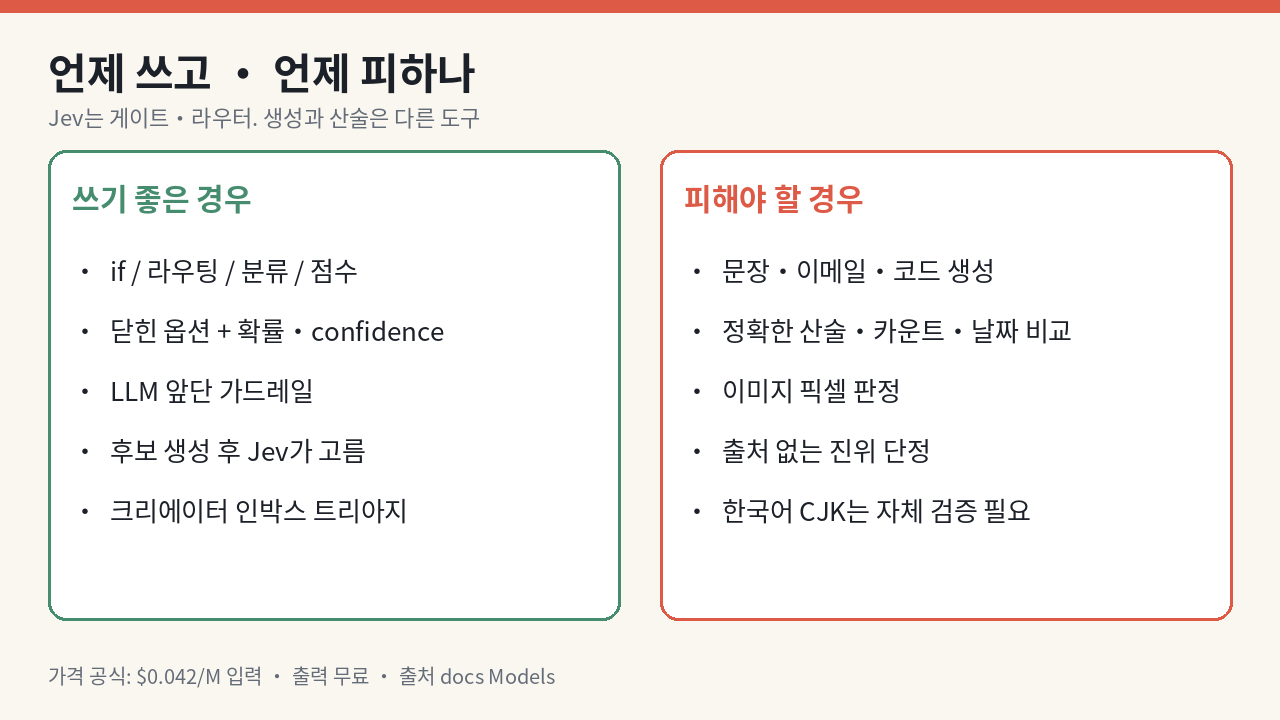
CS, 세일즈, 마케팅, 커머스, 핀테크, 보험, HR, 법무 행정, 의료 행정, 교육, 부동산, 제조 QC, 물류, 보안, DevOps, 연구, 뉴스룸, 민원, 스마트홈, 게임처럼 라우터/온도계/게이트/후보심사/주장검증/실시간 루프/팬아웃이 반복되는 분야에 같은 뼈대를 이식할 수 있다. 진단, 법률 결론, 지급 승인, 산술, 무근거 진위, 픽셀 단독, 안전 루프 단독은 금지에 가깝다.
단점·한계와 헷갈리기 쉬운 데모
한계는 공식 jaggedness와, 바이럴 데모를 까는 정리 영상, 사용법 영상 안의 주의가 겹친다. 초반에 겁주기보다, 뭔지·쓸 자리를 본 뒤 여기서 선을 긋는 편이 맞다.
가짜·과장 데모 표 (영상 정리)
| 겉으로 보이는 말 | 실제로는 | 한계 |
|---|---|---|
| UI, 도형을 「설계」 | 카드, 버튼, 원, 파란 사각형 등 미리 정한 액션 중 선택 | 정밀 위치, 크기, 색, 구성 불가 |
| Doom, 자율주행, 테슬라 FSD | 픽셀 입력 없음. 내부 state + 컨트롤러 버튼 | FSD, 비전 에이전트 아님 |
| DB 전 행 NL 필터 | 행마다 Jev 호출 | 소규모 데모용. 프로덕션급 행 수는 비용·지연 |
| Instant compaction | 줄 keep/discard | 실제 compaction은 요약이지 줄 발췌가 아님 |
| Jev 챗봇 | 도구, 단어 슬롯 고르기 | 대화, 작성 본체는 LLM |
| 그리기·생성형 UI | 유한 옵션 하드코딩 후 Choice | 자유 생성 아님 |
| Command-K 자동완성 | 닫힌 후보 집합 | 실용 가능(유한 집합일 때) |
| 실시간 트레이딩 buy/sell | 유한 Choice | HFT·만능 시세 AI 아님. 화자도 회의적 |
| Subway Surfers, Flappy, 드론 시뮬 | 짧은 state 루프 + 행동 Choice | 실차, 실기 비행 ≠ 데모 |
| Wikipedia 6 degrees·스마트홈 mock | playground/대본 수치 | 제품 벤치 표 아님 |
많은 바이럴 데모는 유한 옵션을 하드코딩한 뒤 Jev가 고르게 한 연출이다. UI 생성, 픽셀 기반 자율주행, 전 행 DB 분류처럼 보이는 것은 모델 능력 과장이 많다. 유한 Command-K, 이메일 태그, HTML ID Choice처럼 닫힌 집합이면 실용 축에 가깝다.
공식 jaggedness (reviewed 2026-09-17)
공식 jaggedness는 다음을 실패 모드로 적는다.
- 문자 그대로 읽기(의도·뉘앙스보다 표면)
- 산술, 카운트(합계, 개수는 코드)
- 날짜 비교(코드/라이브러리)
- 다단 indirection(지시가 여러 겹으로 꺾일 때)
- 무관한 대형 state(잡음 많은 통째 투입)
- 적대 입력
- 모순 criteria
- 구조 불변식 미보장(Noul과 Choice yes 확률이 어긋나거나, 명제와 부정 noul 합이 1이 아닌 예)
- 생성(문장, 코드, 설명)
홈의 Zero Hallucinations는 confidence가 붙는 프레이밍이지 오답 불가가 아니다. docs는 캘리브레이션이 집단 예측에 대해 최적화된다고 하면서도 개별 답 보장을 부인한다.
마케팅 ≠ docs, 시세·언어
같은 계열 데모 영상(o1CogAtWdBk)의 출시 배수(20~200배, 40~400배)와 「결정당 0.00004달러」「약 0.4초 vs LLM 약 10초, 0.03달러」류 숫자는 홈, 화자 벤치 프레이밍이다. 공식 Models 표(입력 $0.042/M, 출력 무료)와 섞지 않는다. 옵션 트리를 준 오토파일럿, buy/sell/hold 트레이더 데모도 유한 Choice이지 비전 FSD나 만능 시세 AI가 아니다.
사용법 영상에서도 Bitcoin buy/hold/sell 같은 시세·포트폴리오 단독 판단은 약하다고 스스로 선을 긋는다. 뉴스까지 교차하는 대형 LLM과 사과 대 사과 비교가 아니라고 말한다. Score로 정확한 수치를 보간하지 말라고도 docs에 가깝게 읽힌다.
한국어·CJK는 docs가 약하다고 적으므로, 샘플로 임계값을 맞추기 전에는 자동 실행 비율을 낮춘다. OpenRouter 32K vs docs 64k/32k 표기 차이도 배포 전 재확인한다.
현실적인 「가짜가 아닌」 자리만 다시 고르면, 이메일, 티켓 태그, 닫힌 Command-K 후보, HTML 접근성 트리 위 클릭 ID Choice, LLM 후보 top-k, 에이전트 도구, 스킬 선별, 모델 라우터다. 그리기, 생성형 UI, 픽셀 FSD, 전 행 DB, 줄 단위 compaction, 시세 단독, 자유 챗봇은 연출이거나 약하다. Cloudflare 확률적 플로우 문법처럼 「흥미로운 아이디어」로만 남는 것도 있다(정리 영상 화자 프레이밍).
이럴 때 안 쓴다. 답장, 대본, 코드 생성, 합계, 날짜 계산, 이미지 픽셀 판정, 법률, 의료, 지급 승인 최종 결정, 무출처 진위만 묻는 조사 대체, 프로덕션급 전 행 DB NL 필터, 자유 UI/도형 설계.
마무리
앞에서 다룬 TypeSafe Jev의 핵심만 짧게 정리한다.
- Jev는 TypeSafe System One 플래그십이다. LLM이 아니라 typed 결정 모델이다.
- Choice, Score, Noul이 코드 분기와 직결된다. 한 요청에 질문 다수를 병렬로 보낼 수 있다.
- 쓸 자리: 메일, 리드, CS 라우팅, 후보 고르기, 에이전트 도구 선별, 크리에이터, 사무, 무역 게이트, (제한적) HTML 브라우저 유즈.
- 공식 가격은 입력 $0.042/M, 출력 무료. 컨텍스트는 docs 기준 64k/32k.
- 한계는 후반에 모았다. 유한 옵션 연출 데모, 비전 불가, 전 행 DB, 시세 단독, 생성 비권장, CJK 약함.
- 홈 배수와 영상 데모 수치는 마케팅·대본으로 분리하고, jaggedness와 CJK 고지를 같이 읽는다.
- LLM structured JSON과 달리 「형식이 곧 답」이므로 try/catch 파싱 비용을 줄이는 앞단에 잘 맞는다.
「생성은 LLM, 판단은 Jev, 숫자는 코드」 한국어 파이프는 샘플로 임계값을 맞춘 뒤에야 자동 비율을 올린다.
출처와 링크
- X | Diogo Almeida Jev 출시 - TypeSafe 창업자 발표·RLCD·마케팅 배수 조사 기준 2026년 9월 19일(Asia/Seoul).
- System One 개념 - Jev 정의, LLM과의 차이
- Models - 가격, 컨텍스트, 별칭, 언어, rate limits
- Primitives - Choice, Score, Noul
- Jev 1.13 jaggedness - 한계 (reviewed 2026-09-17)
- TypeSafe 홈 - 제품 홈·마케팅 배수
- OpenRouter typesafe/jev-1.13 - 호스팅 목록
- Docs hub llms.txt - 문서 인덱스
- YouTube | Jev is HERE. How to use it - 사용 예시, 데모 (메일, 리드, 클립, 브라우저)
- YouTube | Jev tools + what to know - 메일 500, Noul/Choice/Score, 모델 라우터 (배수, 시세는 마케팅/데모)
- YouTube | viral Jev demos that are fake - 가짜 데모·한계 정리
- YouTube Moritz | AI Systems, Jev tutorial (Nq_lu5QT-fI, 2026-09-17) - 대본 클레임만 (브라우저, 메모리, 제목 스코어)
FAQ
자주 묻는 질문
Jev는 LLM인가요?
아닙니다. TypeSafe docs는 Jev를 System One 플래그십으로 두고, 생성된 텍스트가 아니라 typed 결정과 확률을 반환한다고 적습니다. 답장과 코드, 추론 설명 생성은 하지 않는다고 명시합니다. 정리와 작성은 LLM, 판단은 Jev로 나누는 하이브리드가 기본입니다.
Jev를 만든 사람은 누구인가요?
TypeSafe AI 창업자 Diogo Almeida(@CompleteSkeptic)입니다. OpenAI에서 ChatGPT·RLHF 관련 작업에 참여했다고 밝히며, RLCD와 결정 모델 Jev를 공개했습니다. 출시 발표: https://x.com/CompleteSkeptic/status/2099925682726002904
가격은 얼마인가요?
공식 Models 기준 입력은 백만 토큰당 0.042달러(10억 토큰당 42달러)이고 출력 토큰은 무료입니다. OpenRouter 목록도 조사일 기준 같은 입력과 출력 무료 표기를 보여 줍니다. 홈과 영상의 배수, 결정당 비용은 Models 표와 섞지 마세요.
Choice와 Noul 중 무엇을 쓰나요?
닫힌 옵션 중 하나를 고르면 Choice, 예/아니오 확률 자체가 신호면 Noul입니다. Score는 스펙트럼 수준에 씁니다. docs는 코드가 바로 분기할 수 있는 형태를 고르라고 합니다. Noul에는 별도 confidence 필드가 없습니다.
어디에 붙이면 제일 잘 맞나요?
메일, 문의, 티켓처럼 반복되는 닫힌 분류와 라우팅, 후보 N개 중 top-k, 에이전트 도구와 스킬 선별 뒤 LLM 작성입니다. 작성과 요약은 LLM, 판단은 Jev로 나누는 하이브리드가 기본 패턴입니다. 사용 예시 영상: https://www.youtube.com/watch?v=4mTLpuQpB80
모델 라우터에도 쓸 수 있나요?
가능합니다. 요청 내용을 state로 넣고 tiny/balanced/frontier처럼 닫힌 모델 목록에서 Choice하면 됩니다. 답장과 코드는 고른 LLM이 쓰고, Jev는 어느 모델을 쓸지만 결정합니다. 참고: https://www.youtube.com/watch?v=o1CogAtWdBk
한국어 분류에 바로 써도 되나요?
docs는 영어가 주 언어이고 CJK는 더 약하다고 적습니다. 한국어 워크로드는 자신 데이터로 테스트하고 confidence와 noul 임계값을 맞춘 뒤에 자동 실행 비율을 올리는 편이 안전합니다. 샘플 없이 전면 자동은 권하지 않습니다.
바이럴 Jev 데모는 믿어도 되나요?
많은 데모는 유한 옵션을 하드코딩한 뒤 Jev가 고르게 한 연출입니다. UI 생성, 픽셀 기반 자율주행, 전 행 DB 분류처럼 보이는 것은 모델 능력 과장이 많습니다. 한계 정리 영상: https://www.youtube.com/watch?v=Spn-F83ZHH0
이미지 썸네일 적합성도 Jev가 보나요?
Jev 입력은 텍스트만입니다. 이미지 프롬프트 후보를 고르는 데는 쓸 수 있지만, 생성된 JPG/PNG 픽셀을 보고 판정하지는 않습니다. 그림 검수는 비전 모델이나 사람이 맡습니다.
OpenRouter로 쓰면 원 제작사가 바뀌나요?
아닙니다. OpenRouter slug typesafe/jev-1.13은 호스팅과 중개 경로입니다. System One과 Jev의 원 제작사는 TypeSafe이고 official_url도 docs.typesafe.ai를 씁니다. 컨텍스트 표기(32K vs docs 64k/32k)는 배포 전 양쪽을 확인하세요.
산술이나 날짜 비교, 시세 매매를 맡겨도 되나요?
jaggedness 문서는 산술과 카운트, 날짜 비교를 코드에 두라고 합니다. 사용법 영상에서도 Bitcoin buy/hold/sell 같은 시세 단독 판단은 약하다고 선을 긋습니다. Score로 정확한 수치를 보간하지 말라고도 적혀 있습니다.
LLM JSON 스키마 출력과 뭐가 다른가요?
LLM structured output은 문장을 생성한 뒤 형식을 맞추는 쪽에 가깝고, 형식 이탈과 환각에 try/catch가 필요합니다. Jev는 Choice, Score, Noul만 반환해 코드 if에 바로 붙입니다. 출력 토큰은 공식 Models 기준 무료입니다.
크리에이터, 무역, PPT에도 쓰나요?
후보 고르기와 게이트에 씁니다. 제목, 훅, 프롬프트 top-k, 출처 일치 Noul, 인코텀즈와 문서종류 Choice, 슬라이드 유지/삭제와 과장 Score 같은 자리입니다. 대본과 슬라이드 문장 생성, 합계와 환율, 관세 최종은 LLM과 엑셀과 사람이 맡습니다.
용어
관련 용어
TypeSafe의 System One 플래그십. 문장 대신 Choice/Score/Noul typed 결정과 확률을 돌려 소프트웨어 if에 붙인다. 홈 https://typesafe.ai/ / OpenRouter https://openrouter.ai/typesafe/jev-1.13
프롬프트 엔지니어링 시스템 프롬프트AI 모델의 행동, 역할, 제약 조건, 출력 형식을 설정하는 초기 지시문으로, 사용자의 개별 메시지(user prompt)와 구분되어 전체 대화 세션에 걸쳐 영향을 미친다. 비유하면, 시스템 프롬프트는 '대화가 시작되기 전에 AI에게 주는 비밀 브리핑(briefing)'이다. 바이브 코딩에서 시스템 프롬프트는 AI의 코딩 스타일을 결정하는 핵심 요소로, '당신은 시니어 TypeScript 개발자입니다. strict mode를 사용하고, 모든 타입을 명시적으로 선언하세요. any 타입 사용을 금지합니다.'처럼 역할과 제약을 설정하면, 이후 모든 코드 생성에 이 규칙이 적용된다. Cursor의 .cursorrules, Claude Code의 CLAUDE.md, Windsurf의 .windsurfrules 등 프로젝트별 규칙 파일은 사실상 해당 도구에 특화된 시스템 프롬프트이다. API를 직접 사용할 때는 system 역할의 메시지로 전달하며, 사용자 메시지보다 우선순위가 높지만, 프롬프트 인젝션 공격에 의해 우회될 수 있으므로 보안에 주의해야 한다.
백엔드·인프라 서버리스서버 인프라의 관리(프로비저닝, 스케일링, 패치, 모니터링)를 클라우드 제공자에게 완전히 위임하고, 개발자는 함수 단위의 비즈니스 로직만 작성하는 클라우드 실행 모델이다. '서버가 없다'는 의미가 아니라 '서버를 신경 쓸 필요가 없다'는 뜻이며, 사용한 만큼만 비용을 지불하는(pay-per-execution) 과금 방식이 특징이다. 바이브 코딩과의 궁합이 뛰어난 이유: AI가 백엔드 코드를 생성할 때 서버 설정, 스케일링 로직, 인프라 코드까지 생성할 필요 없이 순수한 비즈니스 로직만 작성하면 되므로, 프롬프트의 복잡도가 크게 줄어든다. Vercel Serverless Functions, AWS Lambda, Google Cloud Functions, Cloudflare Workers 등이 대표적이며, v0나 Bolt.new에서 만든 앱을 원클릭 배포할 때 내부적으로 서버리스 인프라가 사용된다. 다만, cold start(첫 실행 시 지연), 실행 시간 제한, 상태 관리의 어려움 등의 한계가 있으며, AI가 이러한 제약을 고려하지 않는 코드를 생성하는 경우도 있다.
링크
관련 링크
AI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
VIBE 코딩 보안 테이텀 시큐리티 Threads쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
관련 글
관련 글
Recommended
Ming Image 0.1 Design | OpenRouter 무료 텍스트→이미지 디자인 모델
Ming Image 0.1 Design은 글(텍스트 프롬프트)을 넣으면 디자인용 이미지를 만들어 주는 AI 이미지 생성 모델이다. OpenRouter 슬러그는 inclusionai/ming-image-0.1-design이고, 모델 페이지에 적힌 가격은 Free(무료)다. inclusionAI가 만든 6B 계열이며, 조사 기준일은 2026년 9월 23일(서울)이다.
하는 일은 단순하다. 프롬프트를 보내면 PNG, JPEG, WebP 중 하나로 이미지가 나온다. OpenRouter와 Hugging Face는 공통으로 포스터, UI, 인포그래픽처럼 화면 안 글자가 읽혀야 하는 디자인을 목표로 소개한다. 참조 사진(레퍼런스 이미지)을 넣고 따라 그리게 하는 경로는 이 OpenRouter 카드에는 없다. 프롬프트만 넣는…
AssemblyAI Universal-3.5 Pro | OpenRouter Sync STT와 120…
AssemblyAI의 Universal-3.5 Pro는 짧은 오디오를 한 번의 HTTP 왕복으로 받아 전사하는 플래그십 음성-텍스트 모델이다. 제품 이름은 Sync Speech-to-Text API와 묶여 있고, 폴링이나 WebSocket 세션을 열지 않는다. OpenRouter는 같은 모델을 assemblyai/universal-3-5-pro 슬러그로 2026년 9월 22일에 올렸다. 조사 기준일은 2026년 9월 23일 Asia/Seoul이다.
공식 Sync 제품 페이지는 시간당 $0.45로 적으며, 초당으로 나누면 정가 $0.000125가 된다. OpenRouter 카드는 그 정가를 나란히 두고 50% 할인된 $0.000063/초를 실제 청구로 보여 준다. 프롬프트를 붙인 오디오는 OpenR…