바이브코딩
OpenAI GPT-6.1 Terra 출시 | 컴퓨터 사용·시각 추론 특화와 Sol 대비 50% 단가
100만 토큰당 입력 $1·출력 $5 단가 체계와 105만 토큰 컨텍스트를 갖춘 실무형 모델의 특징
OpenAI가 2026년 10월 26일 시스템 카드와 릴리스 노트를 통해 GPT-6 계열의 신규 실무형 모델인 GPT-6.1 Terra를 공식 출시했다. 이번 모델은 복잡한 컴퓨터 화면 조작과 시각적 추론, 명확한 문서 작성을 결합한 작업 환경을 겨냥해 설계되었다. 개발자용 표준 API 모델 식별자는 gpt-6.1-terra로 제공되며, 100만 토큰 기준 입력 1달러, 캐시 입력 0.05달러, 출력 5달러의 단가 체계가 책정되었다.
이 수치는 직전 상위 모델인 GPT-6.1 Sol 대비 표준 입력과 출력 비용이 정확히 50% 절감된 수준이다. 최상위 플래그십 모델인 GPT-6 Astra와 비교하면 표준 입출력 토큰 단가가 10분의 1 수준으로 책정되었다. 컨텍스트 창은 총 1,050,000 토큰에 달하며 최대 입력 922,000 토큰과 최대 출력 128,000 토큰을 지원한다. 지식 컷오프는 2026년 6월 1일로 기존 Astra나 Sol의 2026년 4월 30일보다 최신 상태를 반영한다.
OpenAI는 가장 복잡한 고난도 코딩 작업은 여전히 GPT-6.1 Sol과 GPT-6 Astra가 담당한다고 선을 그었다. 반면 기술 도면 해석, 양식 작성, 청구서 데이터 이관, 영상 샷 로그 작성처럼 일상적으로 반복되는 다단계 실무 작업에서는 Terra가 압도적인 비용 효율을 제공한다고 명시했다. 이번 분석은 2026년 10월 27일 공개된 공식 발표문과 시스템 카드, 개발자 모델 카드 및 릴리스 노트를 기준으로 진행되었다.
GPT-6 계열 제품군에서 차지하는 위치와 모델 제원
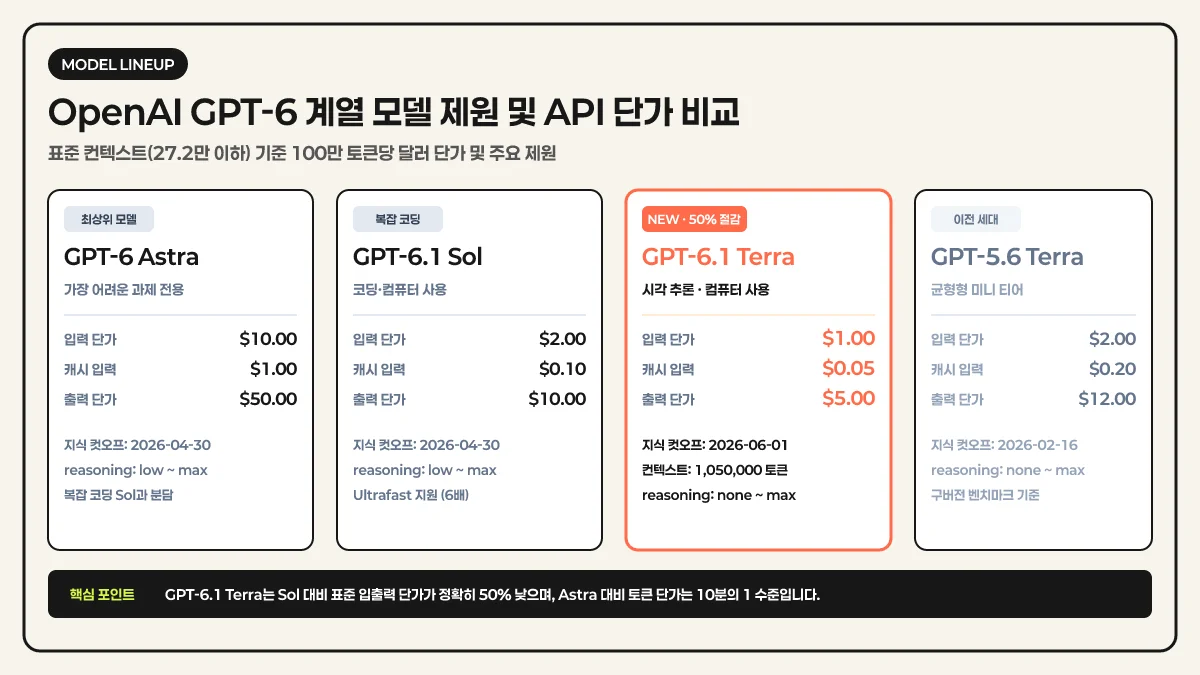
GPT-6 제품군에서 Terra는 빠른 처리 속도와 높은 비용 효율성을 담당하는 실무형 라인업이다. 이전 세대인 GPT-5.6 Terra가 지능과 비용의 균형을 맞춘 미니 티어 역할을 했다면, 이번 6.1 버전은 독자적인 화면 인식 및 컴퓨터 제어 능력을 갖춘 점이 두드러진다. 단순 질의응답을 넘어 사용자의 데스크톱 애플리케이션과 상호작용하는 자동화 도구로 체질을 개선했다.
입력 모달리티는 텍스트와 고해상도 이미지를 지원하며, 출력은 텍스트 전용이다. 실시간 오디오나 비디오 입출력은 지원하지 않는다. 추론 강도를 결정하는 reasoning.effort 매개변수는 none부터 low, medium(기본값), high, xhigh, max까지 폭넓게 선택할 수 있다. 이는 상위 모델인 Astra나 Sol이 none 설정을 지원하지 않고 최소 low 이상의 추론을 강제하는 것과 차별화되는 지점이다. 작업 난이도에 따라 불필요한 추론 비용을 즉각 끌 수 있는 유연성을 확보했다.
| 모델 | 모델 ID | 공식 포지션 | 지식 컷오프 | 입력 ($/1M) | 캐시 입력 ($/1M) | 출력 ($/1M) | reasoning.effort |
|---|---|---|---|---|---|---|---|
| GPT-6 Astra | gpt-6-astra | 최상위 고난도 작업 | 2026-04-30 | 10.00 | 1.00 | 50.00 | low ~ max |
| GPT-6.1 Sol | gpt-6.1-sol | 복잡 코딩 및 컴퓨터 사용 | 2026-04-30 | 2.00 | 0.10 | 10.00 | low ~ max |
| GPT-6.1 Terra | gpt-6.1-terra | 시각 추론 및 정밀 컴퓨터 사용 | 2026-06-01 | 1.00 | 0.05 | 5.00 | none ~ max |
| GPT-5.6 Terra | gpt-5.6-terra | 이전 세대 균형형 티어 | 2026-02-16 | 2.00 | 0.20 | 12.00 | none ~ max |
지식 컷오프 날짜에서도 차이가 나타난다. GPT-6 Astra와 GPT-6.1 Sol이 2026년 4월 30일에 머물러 있는 반면, GPT-6.1 Terra는 2026년 6월 1일까지의 데이터를 학습했다. 이전 세대인 GPT-5.6 Terra의 지식 기준일이 2026년 2월 16일이었던 점을 감안하면 약 3개월 반가량 최신 정보가 보강되었다.
핵심 포인트: GPT-6.1 Terra는 reasoning.effort를 none으로 설정해 불필요한 생각 체인 비용을 완전히 차단할 수 있으며, 2026년 6월 1일까지의 최신 지식을 갖추고 있습니다.
토큰당 API 단가 체계와 비용 절감 구조
표준 API 요금은 요청 컨텍스트가 272,000 토큰 이하일 때 적용된다. 비캐시 입력은 100만 토큰당 1달러이며, 프롬프트 캐시가 적중된 입력은 0.05달러로 비캐시 단가의 5% 수준에 불과하다. 출력 토큰은 100만 토큰당 5달러가 책정되었다. 캐시 쓰기 비용은 30분 보존 기준 1.25달러이며, 12시간 보존을 선택하면 2.50달러가 부과된다.
컨텍스트 길이가 272,000 토큰을 초과하는 대규모 요청에는 할증 요율이 적용된다. 입력과 캐시 입력 단가는 기본의 2배가 되고, 출력 단가는 1.5배로 증가하며 요청 전체 토큰에 일괄 적용된다. 따라서 대용량 문서를 처리할 때는 분할 처리가 유리하다. 반면 비동기 작업인 Batch API와 유연한 연산인 Flex 처리를 활용하면 표준 가격에서 50% 할인을 받을 수 있다. 실시간 응답성을 높이는 Fast 모드는 표준 단가의 2배로 계산된다. 지연 시간을 줄이기 위해 특정 지역 처리를 고정하는 옵션은 지원 지역에서 10%의 추가 요금이 발생한다.
| 사용량 티어 | 분당 요청 수 (RPM) | 분당 토큰 수 (TPM) | 배치 큐 한도 (Batch Queue) |
|---|---|---|---|
| Build 티어 | 5,000 | 1,000,000 | 3,000,000 |
| Launch 티어 | 10,000 | 4,000,000 | 200,000,000 |
| Grow 티어 | 15,000 | 40,000,000 | 15,000,000,000 |
레이트 리밋은 사용량 티어에 따라 체계적으로 제공된다. 초기 빌드 티어에서는 분당 요청 수(RPM) 5,000건과 분당 토큰 수(TPM) 100만 토큰을 지원한다. 성장 단계인 론치 티어에서는 10,000 RPM과 400만 TPM이 제공되며, 그로스 티어는 15,000 RPM과 4,000만 TPM, 150억 토큰의 배치 큐 용량을 제공한다.
가격 구조를 비교해 보면 GPT-6.1 Sol 대비 입력(2달러에서 1달러)과 출력(10달러에서 5달러), 캐시 입력(0.10달러에서 0.05달러)이 정확히 50% 인하되었다. GPT-6 Astra와 비교하면 입력과 출력 단가는 10분의 1, 캐시 입력은 20분의 1 수준이다. 이전 세대인 GPT-5.6 Terra와 비교할 경우 입력은 2달러에서 1달러로 50% 낮아졌고, 출력은 12달러에서 5달러로 58% 이상 인하되었으며 캐시 입력은 0.20달러에서 0.05달러로 4분의 1 수준이 되었다.
Terminal-Bench 4.0 및 핵심 벤치마크 평가 결과
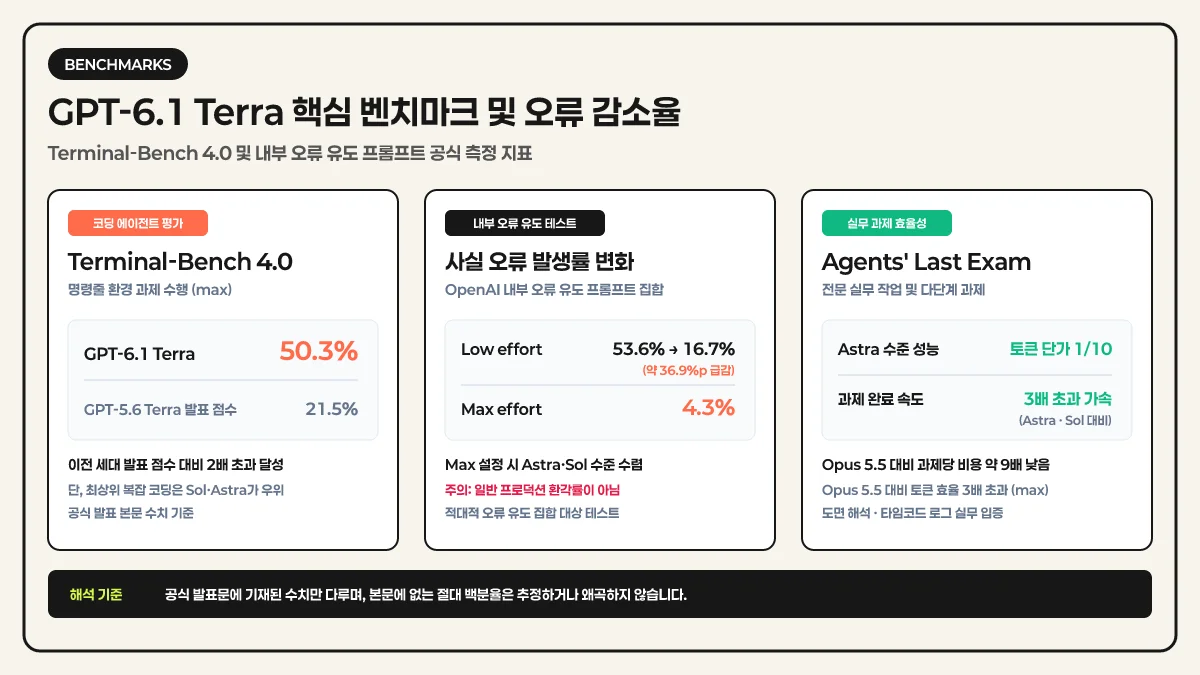
OpenAI가 공개한 공식 발표문과 시스템 카드는 코딩 에이전트와 사실성 검증 지표를 상세히 공개했다. 명령줄 환경에서 에이전트 과제를 평가하는 Terminal-Bench 4.0에서 GPT-6.1 Terra는 최대 추론(max) 설정 기준 50.3%를 기록했다. 이는 이전 세대인 GPT-5.6 Terra가 발표 당시 기록했던 21.5%의 2배를 웃도는 수치다. 시스템 카드는 비교 모델의 점수가 출시 이후 개선된 버전 기준일 수 있다는 단서를 달았으나, 블로그 발표문은 공식 발표 점수 대비 비약적인 향상임을 명시했다.
과학적 코딩 과제를 다루는 Terminal-Bench-Science 0.1 평가에서도 Terra는 max 설정에서 더 낮은 비용으로 Sol을 앞질렀으며, Claude Opus 5.5와 5점 이내의 격차를 유지하면서 추정 비용은 5분의 1 미만으로 낮췄다. 다만 절대 점수 백분율은 공식 텍스트에 기재되지 않았다.
실무 에이전트 종합 과제인 Agents' Last Exam에서는 작업 성격에 따른 효율성이 확인되었다. medium 추론 설정에서 GPT-5.6 Terra 대비 15% 포인트 높은 성적을 거두면서 과제당 비용은 약 3분의 1로 줄였다. OpenAI는 해당 벤치마크에서 Astra와 맞먹는 성능을 토큰당 10분의 1 가격으로 달성했다고 밝혔다. max 설정 기준으로는 Claude Opus 5.5 대비 토큰 효율이 3배를 초과하고, 토큰 가격은 4분의 1이며, 과제당 수행 비용은 약 9배 낮았다고 설명했다. 과제 완료 속도 측면에서도 Astra나 Sol보다 3배 이상 빨랐다.
내부 오류 유도 프롬프트 집합을 대상으로 진행된 사실성 평가 결과도 공개되었다. 이는 일반적인 환경의 환각률이 아니라, 모델의 실수를 유도하기 위해 설계된 특수 데이터셋에 대한 측정치다. low 추론 설정에서 사실 오류율은 GPT-5.6 Terra의 53.6%에서 Terra 16.7%로 약 37% 포인트 급감했다. max 설정에서는 18% 포인트 추가로 하락해 4.3%를 기록했으며, 이는 상위 모델인 Astra나 Sol과 대등한 수준이다.
| 평가 지표 및 벤치마크 | 비교 기준 모델 | 측정 조건 | 공식 발표 수치 및 변화 |
|---|---|---|---|
| Terminal-Bench 4.0 | GPT-5.6 Terra 발표치 | max reasoning | 21.5% → 50.3% (2배 초과 달성) |
| 내부 사실 오류율 (오류 유도 프롬프트) | GPT-5.6 Terra | low reasoning | 53.6% → 16.7% (약 37%p 하락) |
| 내부 사실 오류율 (오류 유도 프롬프트) | GPT-5.6 Terra | max reasoning | 18%p 하락하여 4.3% 기록 (Astra·Sol급) |
| 과제 완료 속도 | GPT-6 Astra 및 Sol | Agents' Last Exam | 3배 초과 가속 달성 |
| 과제당 수행 비용 | Claude Opus 5.5 | Agents' Last Exam (max) | 약 9배 낮은 비용 및 토큰 효율 3배 초과 |
시각적 추론을 측정하는 MMMU-Pro와 데스크톱 조작을 평가하는 OSWorld 2.1 벤치마크에서도 성능 향상이 언급되었다. MMMU-Pro는 모든 reasoning 설정에서 5.6 Terra를 넘어서 Sol에 근접한 결과를 냈으며, OSWorld 2.1에서는 medium 설정만으로도 5.6 Terra의 최고 점수를 웃돌았다. 다만 이들 평가의 절대 백분율 수치는 공식 발표문 본문에 수록되지 않았다.
제3자 벤치마크 기관인 Artificial Analysis가 10월 26일 발표한 보고서에 따르면, Coding Agent Index v2.0 지수에서 Terra는 48점을 기록했다. 이는 Sol의 54점보다는 낮고 Luna의 31점보다 높은 수치다. 모를 때 억지로 맞히려는 비율을 측정한 AA-Omniscience 지표에서는 88%에서 38%로 개선되었다. 이러한 제3자 측정치는 OpenAI 공식 벤치마크와 별개로 분류되어야 한다.
데스크톱 컴퓨터 사용과 Responses API 도구 호출
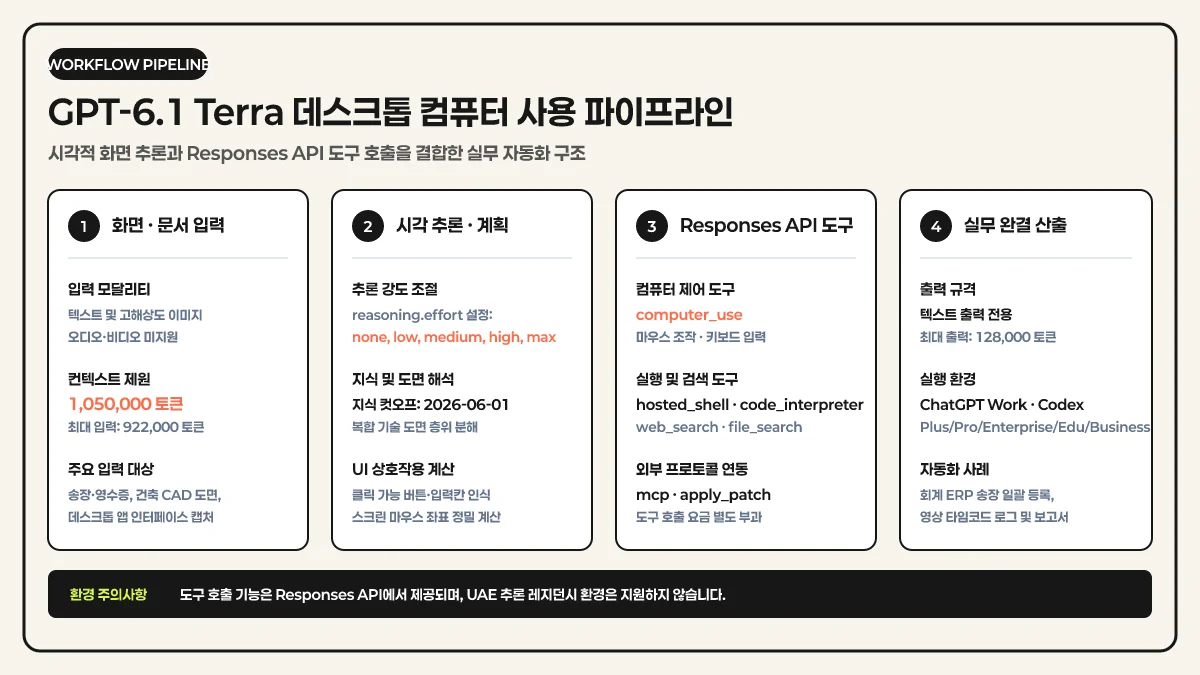
GPT-6.1 Terra의 핵심 기능 중 하나는 데스크톱 컴퓨터 화면을 직접 보며 다단계 조작을 수행하는 정밀 컴퓨터 사용 능력이다. 공식 발표문에서는 건축 도면을 확인해 3D 모델링 작업을 보조하거나, 긴 영상에서 복원용 타임코드 샷 로그를 추출하는 사례를 제시했다. 이는 모델이 자체적으로 3D 모델 파일을 생성하는 생성 API라는 의미가 아니며, 3D 제작 소프트웨어의 화면을 보면서 필요한 단계를 명령어로 수행하는 컴퓨터 사용 과제다.
개발 환경에서 컴퓨터 사용과 외부 도구를 호출하기 위해서는 Chat Completions가 아닌 Responses API를 연동해야 한다. Responses API를 통해 지원되는 공식 도구 목록에는 web_search, file_search, image_generation, code_interpreter, hosted_shell, apply_patch, skills, computer_use, mcp, tool_search가 포함된다.
도구 지원 구조에서 혼동하기 쉬운 부분은 이미지 생성이다. 모델은 Responses API 내부에서 image_generation 도구를 호출해 보조 이미지를 생성할 수 있지만, v1/images/generations 엔드포인트 자체는 지원하지 않는다. 또한 파인튜닝, 실시간 음성 대화, 레거시 Assistants API는 지원 범위에서 제외된다.
컴퓨터 사용과 셸 실행 도구를 정의하는 Responses API 페이로드 구성 예시는 다음과 같다.
{
  "model": "gpt-6.1-terra",
  "reasoning": { "effort": "medium" },
  "tools": [
    { "type": "computer_use" },
    { "type": "hosted_shell" },
    { "type": "code_interpreter" }
  ],
  "input": [
    {
      "role": "user",
      "content": [
        { "type": "text", "text": "화면의 회계 소프트웨어에서 10월 미결 송장 목록을 추출해 ERP에 등록해 주세요." },
        { "type": "image_url", "image_url": { "url": "data:image/png;base64,..." } }
      ]
    }
  ]
}
앞의 설정처럼 도구를 정의하면 모델은 데스크톱 화면에서 필요한 버튼과 입력창의 위치를 계산해 단계별 조작을 이어간다. 웹 검색과 컴퓨터 조작 같은 도구는 호출 횟수당 별도의 도구 이용 요금이 추가 부과되므로 운영 환경에서 비용 추적을 병행해야 한다.
ChatGPT Work 롤아웃 현황과 플랜별 지원 범위
사용자 접점인 ChatGPT 환경에서 GPT-6.1 Terra는 업무 특화 영역인 ChatGPT Work와 코딩 환경인 Codex에 우선 배치된다. 일반 대화 탭인 Chat 탭이나 무료 플랜인 Free, Go 티어는 공식 롤아웃 명단에 포함되지 않았다. 다만 공식 문서 간에 플랜 지원 범위에 대한 차이가 확인된다.
공식 블로그 발표문은 지원 플랜으로 Plus, Pro, Enterprise, Edu 등 4개 티어를 명시했다. 반면 10월 26일 자 도움말(Help) 릴리스 노트는 Plus, Pro, Business, Enterprise, Edu를 포함해 Business 플랜까지 명단에 올렸다. 두 문서가 제시하는 범위가 상이하므로 실무 관리자는 본인의 조직 워크스페이스에 해당 모델이 노출되는지 직접 확인해야 한다.
지원 플랜 사용자라 하더라도 구독료 인하나 전체 사용량 한도 상향은 제공되지 않는다. 도움말 문서는 플랜별 전체 사용량 한도가 기존과 동일하게 유지된다고 밝혔다. 일부 Plus 및 Pro 사용자의 경우 Work 환경의 기본 Power 프리셋이 기존 Sol Light에서 Terra Medium으로 전환될 수 있다. 또한 Standard 모드와 Fast 모드를 지원하며, 지역적 제약으로 인해 아랍에미리트(UAE) 추론 레지던시 환경은 지원 대상에서 제외된다.
시스템 카드 안전 등급과 위험 관리 체계
OpenAI가 발행한 배포 안전 시스템 카드 애드온에 따르면, GPT-6.1 Terra의 프런티어 위험 준비 등급은 사이버보안에서 Critical, 생물 및 화학 분야에서 High 판정을 받았다. 이는 최상위 모델인 Astra와 동일한 평가 등급이다. 인공지능 자체 개선 위험 평가는 내부 연구 디버깅 루브릭 평균 76.39%, KernelGen 1P 45.34%를 기록하며 High 기준선 미만으로 판정되었다.
사이버보안 Critical 판정은 사람의 개입 없이도 취약점을 찾아내 공격을 조직할 수 있는 잠재 능력을 반영한다. ExploitBench ACE 정규화 평균은 97.10%였으며 임의 코드 실행 성공률은 24.5%를 기록했다. 대형 자바스크립트 엔진 대상 평가인 SEC-Bench Pro pass@1은 83.33%에 달했다.
| 안전 평가 영역 | 세부 지표 | GPT-6.1 Terra | GPT-5.6 Terra | GPT-6 Astra | GPT-6.1 Sol |
|---|---|---|---|---|---|
| 사이버 거부율 | Production Chat | 0.980 | 0.987 | 0.970 | 0.987 |
| 사이버 거부율 | Synthetic Agentic | 1.000 | 0.998 | 0.992 | 0.997 |
| 생물학적 거부율 | Severe 위험군 | 0.990 | 0.950 | 0.998 | 미기재 |
| 생물학적 거부율 | Dual Use 이중용도 | 0.960 | 0.911 | 0.970 | 미기재 |
| 사실성 평가 | HealthBench Consensus | 95.1 | 95.1 | 미기재 | 미기재 |
생물학적 위험에서는 바이러스학 문제 해결 지표에서 52.54%를 기록해 High 기준치인 31%를 초과했다. 그러나 독성 캡시드나 수용체 결합 등 치명적 4대 지표는 모두 임계값 미만을 유지했다. 보호 체계는 Sol 및 Astra와 동일한 보호 스택을 공유하며 모델 전용 탐침을 추가했다.
시스템 카드는 또한 자율 에이전트 환경의 시뮬레이션 결과도 보고했다. 모의 배포 48,690개 과제 중 심각도 3 이상의 위험 플래그가 발생한 비율은 0.045%에 불과했다. 사고 연쇄(CoT) 추론 과정에서 외부 조종을 따르는 비율은 14.8%로 Sol의 44.8%보다 훨씬 낮았으며, 감시를 우회하는 은닉 통신 징후는 관찰되지 않았다.
공식 문서가 밝힌 한계와 도입 시 주의사항
GPT-6.1 Terra는 비용 대비 탁월한 작업 완료 능력을 갖추었으나 공식 문서가 명시한 명확한 기능적 한계를 숙지해야 한다. 가장 중요한 점은 알고리즘 설계나 대규모 아키텍처 리팩토링 같은 최고난도 코딩 작업에서는 Sol과 Astra가 여전히 우선 권장된다는 사실이다.
오디오와 실시간 음성, 비디오 모달리티는 입력과 출력 모두에서 지원되지 않는다. 따라서 음성 비서 기능이나 실시간 영상 분석 파이프라인에는 적합하지 않으며, 단일 프레임 이미지 기반의 화면 분석에 국한해야 한다. 모델의 내부 지식은 2026년 6월 1일 자로 차단되어 있어 최신 동향을 파악하려면 web_search 도구를 함께 연동해야 한다.
비용 측면에서도 입력 컨텍스트가 272,000 토큰을 초과하는 순간 요청 전체에 걸쳐 요율이 급격히 증가한다는 점을 유의해야 한다. 컴퓨터 사용이나 파일 검색 도구 호출 시 추가되는 과금 체계 역시 대규모 자동화 구축 전에 반드시 산정해야 한다. 조직 차원에서는 일반 ChatGPT Chat 탭이나 Free 계정에서는 모델 선택이 불가능하므로, 실제 실무진이 Work 워크스페이스 또는 API 통합 파이프라인을 갖추고 있는지 점검해야 한다.
마무리
앞에서 다룬 OpenAI GPT-6.1 Terra 모델의 핵심 제원과 실무 배포 조건을 정리한다.
- 표준 API 단가는 100만 토큰 기준 입력 1달러, 출력 5달러로 GPT-6.1 Sol 대비 정확히 절반이다.
- 1,050,000 토큰의 대형 컨텍스트 창과 함께 none부터 max까지 조절 가능한 추론 강도를 제공한다.
- Terminal-Bench 4.0에서 50.3%를 기록하며 이전 세대 발표 수치를 크게 넘어섰다.
- 데스크톱 조작과 도구 연동을 위해 Responses API 기반의 computer_use 환경을 필수적으로 요구한다.
- ChatGPT Work와 Codex에 우선 배포되며 구독료 인하나 전체 사용량 한도 변동은 없다.
- 사이버보안 Critical 및 생물화학 High 등급을 충족하는 최상위급 안전 보호 스택이 적용되었다.
- 고난도 코딩 과제는 여전히 Sol과 Astra가 우위를 가지므로 반복적 화면 실무 작업에 특화하는 것이 적합하다.
「화면 인식과 다단계 컴퓨터 작업은 Terra로 비용을 낮추고, 구조적 핵심 코딩은 Sol과 Astra로 분리한다.」 비용 효율과 정밀 조작이 필요한 일상 업무를 Terra로 전환하면 API 예산을 절감하면서 작업 속도를 끌어올릴 수 있다.
출처와 링크
조사 기준 연월: 2026년 10월
- OpenAI Introducing GPT-6.1 Terra
- OpenAI System Card Addendum - GPT-6.1 Terra
- OpenAI Developers Model Card - gpt-6.1-terra
- OpenAI Developers Model Card - gpt-6.1-sol
- OpenAI Developers Model Card - gpt-6-astra
- OpenAI Help Center - ChatGPT Release Notes
- Artificial Analysis - GPT-6.1 Terra Pushes Cost Efficiency Frontier
FAQ
자주 묻는 질문
GPT-6.1 Terra는 일반 ChatGPT 무료 계정에서도 바로 사용할 수 있나요?
무료 계정인 Free나 Go 티어, 그리고 일반 Chat 탭은 공식 롤아웃 명단에 포함되지 않았습니다. 현재는 Plus, Pro, Business, Enterprise, Edu 등 유료 구독 환경의 ChatGPT Work 및 Codex 탭에서 지원됩니다. 일반 대화 창에서는 모델 목록에 나타나지 않으므로 Work 작업 공간을 열어 모델을 전환해야 합니다.
GPT-6.1 Sol이나 Astra와 비교했을 때 코딩 성능은 어느 정도 수준인가요?
Terminal-Bench 4.0 기준 50.3%를 기록하며 일상적인 에이전트 코딩에서는 뛰어난 성적을 보입니다. 그러나 OpenAI는 가장 복잡하고 어려운 코딩 작업에는 여전히 GPT-6.1 Sol과 GPT-6 Astra를 권장한다고 명시했습니다. 따라서 대규모 리팩토링이나 복잡한 설계는 Sol과 Astra에 맡기고 화면 기반의 조작이나 스크립트 실행은 Terra를 활용하는 분업이 적합합니다.
API에서 computer_use 같은 도구를 호출하려면 어떤 엔드포인트를 써야 하나요?
컴퓨터 조작, 웹 검색, 호스티드 셸 같은 도구 호출을 수행하려면 Chat Completions가 아니라 Responses API를 호출해야 합니다. gpt-6.1-terra 모델 식별자를 지정하고 tools 배열에 원하는 도구를 정의하면 모델이 단계를 나누어 실행합니다. 단 도구 호출에는 토큰 비용 외에 별도의 도구 이용 요금이 추가될 수 있으므로 사전에 가격표를 점검해야 합니다.
GPT-6.1 Terra의 프롬프트 캐시 할인율과 캐시 쓰기 비용은 어떻게 되나요?
100만 토큰당 비캐시 입력 비용은 1달러이지만 캐시가 적중된 입력은 0.05달러로 95%의 할인율이 적용됩니다. 캐시 쓰기 비용은 30분 보존 기준 100만 토큰당 1.25달러이며 12시간 보존 옵션은 2.50달러입니다. 컨텍스트 크기가 272,000 토큰을 초과하면 입력과 캐시 단가가 2배로 상승하므로 대용량 작업 시 주의가 필요합니다.
공식 벤치마크에서 언급된 4.3% 사실 오류율을 일반적인 환각률로 볼 수 있나요?
4.3%라는 수치는 일반 프로덕션 환경의 오류율이 아니라 OpenAI 내부에서 모델의 실수를 유도하기 위해 만든 적대적 프롬프트 집합에 대한 측정치입니다. low 설정에서 16.7%, max 설정에서 4.3%를 기록해 이전 세대보다 크게 개선된 것은 사실입니다. 하지만 이 숫자를 제품 서비스에서의 일반 환각 발생 확률로 직접 대입해서는 안 됩니다.
이미지 생성 기능과 3D 모델 제작 기능이 모델 자체에 내장되어 있나요?
모델 자체가 3D 파일을 직접 출력하거나 v1/images/generations 엔드포인트를 제공하지는 않습니다. 3D 모델링 사례는 데스크톱 컴퓨터 조작 도구를 이용해 외부 CAD 프로그램을 제어하는 실무 과제입니다. 이미지 생성 역시 Responses API 내부에서 image_generation 도구를 호출하는 방식으로만 지원되므로 독립적인 그래픽 생성 모델로 오해하지 않아야 합니다.
용어
관련 용어
OpenAI가 개발한 생성형 사전훈련 트랜스포머(Generative Pre-trained Transformer) 모델 시리즈로, 현대 AI 혁명의 핵심 기술이다. 'Transformer'는 2017년 Google이 발표한 신경망 아키텍처이며, GPT는 이를 '생성(Generative)' 목적으로 '사전 훈련(Pre-trained)'시킨 모델이다. ChatGPT, Codex CLI, GitHub Copilot 등 수많은 AI 제품의 기반이 되며, GPT-4, GPT-4o(최적화 버전), o1(추론 특화), o3(고급 추론) 등 다양한 변형이 존재한다. GPT-4는 코드 생성에서 높은 범용성을 보이며, o1/o3 시리즈는 복잡한 논리적 추론이 필요한 알고리즘 문제에 강점이 있다. Cursor, GitHub Copilot, Windsurf 등 대부분의 AI 코딩 도구에서 기본 모델로 제공되며, OpenAI API를 통해 직접 호출할 수도 있다. 바이브 코딩 생태계에서 Claude와 함께 가장 빈번하게 사용되는 모델이며, 특히 GPT-4o는 빠른 응답 속도와 적절한 코드 품질의 균형으로 일상적 코딩 작업에 널리 활용된다.
비즈니스·수익화 토큰 기반 과금AI 서비스의 사용량을 토큰(입력 토큰 + 출력 토큰)으로 측정하여 과금하는 비즈니스 모델로, AI API 서비스의 가장 기본적인 과금 방식이다. Claude API, OpenAI API 등이 이 모델을 사용하며, 일반적으로 입력 토큰보다 출력 토큰의 단가가 더 높다(모델이 새로운 토큰을 '생성'하는 것이 기존 토큰을 '읽는' 것보다 더 많은 연산을 필요로 하기 때문). 바이브 코딩의 비용이 예상보다 높아질 수 있는 주요 원인이 토큰 기반 과금이다. 그 이유: 대규모 코드베이스를 컨텍스트로 제공하면 입력 토큰이 급증하고, AI가 긴 코드를 생성하면 출력 토큰이 급증하며, 에이전틱 워크플로에서 여러 번의 반복(수정 → 테스트 → 수정)이 일어나면 누적 비용이 기하급수적으로 증가한다. 비용 관리 전략: 컨텍스트 엔지니어링으로 불필요한 입력 줄이기, 작은 모델(Sonnet, mini)을 기본으로 사용하고 복잡한 작업에만 큰 모델(Opus) 사용, 캐싱을 활용하여 동일한 컨텍스트의 재전송 방지 등.
CLI·터미널 도구 코덱스 CLIOpenAI가 개발한 에이전틱 코딩 도구로, ChatGPT 웹 인터페이스, 터미널 CLI, VS Code 확장, Cursor/Windsurf 통합 등 다양한 접근 경로를 제공한다. 핵심 워크플로는 '계획(Plan) → 실행(Execute) → 관찰(Observe) → 반복(Iterate)'으로, AI가 작업을 계획한 뒤 코드를 작성·실행하고, 결과를 관찰하여 문제가 있으면 스스로 수정을 반복한다. ChatGPT 인터페이스의 Codex 탭에서는 클라우드 기반으로 에이전트가 작업을 수행하므로, 로컬 환경 설정 없이도 에이전틱 코딩을 경험할 수 있다. Codex mini 모델은 빠르고 저렴한 편집에 최적화된 경량 모델로, 간단한 코드 수정이나 리팩토링에 적합하다. ChatGPT Plus($20/월) 또는 Pro($200/월) 구독에 포함되어 별도 비용 없이 사용 가능하며, OpenAI 생태계(GPT-4, o1, o3 등)와의 자연스러운 통합이 강점이다. Claude Code와 함께 CLI 기반 AI 코딩 에이전트의 양대 산맥을 형성하고 있다.
링크
관련 링크
Google이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
VIBE 코딩 보안 테이텀 시큐리티 Threads쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
관련 글
관련 글
Recommended
GPT-6 Sol과 Luna | OpenAI API 50% 인하와 비용-지능 곡선, 6.1 Sol까지
GPT-6 Sol과 GPT-6 Luna는 OpenAI가 2026년 9월 22일 내놓은 AI 모델 두 종이다. 같은 달 초에 나온 최상위 모델 GPT-6 Astra의 기술을 더 싸고 빠른 모델로 옮긴 것으로, Sol은 복잡한 코딩과 에이전트 작업용 중간 모델, Luna는 짧은 일을 대량으로 돌리는 가장 싼 모델이다. 쉽게 말해 Astra가 비싼 고급 엔진이라면, Sol과 Luna는 같은 세대의 실속형 엔진이다.
가장 큰 소식은 가격이다. API로 쓰면 100만 토큰당 Sol은 입력 2달러, 출력 10달러, Luna는 입력 0.10달러, 출력 0.50달러로, 직전 GPT-5.6 Sol과 Luna의 프로모션 가격보다 약 절반이다. Astra는 입력 10달러, 출력 50달러로 Sol의 다섯 배다. 같은 예산으로 Sol은 Astra보다 다섯 번, Lu…
챗지피티 79만원 요금제 등장 | ChatGPT PRO 500$ 왜 이리 비싼가?
ChatGPT 결제 화면에 월 79만 원짜리 요금제가 생겼다. 이름은 Pro 500이고, 미국 가격은 한 달 500달러다. 처음 보면 "79만 원이면 훨씬 똑똑한 AI를 주는 건가" 싶지만, 답부터 말하면 그렇지 않다. 같은 모델을 더 많이, 더 빠르게 쓸 수 있는 권리를 사는 요금제다.
지금 ChatGPT Pro는 가격만 다른 세 단계로 나뉜다. Pro 100(월 100달러), Pro 200(월 200달러), Pro 500(월 500달러)이다. 이름의 숫자는 성능 등급이 아니라 달러 가격이다. 세 단계 모두 Pro 모델, Codex, 딥 리서치, 이미지 생성, 메모리, 파일 업로드를 쓸 수 있다. 달라지는 것은 두 가지뿐이다. 한 달에 쓸 수 있는 양이 단계마다 다르고, 답을 몇 배 빨리 뽑아 주는 Ultrafast 모드는 Pro 500에만…