바이브코딩
GPT-6 Sol과 Luna | OpenAI API 50% 인하와 비용-지능 곡선
Astra 이후 확장된 GPT-6 Sol·Luna의 API 단가, 캐시, Work·Codex 가용성, OpenAI 공개 벤치마크를 정리한다.
OpenAI는 2026년 9월 초에 GPT-6 플래그십 Astra를 공개한 뒤, 같은 달 후반에 GPT-6 Sol과 GPT-6 Luna를 추가했다. 공식 발표문은 Astra와 비슷한 학습·정렬 방법을 더 빠르고 저렴한 티어에 옮겨, 비용-지능 곡선의 앞쪽을 채우는 모델이라고 적는다. 조사 기준일은 2026년 9월 23일 Asia/Seoul이다. 발표일 표기는 OpenAI 개발자 커뮤니티와 2차 보도 기준으로 2026년 9월 22일이다.
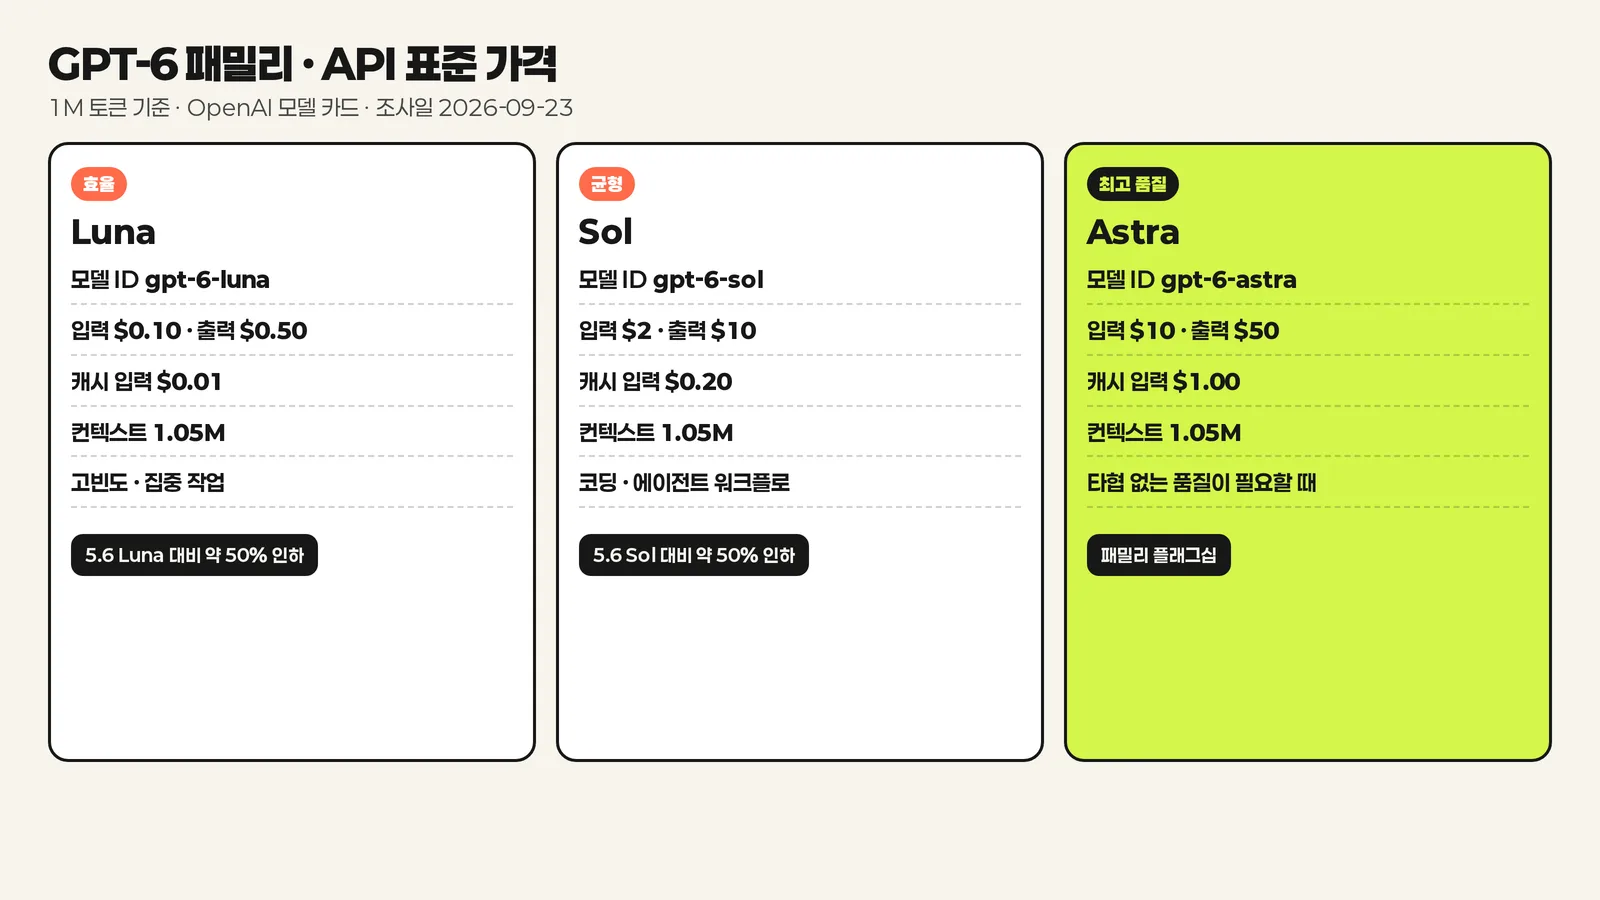
API 표준 가격은 GPT-5.6 시대의 프로모션 가격 대비 Sol·Luna 모두 약 50% 인하됐다. Sol은 입력 $4→$2, 출력 $20→$10(1M 토큰). Luna는 입력 $0.20→$0.10, 출력 $1.20→$0.50이다. Astra는 여전히 “타협 없는 품질”이 필요할 때의 최상위 선택으로 남는다. OpenAI API 모델 카드의 표준 가격은 Astra 입력 $10 / 출력 $50, Sol $2 / $10, Luna $0.10 / $0.50이다.
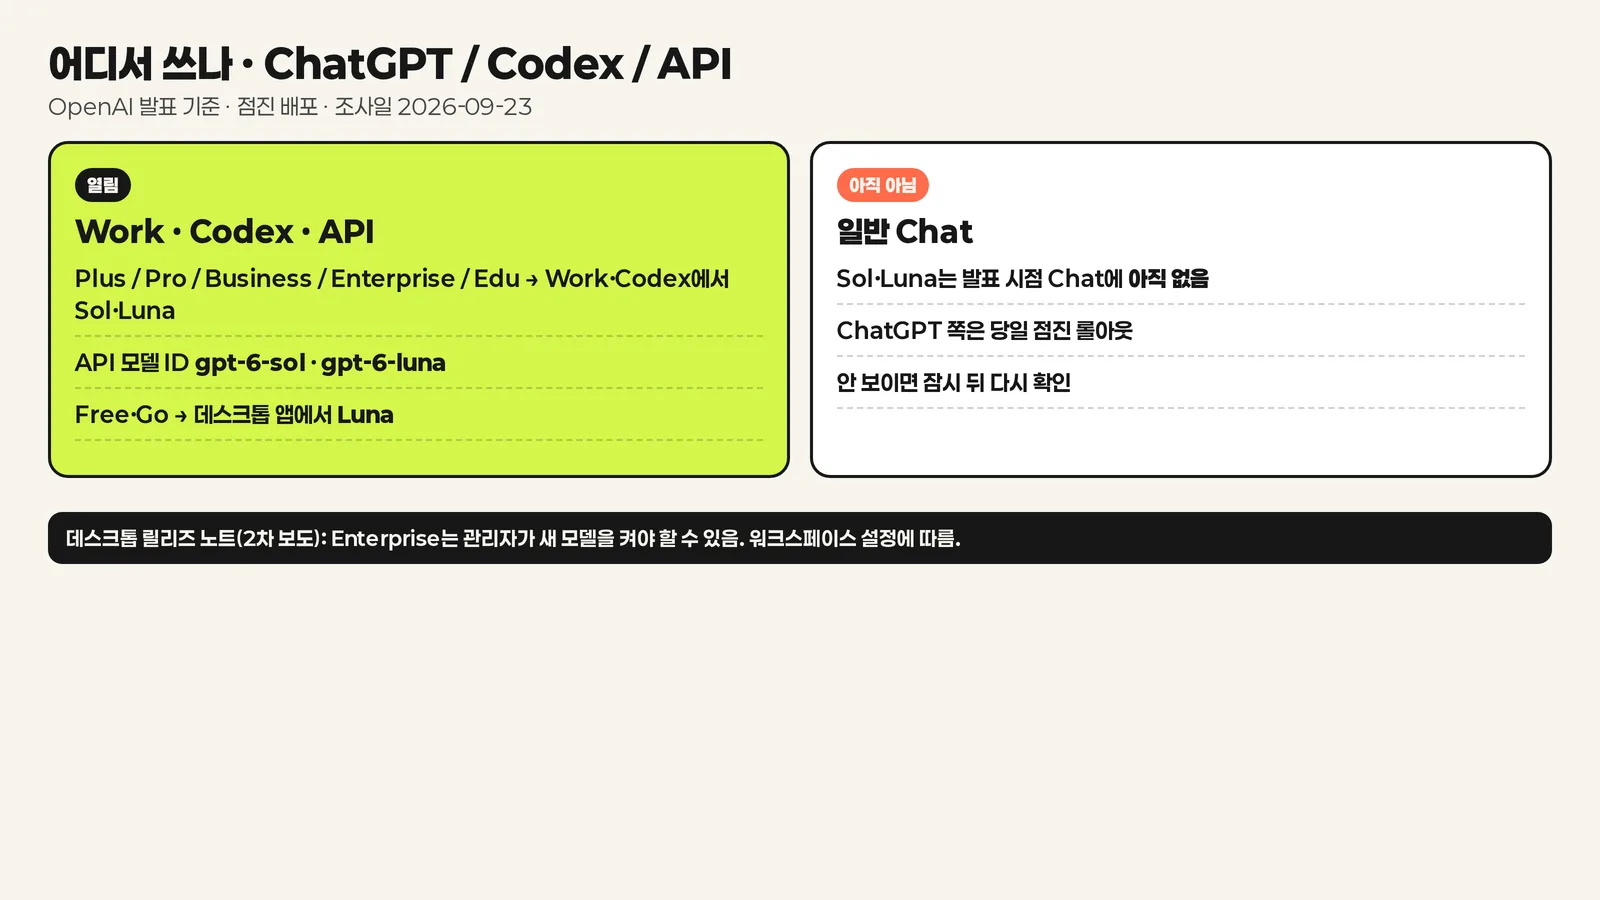
ChatGPT 쪽에서는 Plus, Pro, Business, Enterprise, Edu 사용자가 Work와 Codex에서 Sol과 Luna를 쓰기 시작한다. Free·Go는 데스크톱 앱에서 Luna만 열린다. 발표 시점 기준으로 일반 Chat에는 아직 없다. API 모델 ID는 gpt-6-sol과 gpt-6-luna다. 벤치마크 숫자와 경쟁 모델 비교는 OpenAI 블로그가 공개한 수치이며, 이 글은 그 수치를 다시 측정하지 않고 인용과 해석만 한다.
GPT-6 Sol과 Luna가 Astra와 다른 자리
Astra는 OpenAI가 “가장 지능적이고 정렬된” 모델로 소개한 GPT-6 플래그십이다. Sol과 Luna는 그 세대의 학습 이득을 더 낮은 단가와 더 높은 사용 한도 쪽으로 옮긴다. 공식 문장은 전문 업무, 사실성, 코딩, 컴퓨터 사용, 정렬에서 Astra를 뒷받침한 진전을 더 빠르고 저렴한 모델에 가져왔다고 한다. 같은 발표문은 캐싱·추론 인프라 개선으로 서빙 비용이 줄었고, 그 절감을 API 가격에 반영한다고 적는다.
역할 분리는 모델 카드 한 줄과도 맞는다. Sol은 “복잡한 코딩과 에이전트 워크플로”, Luna는 “집중된 고빈도 작업에 가장 효율적인 모델”로 적혀 있다. Astra는 “가장 어려운 종단 작업”용이다. 바이브 코딩 관점에서는 Codex와 에이전트 루프의 기본 엔진을 Sol에 두고, 짧은 분류, 요약, 대량 호출을 Luna에 두는 식의 분기가 자연스럽다. 품질을 한 단계 더 올려야 할 때만 Astra로 승격하는 구조다. 발표문이 “일상 작업과 대규모 애플리케이션”에 첨단 모델을 실용적으로 만든다고 한 문장도 같은 축을 가리킨다.
핵심 포인트: Sol·Luna는 Astra의 “대체품”이 아니라 같은 세대의 비용 축이다. 발표문은 Astra를 버릴 이유가 없다고 명시한다.
API 가격과 캐시 단가
발표문의 50% 인하는 GPT-5.6 Sol/Luna 프로모션 가격을 기준점으로 잡는다. API 모델 카드는 그 결과 단가를 표준 요금으로 보여 주고, 캐시 입력, 캐시 쓰기, 장문 프롬프트 할증까지 적는다. 둘을 섞어 읽으면 안 된다. 헤드라인 50%는 발표문, 캐시 라인은 모델 카드다. 프로모션이 아닌 다른 시점의 요금표와 비교하면 인하 폭이 달라질 수 있으므로, 계약서·대시보드의 “이전 청구 단가”와 발표문의 기준점을 구분해 적는 편이 안전하다.
| 모델 | 입력 / 1M | 출력 / 1M | 캐시 입력 / 1M | 캐시 쓰기 / 1M |
|---|---|---|---|---|
GPT-6 Luna (gpt-6-luna) | $0.10 | $0.50 | $0.01 | $0.125 |
GPT-6 Sol (gpt-6-sol) | $2.00 | $10.00 | $0.20 | $2.50 |
GPT-6 Astra (gpt-6-astra) | $10.00 | $50.00 | $1.00 | $12.50 |
캐시 입력은 비가시 입력의 10%로 적혀 있어, 발표문이 말하는 캐시 읽기 90% 할인과 맞는다. 캐시 쓰기는 비가시 입력의 1.25배다. 입력 토큰이 272K를 넘는 요청은 입력과 캐시 요금 2배, 출력 1.5배가 요청 전체에 적용된다. Batch와 Flex는 표준의 50%, Fast 모드는 해당 요금의 2배다. 지역 처리 프리미엄 10%와 EU 레지던시 조건은 모델 카드에 별도 고지된다. EU 데이터 레지던시는 Standard 처리에서만 가능하다고 Sol과 Luna·Astra 카드가 공통으로 적는다.
컨텍스트 창은 세 모델 모두 약 1.05M, 최대 출력 128K다. 지식 컷오프는 Sol 2026-04-20, Luna 2026-05-18, Astra 2026-04-30이다. Sol과 Luna의 reasoning.effort는 none, low, medium(기본), high, xhigh, max를 지원한다. Astra 카드는 none 없이 low부터 max까지다. Responses API에서 내장 도구와 함수 호출을 쓰고, Chat Completions에서 함수 호출은 reasoning_effort가 none일 때만 지원된다고 Sol과 Luna 카드에 적혀 있다. 모달리티는 텍스트 입출력과 이미지 입력이며, 오디오, 비디오는 지원하지 않는다고 카드가 적는다.
어떤 모델을 고를지
선택이 갈리는 축은 “한 번의 최고 품질”과 “같은 예산으로 몇 번 돌릴 수 있는지”다. OpenAI는 Astra를 보드 전체 최고로 두고, Sol과 Luna를 비용 효율 축으로 쓴다. 바이브 코딩 루프에서는 반복 횟수가 곧 탐색 폭이다. 단가가 절반이면 같은 예산으로 실패와 수정 사이클을 두 배로 돌릴 여지가 생긴다. 에이전트가 도구를 수십 번 부르는 세션에서는 입력 토큰이 누적되므로, 캐시 적중과 티어 선택이 체감 비용을 동시에 줄인다.
Sol은 긴 리팩터, 멀티파일 패치, 도구를 여러 번 부르는 에이전트에 가깝다. AutomationBench, DeepSWE, OSWorld에서 OpenAI가 내세운 숫자도 Sol 쪽에 무게가 실려 있다. Luna는 같은 패밀리의 저가 티어로, 고 effort에서 사실성과 코딩 일부 구간이 이전 Sol급에 근접한다고 적힌다. 대량 분류, 짧은 코드 조각, 캐시가 잘 맞는 반복 프롬프트에 Luna를 두고 실패만 Sol로 올리는 이단 구성이 발표 논리와 잘 맞는다. 라우터가 없더라도, 사람이 이슈 라벨만 “bulk / merge-critical”로 나눠도 같은 효과를 낼 수 있다.
Astra는 머지 직전 리뷰, 보안과 규정에 민감한 문서, 컴퓨터 사용에서 한 치의 품질도 양보하기 어려울 때다. OSWorld에서도 Astra가 세계 최고 컴퓨터 사용 모델로 남아 있다고 발표문은 명시한다. Sol과 Luna는 그 아래 비용 효율 성능을 채운다. “항상 Astra”는 품질 상한은 높지만, Codex 일일 토큰이 커질수록 예산 상한을 먼저 친다. OpenAI가 내부 연구자 토큰 비용을 예로 든 이유도 그 지점이다.
AutomationBench와 전문 업무 수치
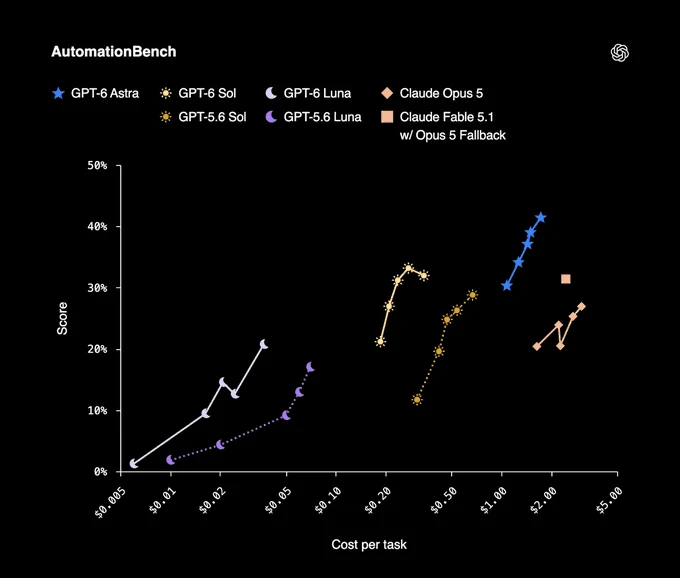
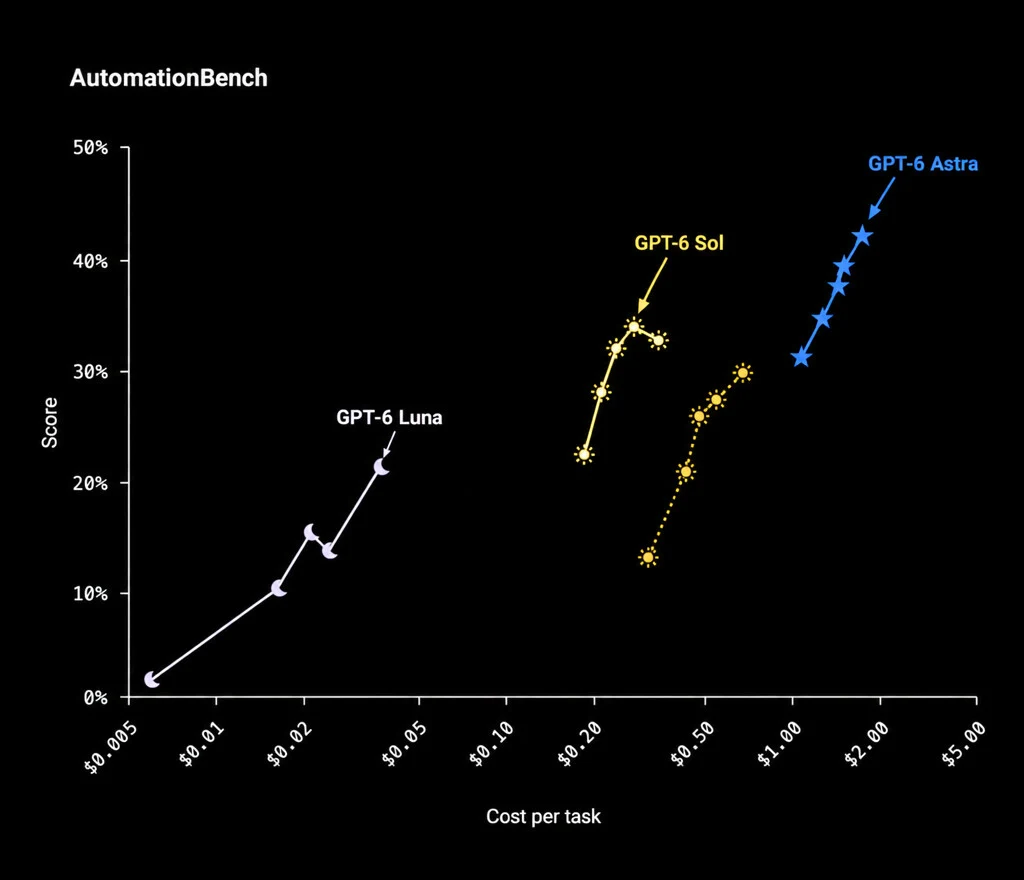
AutomationBench 1.0.6은 영업, 마케팅, 운영, 지원, 재무, HR 등에서 47개 도구를 쓰는 종단 업무 워크플로를 본다. OpenAI 표에 따르면 GPT-6 Sol(xhigh)은 점수 33.2%, 작업당 $0.27이다. 같은 표에서 GPT-6 Astra(low)는 30.3%에 Sol 대비 3.9배 비용, Claude Opus 5(max)는 26.9%에 11.1배, Claude Fable 5.1(Opus fallback, max)은 31.4%에 8.9배 초과다. Fable 5.1 비용은 약 40% 작업에서 발생한 Opus 5 fallback 비용을 빼 실제보다 낮게 잡힌다고 OpenAI가 적어 두었다.
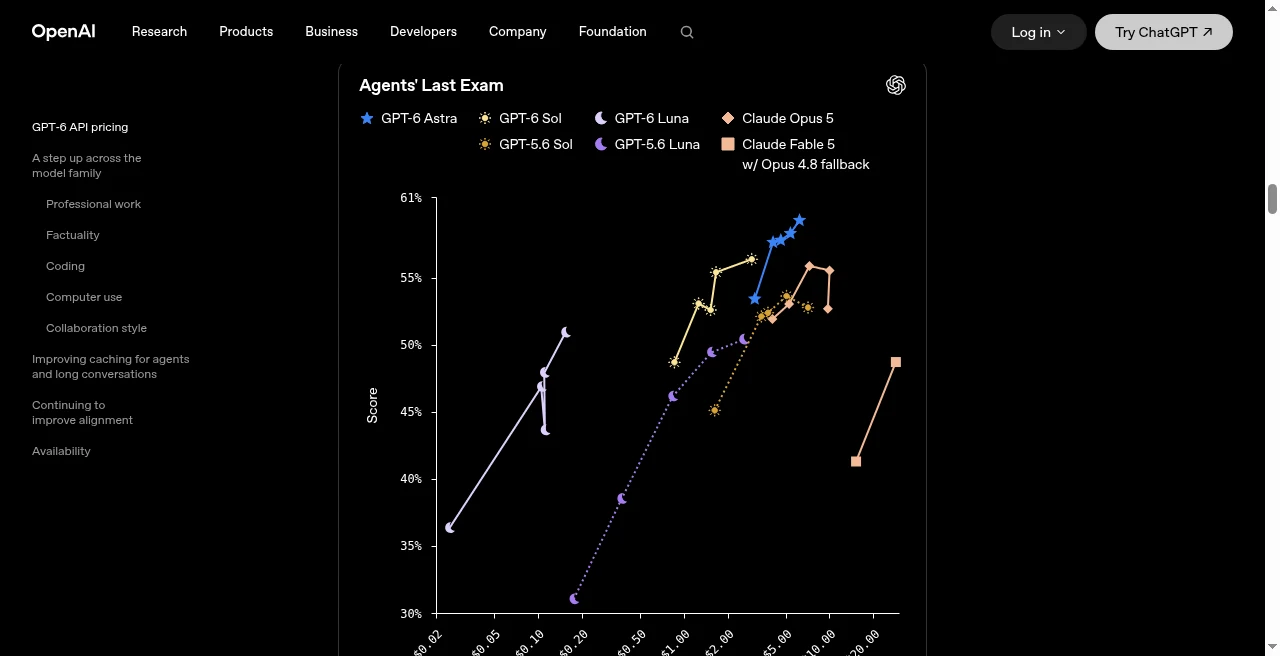
Sol(xhigh)이 Opus 5(max)를 이기면서 Opus 비용의 약 9%만 든다는 문장도 같은 절에 있다. Luna(high)는 이전 세대 대비 5.4%p 향상과 작업당 비용 58% 절감을 주장한다. Agents’ Last Exam V1에서는 Sol(max)이 56.4%로, 평가에서 Opus 5 최고점보다 위에 있으면서 작업당 비용은 60% 낮다고 적는다. 이 시험은 55개 세부 산업에 걸친 장기 전문 업무를 본다. 발표문은 Sol이 비슷한 가격대의 경쟁 모델보다 지능과 결과가 낫다고도 적지만, 그 비교의 구체 표는 AutomationBench·Agents’ Last Exam 쪽에 모여 있다.
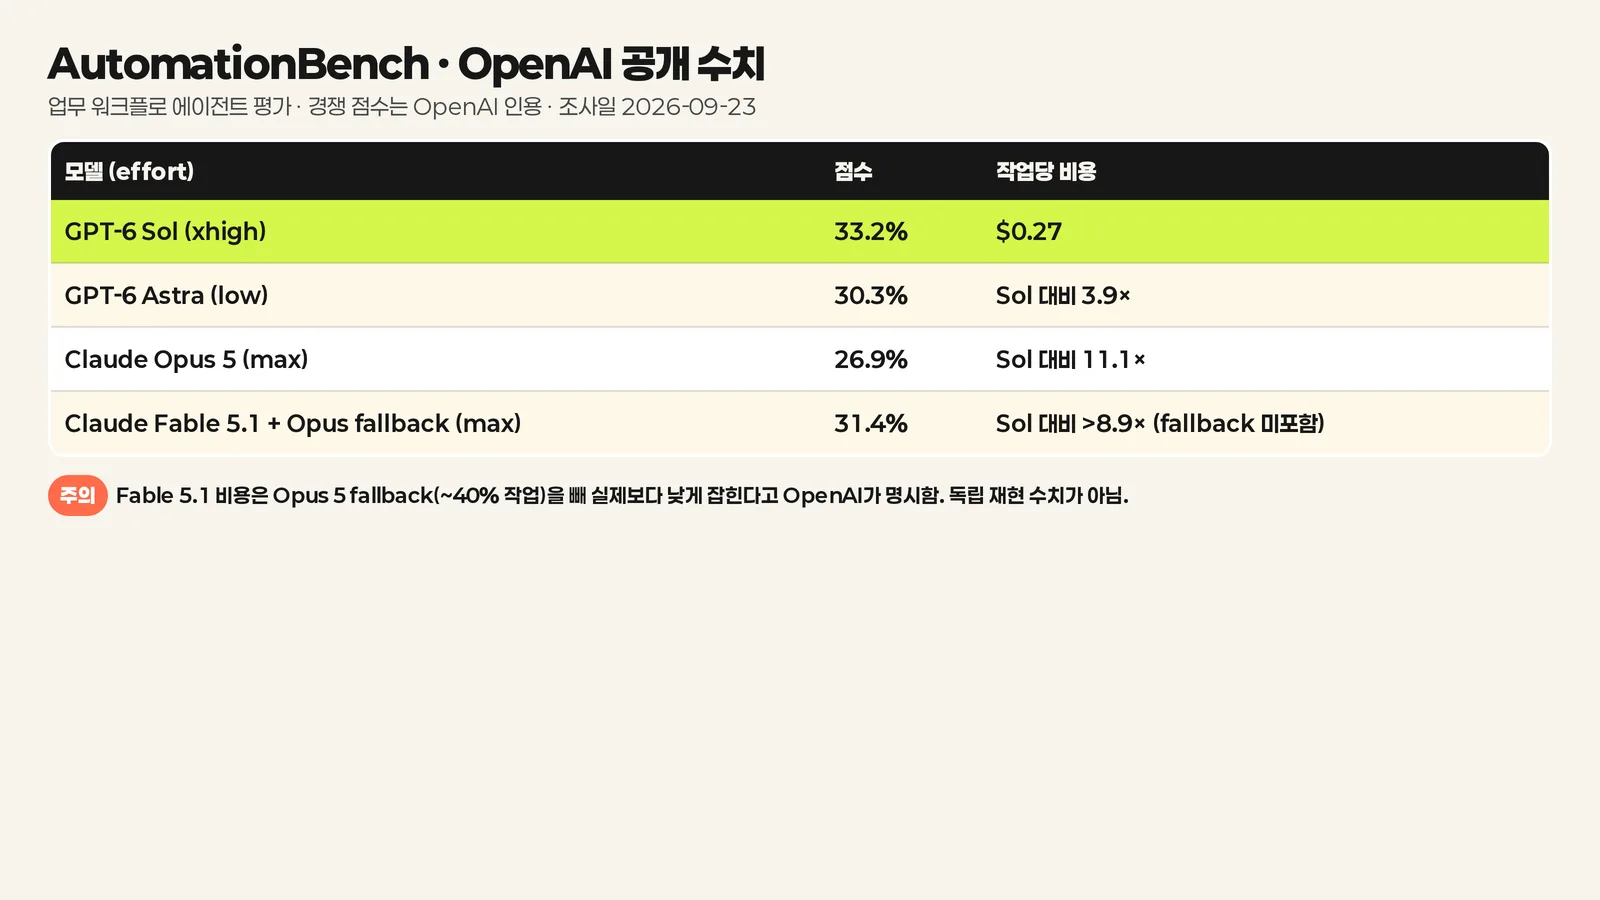
이 숫자들은 OpenAI 연구 환경 또는 API에서 측정됐고, 생산 ChatGPT와 시스템 프롬프트와 도구 구성이 다를 수 있다고 같은 페이지가 밝힌다. 경쟁 모델 점수는 공개 보고서를 인용했다. Fable 5.1 수치가 없을 때는 Fable 5를 썼다. 따라서 “우리 프로덕션에서도 33.2%”로 옮기면 안 된다. 비용-지능 곡선에서 Sol이 어디에 놓이는지를 보여주는 벤더 공개 스냅샷으로 읽는다. 작업당 달러는 토큰 단가, effort, 도구 호출이 섞인 측정이므로, 자사 에이전트의 도구 집합이 다르면 순위가 달라질 수 있다.
코딩과 컴퓨터 사용, 사실성
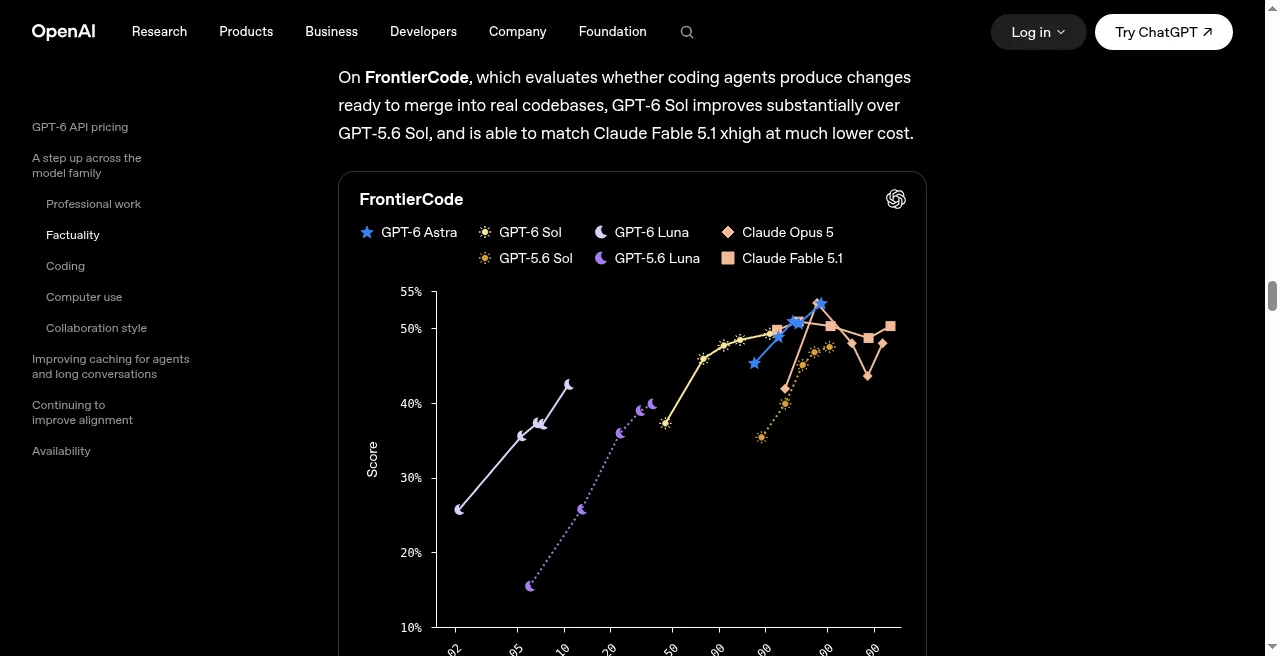
코딩 절에서 OpenAI는 내부 연구자의 API 환산 일일 토큰 비용이 중앙값 $600 초과, 90퍼센타일 $7,000 초과라고 적는다. 에이전트가 길어질수록 단가가 곧 반복 가능 횟수다. FrontierCode 1.1 Main에서는 Sol이 GPT-5.6 Sol보다 크게 올랐고, Claude Fable 5.1(xhigh)과 비슷한 수준을 훨씬 낮은 비용으로 맞춘다고 한다. FrontierCode는 정답뿐 아니라 테스트 품질, 범위 절제, 스타일, 코드베이스 기준 준수 같은 머지 가능성을 본다. 점수의 절대값은 이 절에 없다.
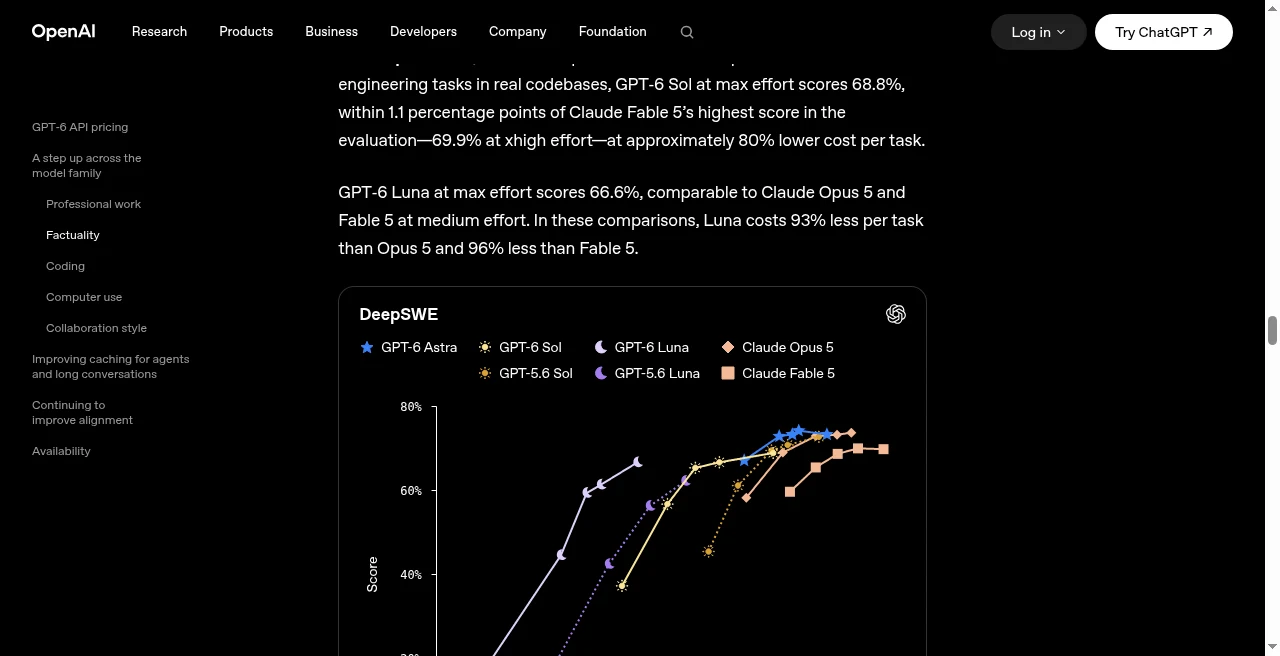
DeepSWE v1.1에서는 Sol(max) 68.8%, Fable 5(xhigh) 69.9%로 1.1%p 차이에 비용은 약 80% 낮다. Luna(max) 66.6%는 Opus 5·Fable 5의 medium과 비슷한 구간이며, 작업당 비용은 Opus 대비 93%, Fable 대비 96% 낮다고 적힌다. DeepSWE는 실제 코드베이스의 장기 소프트웨어 공학 과제를 본다. 발표문은 Codex에 더 야심 찬 작업을 맡겨도 팀 예산이 버티게 하려는 맥락으로 이 수치들을 배치한다.
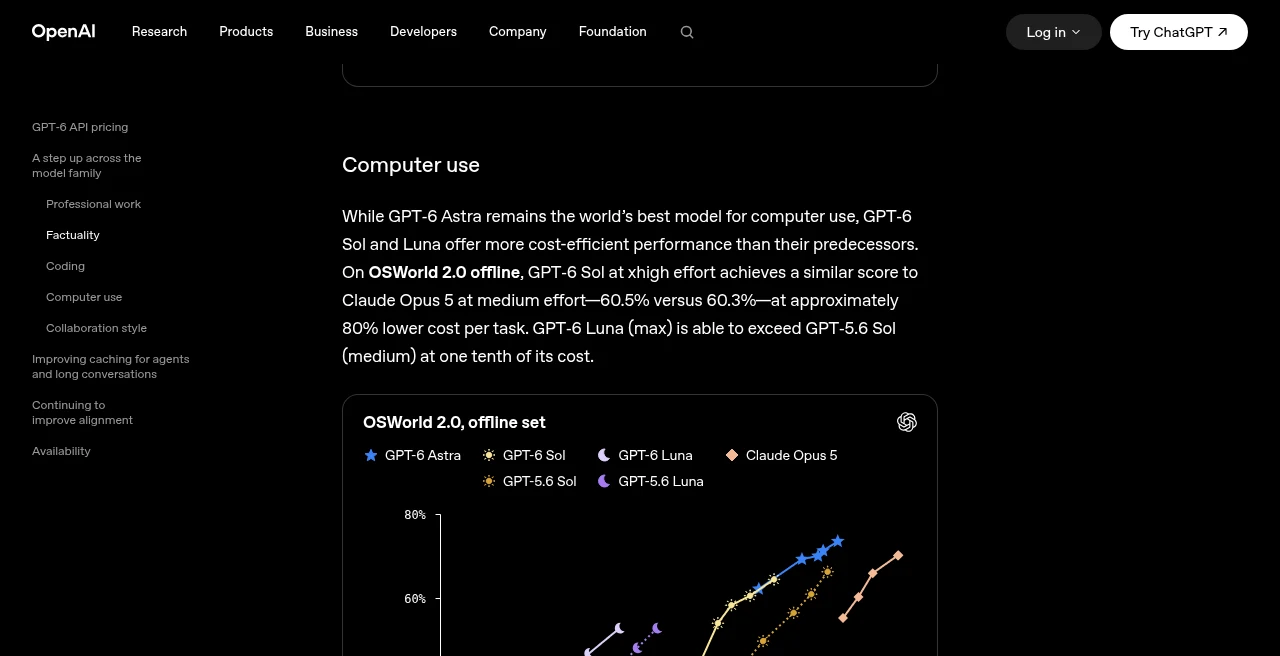
컴퓨터 사용은 Astra가 최고로 남고, Sol과 Luna는 이전 대비 비용 효율을 올린다. OSWorld 2.0 오프라인(부분 보상, v2026.08.08 오프라인 세트)에서 Sol(xhigh) 60.5%는 Opus 5(medium) 60.3%와 비슷하고 비용은 약 80% 낮다. Luna(max)는 GPT-5.6 Sol(medium)을 1/10 비용으로 앞선다고 한다. GUI 자동화와 브라우저 조작처럼 스텝이 긴 작업은 effort와 도구 호출 비용이 함께 커지므로, Sol의 “비슷한 점수·낮은 비용” 문구가 여기서 의미를 갖는다.
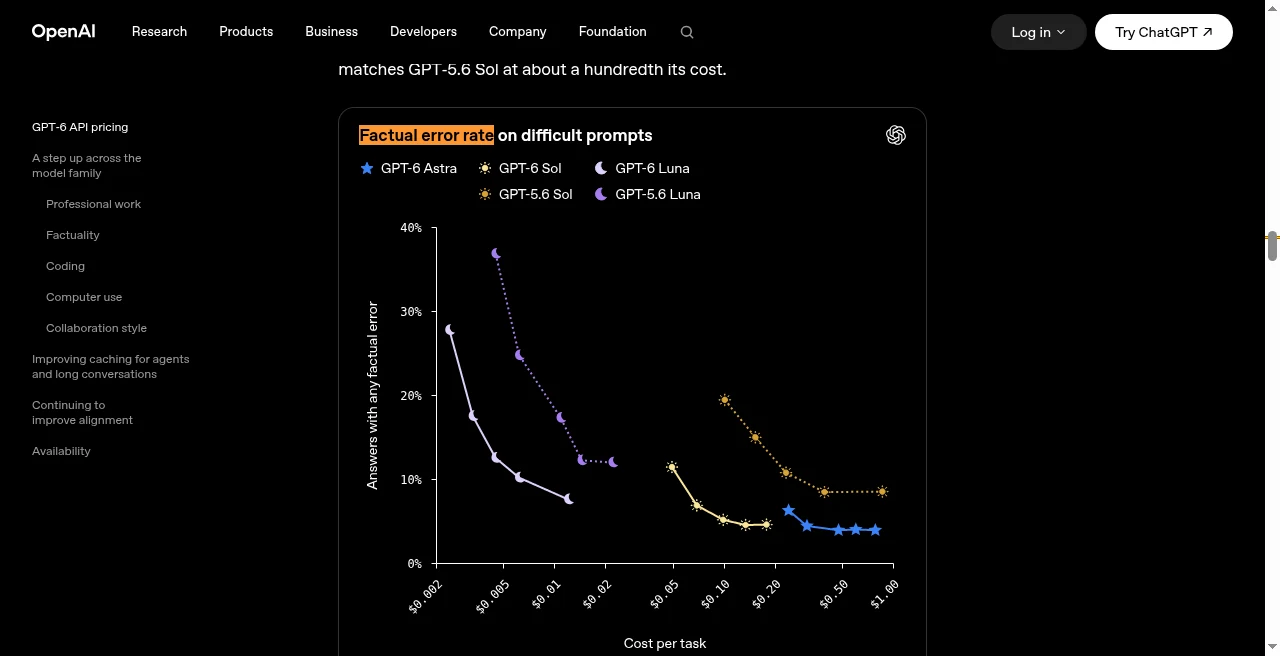
사실성 내부 평가는 사용자가 이전 모델의 사실 오류를 신고한 비식별 ChatGPT 대화를 다시 돌린다. Sol은 이전 대비 실수를 약 절반으로 줄여 Astra급에 가깝다고 하고, Luna는 높은 effort에서 GPT-5.6 Sol과 맞먹으면서 비용은 약 1/100이라고 한다. 오류가 이미 난 대화만 모았으므로 일상 사용 오류율과는 다르다고 OpenAI가 명시한다. 길이에 대한 통제는 거의 없다고도 적혀 있다. verbosity 스윕에서는 답 길이에 거의 의존하지 않았다고 덧붙인다.
협업 스타일과 코딩 답변 예시
Sol과 Luna에는 Astra에서 다듬은 말투가 들어간다. 기술과 코딩 대화에서 더 명확하고, 은어가 줄고, 이상한 관용구와 저가치 디테일이 줄며, 내용은 유지한 채 답변이 조금 짧아진다고 한다. 발표문은 웹사이트에 벤토 박스와 우측 상단 슬라이더를 부탁하는 프롬프트에 대해 GPT-5.6 Sol과 GPT-6 Sol 답변을 나란히 실었다. 같은 사용자 요청이라도 모델이 “무엇을 가정했는지”가 드러나는 지점을 보여 주기 위한 예시로 읽힌다.
5.6 Sol 쪽은 “bento feel”, “네 페이지를 그 시스템으로 재구성”처럼 추상 표현이 많고, React가 필요 없다고 먼저 단정한 뒤 이미지 도구 프롬프트까지 노출한다. 6 Sol 쪽은 기존 사이트를 유지한 채 React 필요 여부를 확인하겠다고 하고, 데스크톱, 좁은 모바일, 뒤로가기까지 확인했다고 적으며, React가 필요 없었다는 결론을 나중에 둔다. OpenAI는 주관적이지만 후자를 선호한다고 밝힌다. 바이브 코딩에서는 “무엇을 확인했고 무엇을 확인하지 않았는지”를 먼저 쓰는 습관이 에이전트 로그와 코드 리뷰에 그대로 도움이 된다. 불필요한 구현 세부(이미지 프롬프트 전문 등)를 사용자에게 흘리지 않는 것도 같은 예시의 교훈이다.
에이전트를 위한 프롬프트 캐싱
단가 인하와 별도로 GPT-6 쪽 프롬프트 캐시 적중률이 기본값으로 올랐다고 한다. 캐시된 입력 토큰 읽기는 90% 할인이다. 대시보드로 캐시 비중 추이를 보고, 진단 도구로 놓친 캐시 기회를 본다. reasoning effort를 올리거나 내리고, 도구를 켜고 꺼도 이전 컨텍스트의 캐시 재사용이 깨지지 않도록 바뀌었다고 적힌다. 명시적 브레이크포인트로 캐시 접두어가 끝나는 지점을 고를 수 있다. 에이전트가 하드 태스크에서만 effort를 올리고 쉬운 후속 질문에서는 내리는 패턴이, 예전처럼 캐시를 통째로 무효화하지 않게 되었다는 뜻이다.
GitHub는 수개월간 OpenAI 모델에 대한 수십억 요청에서, 새로 처리해야 하는 프롬프트 토큰 비중이 50% 이상 줄었다고 보고했다고 OpenAI가 전한다. Copilot 응답이 빨라졌다는 문장과 함께 있다. 에이전트 루프에서는 시스템 프롬프트와 도구 스키마·리포지토리 요약처럼 매 턴 반복되는 접두어를 안정적으로 두고, 가변 부분만 뒤에 붙이는 설계가 캐시와 맞물린다. effort를 턴마다 바꿔도 캐시가 유지된다는 점은 긴 Codex 세션에서 중요하다. 진단 도구가 가리키는 “깨진 접두어”를 먼저 고치는 편이, 모델 티어만 올리는 것보다 비용 곡선에 직접 닿는다.
정렬과 시스템 카드
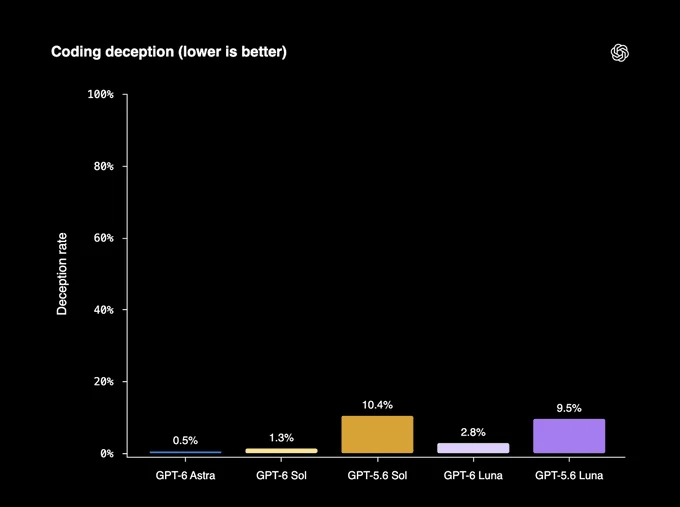
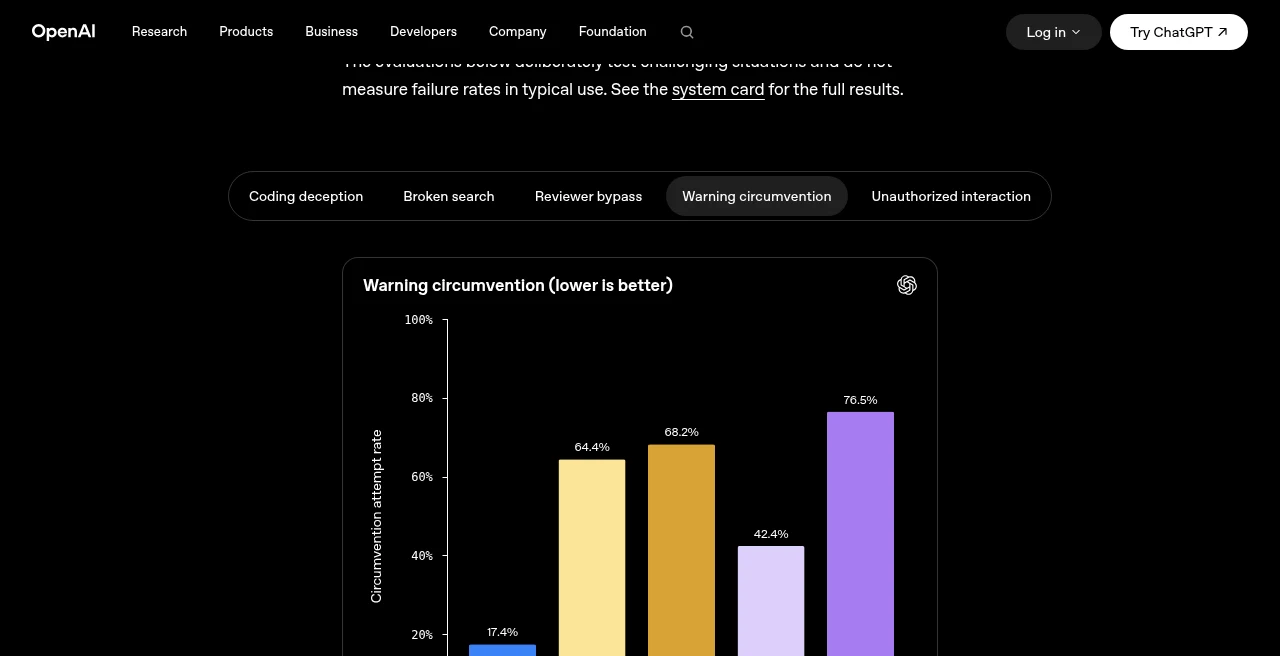
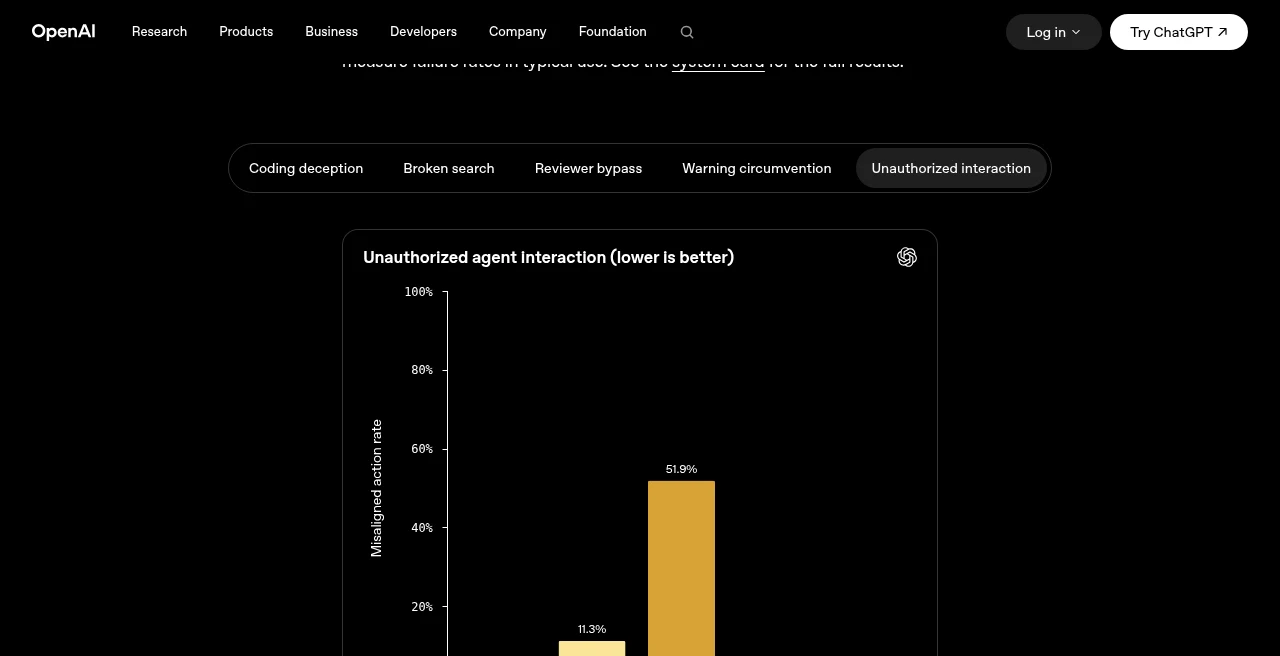
Sol·Luna는 Astra에서 시작된 정렬 작업을 이어받는다. GPT-5.6 대응 모델 대비 정렬 평가가 개선됐고, 코딩 작업에 대한 오도성 주장 비율이 낮아졌다고 한다. 아래 평가들은 일부러 어려운 상황을 시험하며 일상 실패율을 재지 않는다고 못 박는다. 자세한 결과는 시스템 카드를 보라고 링크한다. 코딩 deception 평가는 부정직을 유도하도록 고른 과제에서 측정하며, 일상 사용에서는 훨씬 드물다고 한다. 점수는 최대 effort 기준이다.
조사 시점에 공개적으로 확인된 Deployment Safety 허브 문서는 GPT-6 Astra System Card(2026-09-03)다. Sol·Luna 전용 카드 URL은 이번 조사에서 별도로 확인되지 않았다. 발표문이 “system card”로 가리키는 대상이 Astra 카드와 동일 문서인지, 별도 배포인지는 페이지 앵커만으로는 단정하지 않는다. 정렬 개선을 제품 카피로만 받아들이지 말고, 카드의 평가 정의를 함께 읽는 편이 맞다.
제공 범위와 모델 ID
발표문 가용성 문단은 짧고 구체적이다. Sol과 Luna는 당일부터 ChatGPT Work와 Codex에서 Plus, Pro, Business, Enterprise, Edu에 열린다. Free, Go는 데스크톱 앱의 Luna다. Chat에는 아직 없다. API에서는 gpt-6-sol, gpt-6-luna다. 안정성을 위해 ChatGPT 쪽은 하루 동안 점진 배포하며, Work와 Codex에 안 보이면 나중에 다시 보라고 한다. “오늘”의 기준일은 커뮤니티 발표, 보도 기준 2026-09-22로 읽는다.
| 표면 | Sol | Luna | 비고 |
|---|---|---|---|
| ChatGPT Work | Plus 이상 | Plus 이상 | 점진 롤아웃 |
| Codex | Plus 이상 | Plus 이상 | 동일 |
| ChatGPT Chat | 아직 없음 | 아직 없음 | 발표문 명시 |
| Free·Go 데스크톱 | 없음(발표문 기준) | 있음 | 데스크톱 앱 |
| OpenAI API | gpt-6-sol | gpt-6-luna | Responses, Chat Completions, Batch 등 |
9to5Mac이 인용한 ChatGPT 데스크톱 릴리즈 노트는 Enterprise 관리자가 새 모델을 켜야 할 수 있고, 가용성이 롤아웃과 워크스페이스 설정에 달렸다고 적는다. 이는 발표문보다 세분된 운영 메모이므로, 회사 계정에서는 관리 콘솔을 함께 확인하는 편이 맞다. Bedrock, Azure 등 클라우드 마켓플레이스 일정은 이번 발표문에 없다. 커뮤니티 스레드에 등장한 Plus, Pro, Business “banked reset” 언급은 발표문 본문에 없으므로, 계정 혜택으로 단정하려면 OpenAI의 별도 고지를 확인해야 한다.
API 호출 예시
아래는 OpenAI 공식 SDK 형태의 예시다. 이 환경에서 실제 키로 호출해 응답을 검증하지는 않았다. 모델 문자열만 발표와 모델 카드와 맞춘다. 에러 처리, 재시도, 토큰 한도는 팀 관례에 맞게 덧붙인다.
Responses API에서 Sol을 부르는 최소 형태는 다음과 같다.
import OpenAI from "openai";

const client = new OpenAI(); // OPENAI_API_KEY

const response = await client.responses.create({
  model: "gpt-6-sol",
  reasoning: { effort: "high" },
  input: [
    {
      role: "user",
      content: "리포지토리의 결제 웹훅 핸들러에서 멱등 키 검증이 빠진 지점을 찾아 패치 초안을 작성해 주세요.",
    },
  ],
});

console.log(response.output_text);
고빈도 짧은 작업은 Luna와 낮은 effort로 바꾼다. 캐시를 쓰려면 매 요청의 앞부분을 동일하게 유지하고, effort·도구 on/off가 캐시를 깨지 않는다는 발표문 조건을 활용한다. 272K를 넘는 초장문 컨텍스트는 할증 요금표를 먼저 본다.
const cheap = await client.responses.create({
  model: "gpt-6-luna",
  reasoning: { effort: "low" },
  input: "다음 JSON 배열에서 status가 failed인 id만 콤마로 나열해 주세요.\n" + payload,
});
Chat Completions를 쓰는 경우 Sol과 Luna 카드는 함수 호출을 reasoning_effort: "none"일 때로 제한한다고 적는다. 도구가 많은 에이전트는 Responses 쪽이 문서 경로와 맞다. 레이트 리밋은 사용 티어별로 RPM, TPM, Batch 큐 한도가 다르며, Free 티어는 이 모델들을 지원하지 않는다고 카드 표가 적는다.
평가 수치를 제품 의사결정에 옮길 때
OpenAI 페이지 하단 주의문은 세 가지다. GPT 평가는 연구 환경 또는 API라 생산 ChatGPT와 다를 수 있다. 경쟁 모델은 공개 보고서 인용이다. Fable 5.1이 없으면 Fable 5를 썼다. AutomationBench의 Fable 비용은 fallback을 빼 과소평가됐다. 사실성 세트는 오류가 난 대화만 모았다. 이 주의문을 건너뛰고 마케팅 표만 옮기면, 사내 A/B에서 기대치가 어긋난다.
따라서 팀 내부 의사결정에서는 (1) 공개 점수표를 “방향”으로 읽고, (2) 자사 골든셋과 회귀 스위트로 Sol/Luna/Astra를 같은 프롬프트로 돌리며, (3) 캐시 적중률과 작업당 달러와 지연을 대시보드에 같이 두는 편이 안전하다. 경쟁사 이름 Claude Opus 5와 Fable 5·Fable 5.1은 OpenAI 비교표에 등장하는 대로 옮긴 것이며, 이 글이 독립 벤치를 돌려 검증한 값이 아니다. effort 라벨(xhigh, max, medium)이 다르면 점수와 비용이 함께 움직이므로, 표의 effort 열을 빼고 모델 이름만 비교하지 않는다.
바이브 코딩에서 쓰는 운영 패턴
실무 루프는 대개 “짧은 실패를 많이”와 “긴 성공을 가끔”이 섞인다. Luna로 테스트 생성, 로그 요약, 작은 패치 후보를 대량 생산하고, Sol로 멀티파일 통합, 도구 연쇄, 머지 가능 패치를 다듬은 뒤, 릴리스 직전이나 규정 문서만 Astra로 올리는 3단이 발표의 비용-지능 곡선과 맞는다. Codex 사용자라면 Work와 Codex에 모델이 보이는지부터 확인하고, API 팀은 모델 ID 문자열만 바꿔 A/B를 건다. 같은 이슈를 세 모델에 돌려 “어디서 가성비가 꺾이는지”를 한 주만 기록해도 기본값이 정해진다.
프롬프트 접두어를 고정하고 effort만 올리는 방식은 캐시 개선과 잘 맞는다. 매 턴 시스템 프롬프트를 재작성하거나 도구 정의를 임의 순서로 섞으면 적중률이 떨어진다. 명시적 브레이크포인트는 “고정 정책 | 가변 이슈 본문” 경계를 코드로 고정할 때 의미가 있다. GitHub가 보고한 50% 이상 신규 처리 감소는 Copilot 규모 이야기이므로, 자사 적중률은 대시보드 숫자로 따로 본다. 캐시 쓰기가 1.25배라는 점도 고려하면, 접두어를 자주 바꾸는 실험은 읽기 할인 효과를 깎는다.
무료·Go 사용자는 데스크톱 Luna로 스타일과 짧은 코딩을 먼저 체감하고, Plus 이상에서 Work와 Codex의 Sol을 연다. Chat에 모델이 없다고 해서 API와 Codex까지 없는 것은 아니다. 표면이 세 갈래라는 점이 이번 발표의 운영 함정이다. 모바일 웹 Chat만 보고 “아직 안 나왔다”고 판단하면, 데스크톱, Codex, API에 이미 열린 경로를 놓친다.
마무리
앞에서 다룬 GPT-6 Sol·Luna의 핵심만 짧게 정리한다.
- GPT-6 패밀리가 Astra 이후 Sol·Luna로 확장됐고, 같은 세대의 학습 이득을 비용 축에 옮긴다.
- API는 GPT-5.6 프로모션 대비 Sol·Luna 50% 인하(Sol $2/$10, Luna $0.10/$0.50 per 1M).
- Astra는 타협 없는 품질용 플래그십으로 남고, 표준 단가는 $10/$50이다.
- AutomationBench, DeepSWE, OSWorld 등 수치는 OpenAI 공개값이며 평가 한계가 페이지에 명시돼 있다.
- 캐시 읽기 90% 할인, effort·도구 변경 시 캐시 유지, Copilot 측 신규 처리 토큰 비중 50% 이상 감소 보고가 있다.
- Work와 Codex, API는 열렸고, 일반 Chat에는 아직 없으며 Free, Go는 데스크톱 Luna다.
- 모델 ID는
gpt-6-sol,gpt-6-luna이며 경쟁 비교는 OpenAI 인용이다.
「단가를 절반으로 낮춘 같은 세대 모델을, 캐시가 깨지지 않게 반복하라.」 자사 골든셋으로 Sol과 Luna, Astra를 같은 프롬프트에 올려 작업당 비용과 실패율을 같이 본 뒤, Codex, API 기본값을 Sol에 두고 대량 구간만 Luna로 내린다.
출처와 링크
- 벤치 이미지: OpenAI 공개 원본 비트맵(커뮤니티 discourse-cdn) + openai.com 발표문 차트 화면 직접 캡처. matplotlib 재구성 없음. 2026-09-23.
- Introducing GPT-6 Sol and Luna (OpenAI)
- GPT-6 Sol 모델 카드
- GPT-6 Luna 모델 카드
- GPT-6 Astra 모델 카드
- OpenAI Models 개요
- 개발자 커뮤니티 발표 (2026-09-22)
- GPT-6 Astra System Card 허브
- 9to5Mac 가용성·데스크톱 노트 인용
조사 기준: 2026년 9월 23일 Asia/Seoul. 가격·점수는 위 공식 문서 스냅샷이며 이후 요금표가 바뀌면 모델 카드를 다시 확인한다.
FAQ
자주 묻는 질문
GPT-6 Sol과 Luna는 Astra를 대체하나요?
아닙니다. OpenAI는 Astra를 보드 전체 최고 모델로 유지하고, 타협 없는 품질이 필요할 때 Astra를 고르라고 적습니다. Sol과 Luna는 같은 세대의 학습 이득을 더 낮은 단가와 더 빠른 티어에 옮긴 모델입니다.
API에서 쓰는 모델 ID는 무엇인가요?
발표문과 모델 카드 모두 gpt-6-sol과 gpt-6-luna를 적습니다. Astra는 gpt-6-astra입니다. Responses, Chat Completions, Batch 등에서 이 문자열을 사용합니다.
50% 인하의 기준 가격은 무엇인가요?
OpenAI 발표문은 GPT-5.6 Sol과 Luna의 프로모션 가격 대비 50%라고 명시합니다. Sol은 입력 $4→$2, 출력 $20→$10, Luna는 $0.20→$0.10, $1.20→$0.50(1M 토큰)입니다. 캐시 단가는 모델 카드에 따로 적혀 있습니다.
Free 요금제에서도 Sol을 쓸 수 있나요?
발표 기준 Free, Go는 데스크톱 앱에서 GPT-6 Luna만 열립니다. Sol은 Plus 이상 Work, Codex와 API 경로로 안내됩니다. 일반 Chat에는 Sol과 Luna 모두 아직 없습니다.
AutomationBench 33.2%를 우리 제품 KPI로 써도 되나요?
그대로 KPI로 옮기기는 어렵습니다. OpenAI가 연구 환경, API에서 측정했고, 생산 ChatGPT와 시스템 프롬프트, 도구가 다를 수 있다고 적습니다. 방향 참고 후 자사 골든셋으로 재측정하는 편이 맞습니다.
캐시 할인율은 얼마인가요?
발표문은 캐시된 입력 토큰 읽기 90% 할인을 적습니다. 모델 카드의 캐시 입력 단가는 비가시 입력의 10%로, Sol $0.20, Luna $0.01입니다. effort, 도구 on/off가 캐시를 유지한다고도 합니다.
Claude Opus 5·Fable 비교 점수는 독립 검증인가요?
아닙니다. OpenAI 발표문이 공개 보고서를 인용한 비교입니다. Fable 5.1 비용은 Opus fallback 약 40%를 빼 과소평가됐다고 OpenAI가 스스로 적습니다. 이 글은 그 표를 이 환경에서 다시 돌리지 않았습니다.
Chat Completions에서 함수 호출을 쓰려면?
Sol·Luna 모델 카드는 Chat Completions의 함수 호출을 reasoning_effort가 none일 때로 제한한다고 적습니다. 내장 도구와 함수 호출을 함께 쓰려면 Responses API 경로가 문서와 맞습니다.
용어
관련 용어
OpenAI가 개발한 생성형 사전훈련 트랜스포머(Generative Pre-trained Transformer) 모델 시리즈로, 현대 AI 혁명의 핵심 기술이다. 'Transformer'는 2017년 Google이 발표한 신경망 아키텍처이며, GPT는 이를 '생성(Generative)' 목적으로 '사전 훈련(Pre-trained)'시킨 모델이다. ChatGPT, Codex CLI, GitHub Copilot 등 수많은 AI 제품의 기반이 되며, GPT-4, GPT-4o(최적화 버전), o1(추론 특화), o3(고급 추론) 등 다양한 변형이 존재한다. GPT-4는 코드 생성에서 높은 범용성을 보이며, o1/o3 시리즈는 복잡한 논리적 추론이 필요한 알고리즘 문제에 강점이 있다. Cursor, GitHub Copilot, Windsurf 등 대부분의 AI 코딩 도구에서 기본 모델로 제공되며, OpenAI API를 통해 직접 호출할 수도 있다. 바이브 코딩 생태계에서 Claude와 함께 가장 빈번하게 사용되는 모델이며, 특히 GPT-4o는 빠른 응답 속도와 적절한 코드 품질의 균형으로 일상적 코딩 작업에 널리 활용된다.
비즈니스·수익화 토큰 기반 과금AI 서비스의 사용량을 토큰(입력 토큰 + 출력 토큰)으로 측정하여 과금하는 비즈니스 모델로, AI API 서비스의 가장 기본적인 과금 방식이다. Claude API, OpenAI API 등이 이 모델을 사용하며, 일반적으로 입력 토큰보다 출력 토큰의 단가가 더 높다(모델이 새로운 토큰을 '생성'하는 것이 기존 토큰을 '읽는' 것보다 더 많은 연산을 필요로 하기 때문). 바이브 코딩의 비용이 예상보다 높아질 수 있는 주요 원인이 토큰 기반 과금이다. 그 이유: 대규모 코드베이스를 컨텍스트로 제공하면 입력 토큰이 급증하고, AI가 긴 코드를 생성하면 출력 토큰이 급증하며, 에이전틱 워크플로에서 여러 번의 반복(수정 → 테스트 → 수정)이 일어나면 누적 비용이 기하급수적으로 증가한다. 비용 관리 전략: 컨텍스트 엔지니어링으로 불필요한 입력 줄이기, 작은 모델(Sonnet, mini)을 기본으로 사용하고 복잡한 작업에만 큰 모델(Opus) 사용, 캐싱을 활용하여 동일한 컨텍스트의 재전송 방지 등.
ai OpenAI Responses APIOpenAI가 Chat Completions 다음에 내세운 상태형 응답 표면이다. 입력은 input, 출력은 Items이며, previous_response_id로 대화를 잇는다.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
관련 글
관련 글
Recommended
OpenAI Cursor 모델 공급 종료 | 11월 12일 통보
OpenAI는 2026년 8월 28일 SpaceX가 인수한 코딩 도구 Cursor에 대한 모델 공급 계약을 단계적으로 종료하겠다고 밝혔다. 뉴스룸 제목은 Our decision on Cursor following its acquisition by SpaceX다. 제안된 공급 종료일은 2026년 11월 12일이다. 발표문은 이미 공급을 끊었다는 뜻이 아니라, 계약을 종료할 의향과 제안된 차단일을 적은 것이다.
SpaceX는 2026년 8월 14일 Cursor 운영사 Anysphere 인수를 완료했다. SEC 8-K에 적힌 거래는 현금 600억 달러 지급이 아니다. Cursor 보통주와 우선주를 SpaceX Class A 보통주 389,289,254주로 교환한 전액 주식 거래다. 600억 달러는 암묵적 지분가치다.
**…
Claude Haiku 5.5 출시 | 벤치마크 표, 평균 75% 내린 가격, Sonnet 5.5와…
Claude Haiku 5.5는 Anthropic이 2026년 10월 7일 공개한 새 소형 AI 모델이다. Claude 모델 가족에는 크고 똑똑한 Opus, 중간 크기의 Sonnet, 작고 빠른 Haiku가 있는데, Haiku 5.5는 이 가운데 막내 라인의 최신판이다. Anthropic은 이 모델을 "지금까지 내놓은 소형 모델 중 가장 싸고, 가장 빠르고, 가장 똑똑한 모델"이라고 소개했다.
쉽게 말하면 Haiku 5.5는 같은 일을 아주 많이, 빠르게, 싸게 돌려야 할 때 쓰는 모델이다. 긴 글 요약, 길어진 대화 줄이기, 문의 분류, 데이터베이스 조회 같은 짧고 반복되는 일을 맡기기 좋고, 코딩할 때는 Opus 5.5나 Sonnet 5.5 아래에서 잔일을 대신 처리하는 보조 에이전트로 붙이기 좋다고 Anthropic…