바이브코딩
Claude Haiku 5.5 출시 | 벤치마크 표, 평균 75% 내린 가격, Sonnet 5.5와 나눠 쓰는 법
Anthropic의 새 소형 모델 Haiku 5.5의 공식 벤치마크, 가격, 노력 설정, 월간 API 크레딧, 바이브 코딩 활용법
Claude Haiku 5.5는 Anthropic이 2026년 10월 7일 공개한 새 소형 AI 모델이다. Claude 모델 가족에는 크고 똑똑한 Opus, 중간 크기의 Sonnet, 작고 빠른 Haiku가 있는데, Haiku 5.5는 이 가운데 막내 라인의 최신판이다. Anthropic은 이 모델을 "지금까지 내놓은 소형 모델 중 가장 싸고, 가장 빠르고, 가장 똑똑한 모델"이라고 소개했다.
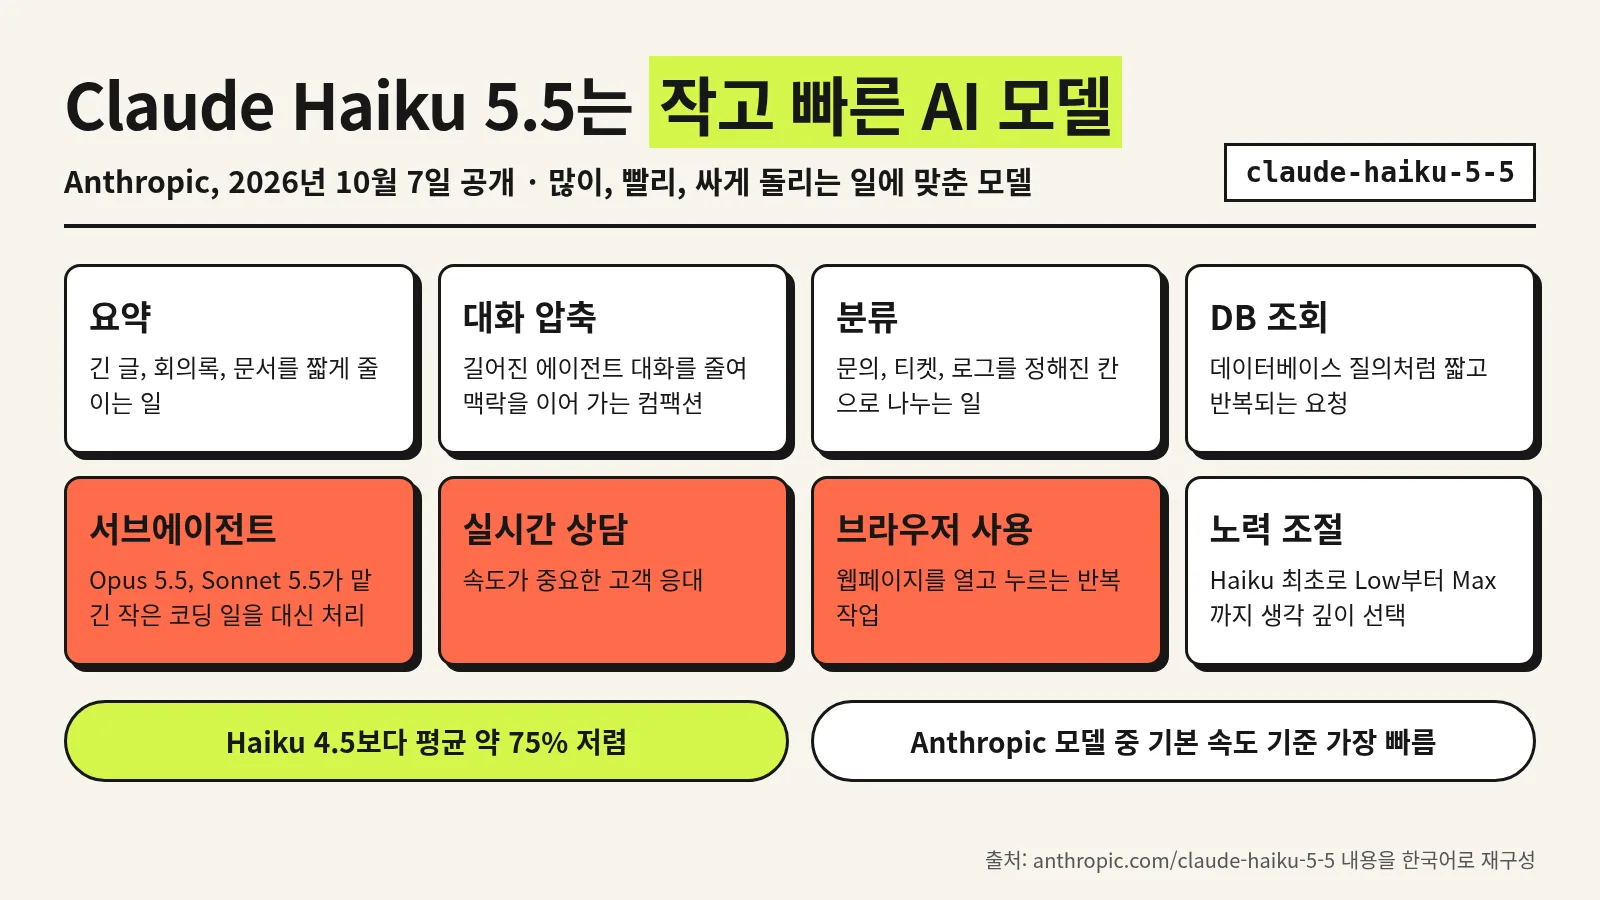
쉽게 말하면 Haiku 5.5는 같은 일을 아주 많이, 빠르게, 싸게 돌려야 할 때 쓰는 모델이다. 긴 글 요약, 길어진 대화 줄이기, 문의 분류, 데이터베이스 조회 같은 짧고 반복되는 일을 맡기기 좋고, 코딩할 때는 Opus 5.5나 Sonnet 5.5 아래에서 잔일을 대신 처리하는 보조 에이전트로 붙이기 좋다고 Anthropic은 설명한다. 속도도 Anthropic 모델 중 가장 빨라서 실시간 고객 상담이나 브라우저 조작처럼 기다림이 곧 비용인 작업에 맞는다.
가격은 Haiku 4.5보다 평균 약 75% 내려갔다. 같은 날 Anthropic은 Sonnet 5.5의 캐시 읽기 가격을 절반으로 낮췄고, Claude Max와 Team 구독자에게 매달 API 크레딧을 주는 제도도 새로 열었다. 아래 내용은 공식 발표문, Haiku 5.5 시스템 카드, 마이그레이션 가이드, 고객센터 문서를 2026년 10월 8일(KST) 기준으로 대조해 쓴 것이다.
Claude Haiku 5.5는 어떤 모델인가
AI 모델 이름에 붙는 "소형(small model)"은 성능이 나쁘다는 뜻이 아니라, 한 번 답할 때 드는 계산량이 적은 모델이라는 뜻에 가깝다. 계산량이 적으면 답이 빨리 나오고 토큰당 값도 싸다. 대신 아주 어려운 문제를 오래 붙잡고 푸는 능력은 큰 모델보다 떨어진다. 그래서 큰 모델은 설계와 판단을, 작은 모델은 양이 많고 범위가 좁은 일을 맡기는 식으로 나눠 쓰는 경우가 많다.
Anthropic이 Haiku 5.5의 쓰임새로 직접 든 예는 다음과 같다. 요약(summaries), 컴팩션(compactions), 데이터베이스 쿼리, 분류 요청, 코딩 작업의 서브에이전트, 실시간 고객 지원, 브라우저 사용이다. 이 가운데 낯선 말 두 개만 풀어 두면 이렇다.
컴팩션은 에이전트와 오래 대화하다 보면 쌓이는 기록을 짧게 압축해 다음 작업에 넘기는 일이다. 대화가 길어질수록 매번 보내는 토큰이 늘어 비용과 속도가 나빠지는데, 이 압축을 싸고 빠른 모델이 맡으면 전체 비용이 줄어든다. 서브에이전트는 큰 모델이 일을 쪼개 다른 모델에게 맡길 때, 그 맡겨진 일을 처리하는 보조 에이전트다. 예를 들어 리더 모델이 코드를 짜는 동안 서브에이전트가 문서에서 필요한 값만 찾아오는 식이다.
Haiku 5.5에는 Haiku 계열 최초로 노력(effort) 설정도 들어갔다. 같은 질문이라도 생각을 짧게 하고 싸게 답할지, 길게 생각하고 정확하게 답할지를 Low, Med, High, Xhigh, Max 다섯 단계 중에서 고를 수 있다. 이전 Haiku 4.5에는 이 설정이 없었다.
지금 알아둘 것: 가격, 모델 ID, 쓸 수 있는 곳
claude-haiku-5-5가 적혀 있다. 출처: anthropic.comAPI로 Haiku 5.5를 부를 때 쓰는 이름, 곧 모델 ID는 claude-haiku-5-5다. 코드에서 model 값에 이 문자열을 넣으면 된다. 마이그레이션 가이드에 따르면 이 ID에는 날짜 접미사가 없고 별도 별칭(alias)도 없다. Haiku 4.5가 claude-haiku-4-5-20251001처럼 날짜가 붙은 이름을 함께 썼던 것과 다르다.
가격은 100만 토큰당 입력 0.10달러, 출력 0.50달러부터 시작한다. 이 값은 프롬프트가 10만 토큰 이하일 때이고, 10만 토큰을 넘으면 입력 0.50달러, 출력 2.50달러로 올라간다. Haiku 4.5는 입력 1.00달러, 출력 5.00달러였으니 짧은 요청 기준으로는 10분의 1 가격이다. 자세한 표와 "평균 75%"의 계산 방식은 아래 가격 절에서 다룬다.
Haiku 5.5는 발표 당일부터 모든 플랫폼에서 쓸 수 있다. Anthropic은 Claude Platform(API) 외에 Amazon Web Services, Google Cloud, Microsoft Azure를 명시했다. 플랫폼마다 모델 ID 표기는 조금 다르다.
| 플랫폼 | Haiku 4.5 모델 ID | Haiku 5.5 모델 ID |
|---|---|---|
| Claude API | claude-haiku-4-5-20251001 또는 claude-haiku-4-5 | claude-haiku-5-5 |
| Amazon Bedrock | anthropic.claude-haiku-4-5 | anthropic.claude-haiku-5-5 |
| Claude Platform on AWS | claude-haiku-4-5 | claude-haiku-5-5 |
| Google Cloud | claude-haiku-4-5@20251001 | claude-haiku-5-5 |
| Microsoft Foundry | claude-haiku-4-5 | claude-haiku-5-5 |
표의 출처는 Anthropic의 Haiku 5.5 마이그레이션 가이드다. 속도에 관해서는 각주가 하나 붙어 있다. Haiku 5.5는 각 모델의 표준 속도 기준으로 Anthropic에서 가장 빠른 모델이지만, Opus 모델을 Fast Mode로 돌릴 때보다는 느리다.
핵심 포인트: Haiku 5.5는 "싸고 빠른 일꾼" 자리의 모델이다. 짧은 요청을 대량으로 처리하는 앱이나, 큰 모델 아래의 보조 에이전트로 쓸 때 가격 차이가 가장 크게 난다.
Claude Haiku 5.5 벤치마크 표
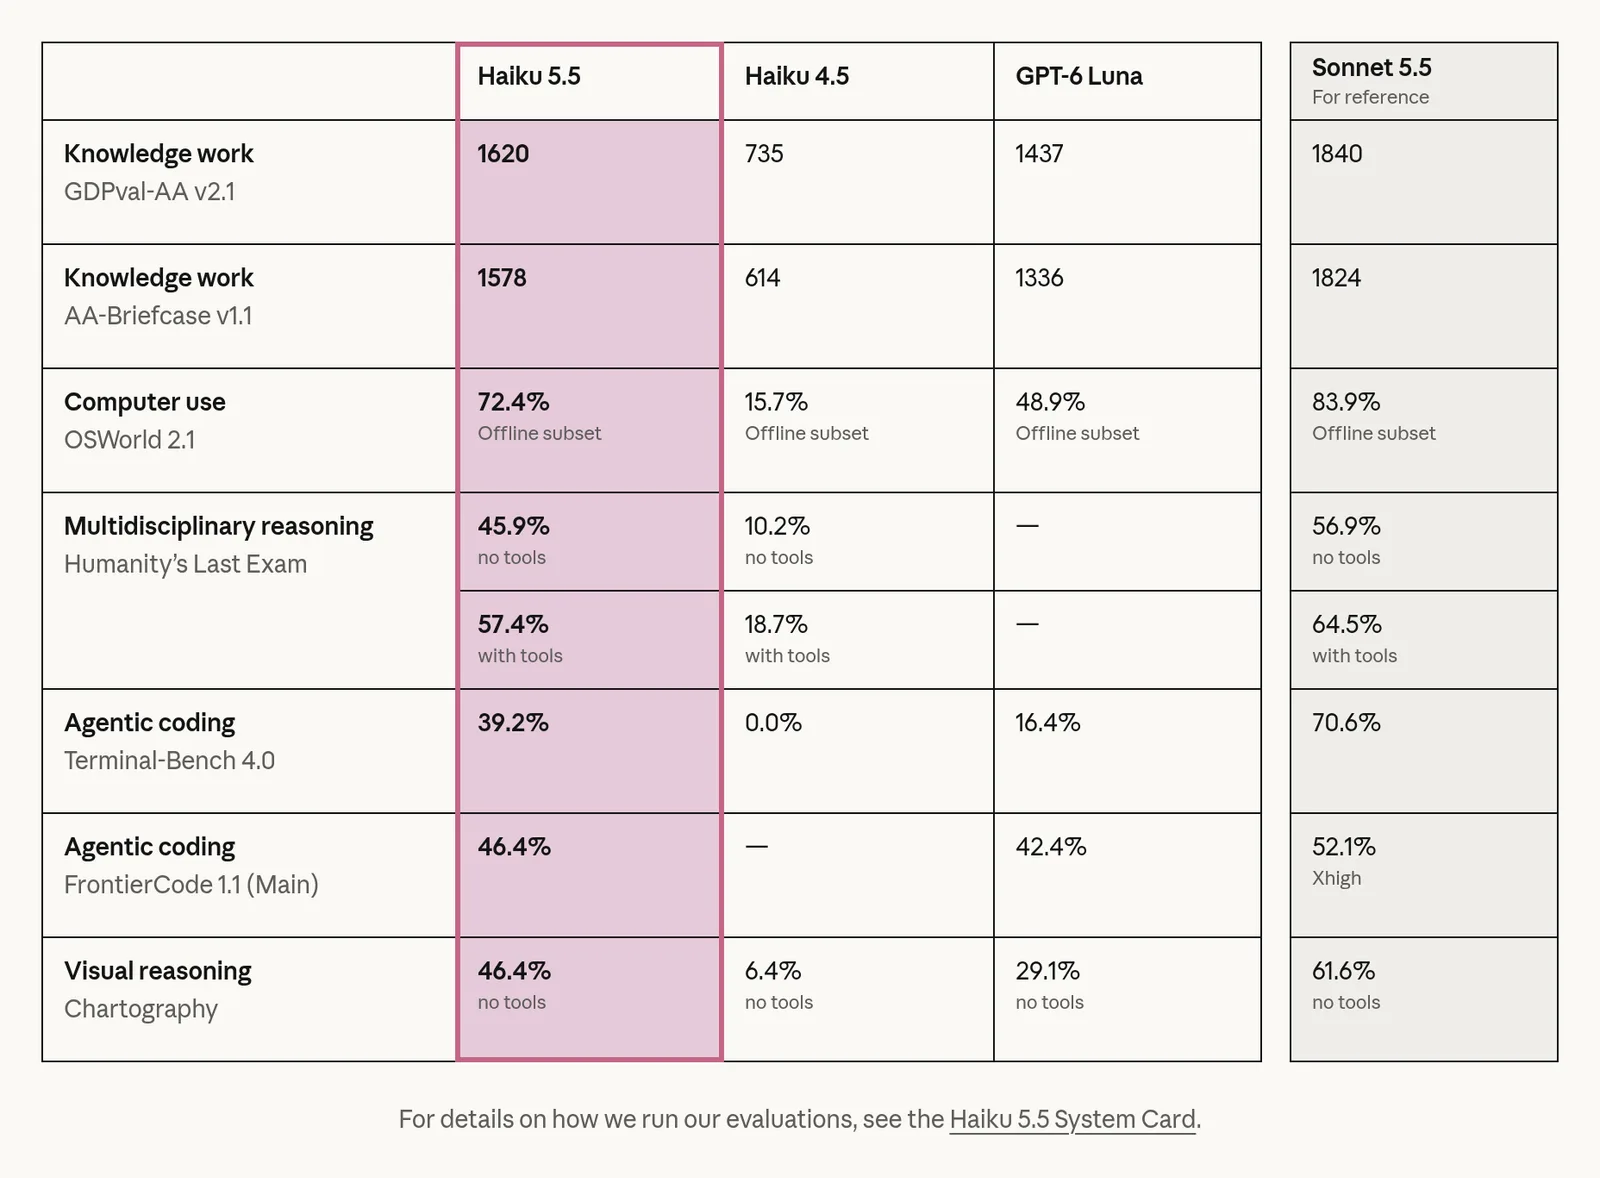
아래 표는 공식 발표문의 벤치마크 수치를 그대로 옮긴 것이다. Sonnet 5.5는 Anthropic이 "참고용(For reference)"으로 붙인 상위 모델이고, GPT-6 Luna는 비교 대상으로 들어간 OpenAI 모델이다. 값이 비어 있는 칸은 원문에서도 수치가 없는 칸이다. 시스템 카드의 요약표(Table 8.1.A)와 한 칸씩 대조했고 숫자는 모두 일치했다.
| 분야 | 벤치마크 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 (참고) |
|---|---|---|---|---|---|
| 지식 업무 | GDPval-AA v2.1 (Elo) | 1620 | 735 | 1437 | 1840 |
| 지식 업무 | AA-Briefcase v1.1 (Elo) | 1578 | 614 | 1336 | 1824 |
| 컴퓨터 사용 | OSWorld 2.1 (오프라인 서브셋) | 72.4% | 15.7% | 48.9% | 83.9% |
| 다분야 추론 | Humanity's Last Exam (도구 없음) | 45.9% | 10.2% | 수치 없음 | 56.9% |
| 다분야 추론 | Humanity's Last Exam (도구 사용) | 57.4% | 18.7% | 수치 없음 | 64.5% |
| 에이전트 코딩 | Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| 에이전트 코딩 | FrontierCode 1.1 (Main) | 46.4% | 수치 없음 | 42.4% | 52.1% (Xhigh) |
| 시각 추론 | Chartography (도구 없음) | 46.4% | 6.4% | 29.1% | 61.6% |
시스템 카드에 따르면 Haiku 5.5의 수치는 별도 표시가 없으면 노력 Max 설정에서 잰 값이다. FrontierCode의 Sonnet 5.5 칸만 Xhigh 설정 값(52.1%)인데, 시스템 카드에는 Sonnet 5.5를 Max로 돌렸을 때 46.2%였고 가장 좋은 점수가 Xhigh에서 나왔다고 적혀 있다. Haiku 5.5는 Max에서 46.4%, Xhigh에서 45.8%였다. 시스템 카드는 Cognition의 리더보드에 Haiku 4.5 결과가 없다고 밝혀, Haiku 4.5 칸이 비어 있는 이유도 설명된다.
각 벤치마크가 재는 것
벤치마크 이름만 보면 무엇을 쟀는지 알기 어렵다. 아래 설명은 발표문과 시스템 카드에 적힌 정의만 옮겼다.
| 벤치마크 | 재는 능력 | 공식 설명 요지 |
|---|---|---|
| GDPval-AA v2.1 | 실제 직업 업무 결과물 | Artificial Analysis가 만든 평가. 44개 직업, 9개 산업의 220개 과제(문서, 슬라이드, 스프레드시트 등)를 셸과 웹 브라우징을 쓰며 풀게 하고, 결과물을 블라인드 쌍대 비교해 Elo 점수로 매긴다 |
| AA-Briefcase v1.1 | 긴 호흡의 지식 업무 | Artificial Analysis의 새 벤치마크. 여러 주짜리 프로젝트, 서로 이어진 과제, 수천 개 입력 파일을 다루게 하고 루브릭과 모델 심사단 비교로 채점한다 |
| OSWorld 2.1 | 실제 컴퓨터 조작 | 에이전트가 우분투 가상 머신을 화면과 마우스, 키보드로 다뤄 긴 다단계 작업을 끝내는지 본다. 오프라인 서브셋은 108개 중 인터넷 없이 하는 82개 과제다 |
| Humanity's Last Exam | 전문가 수준 지식과 추론 | 수십 개 분야 2,500문항. 인터넷 검색으로 금방 답할 수 없게 만든 문제들이다. 도구 사용판은 웹 검색, 웹 페치, 코드 실행 등을 허용한다 |
| Terminal-Bench 4.0 | 터미널 안의 복잡한 작업 | 명령줄 환경에서 여러 단계의 전문 작업을 끝내는지 본다. 66개 과제로, 계산생물학, 물리 시뮬레이션, CAD, GPU 성능 작업 같은 문제가 들어 있다 |
| FrontierCode 1.1 | 실전 코딩 패치 | Cognition이 실제 오픈소스 풀 리퀘스트로 만든 150개 과제. 사람 수정 없이 머지 가능한 코드를 목표로 채점한다. Main은 그중 어려운 100개다 |
| Chartography | 차트 읽기 | Surge AI의 100개 과제. 캔들스틱, 생존 곡선, 등고선, 생키 다이어그램처럼 까다로운 차트를 읽고 정해진 허용 범위 안의 답을 내는지 본다 |
숫자가 실제로 뜻하는 것
가장 눈에 띄는 건 이전 Haiku와의 격차다. Terminal-Bench 4.0에서 Haiku 4.5는 0.0%로 한 번도 통과하지 못했는데 Haiku 5.5는 39.2%를 기록했다. OSWorld는 15.7%에서 72.4%로, Chartography(도구 없음)는 6.4%에서 46.4%로 올랐다. 지식 업무 Elo도 두 벤치마크 모두 두 배 넘게 뛰었다. "작은 모델이라 컴퓨터 조작이나 터미널 작업은 못 맡긴다"는 전제가 Haiku 4.5 때와는 달라졌다는 뜻이다.
비교 대상인 GPT-6 Luna보다는 수치가 공개된 모든 항목에서 높다. 시스템 카드에 따르면 OSWorld의 GPT-6 Luna 수치는 Anthropic이 같은 82개 과제를 OpenAI API로 직접 돌린 결과이고, Terminal-Bench 4.0의 16.4%는 공개 리더보드 값이다.
반대로 Sonnet 5.5와의 거리도 표에 그대로 드러난다. 지식 업무와 컴퓨터 사용, 추론에서는 Haiku 5.5가 Sonnet 5.5에 꽤 가깝지만, Terminal-Bench 4.0은 39.2% 대 70.6%로 차이가 크다. 시스템 카드는 Opus 5.5의 Terminal-Bench 4.0 점수를 66.4%(Xhigh)로 적고 있다. 복잡한 에이전트 코딩은 여전히 큰 모델 몫이라는 Anthropic의 설명과 맞는 숫자다.
OSWorld의 72.4%는 부분 점수(체크포인트별 점수의 평균)다. 모든 체크포인트를 통과해야 성공으로 치는 엄격 통과율은 Haiku 5.5가 37.1%, Sonnet 5.5가 48.8%, Opus 5.5가 53.2%였다. Chartography는 도구를 쓰게 하면 Haiku 5.5가 86.2%까지 올라가고 Sonnet 5.5는 90.2%였다. 표에 실린 숫자는 도구 없는 쪽이다.
노력(effort) 설정과 비용 그래프
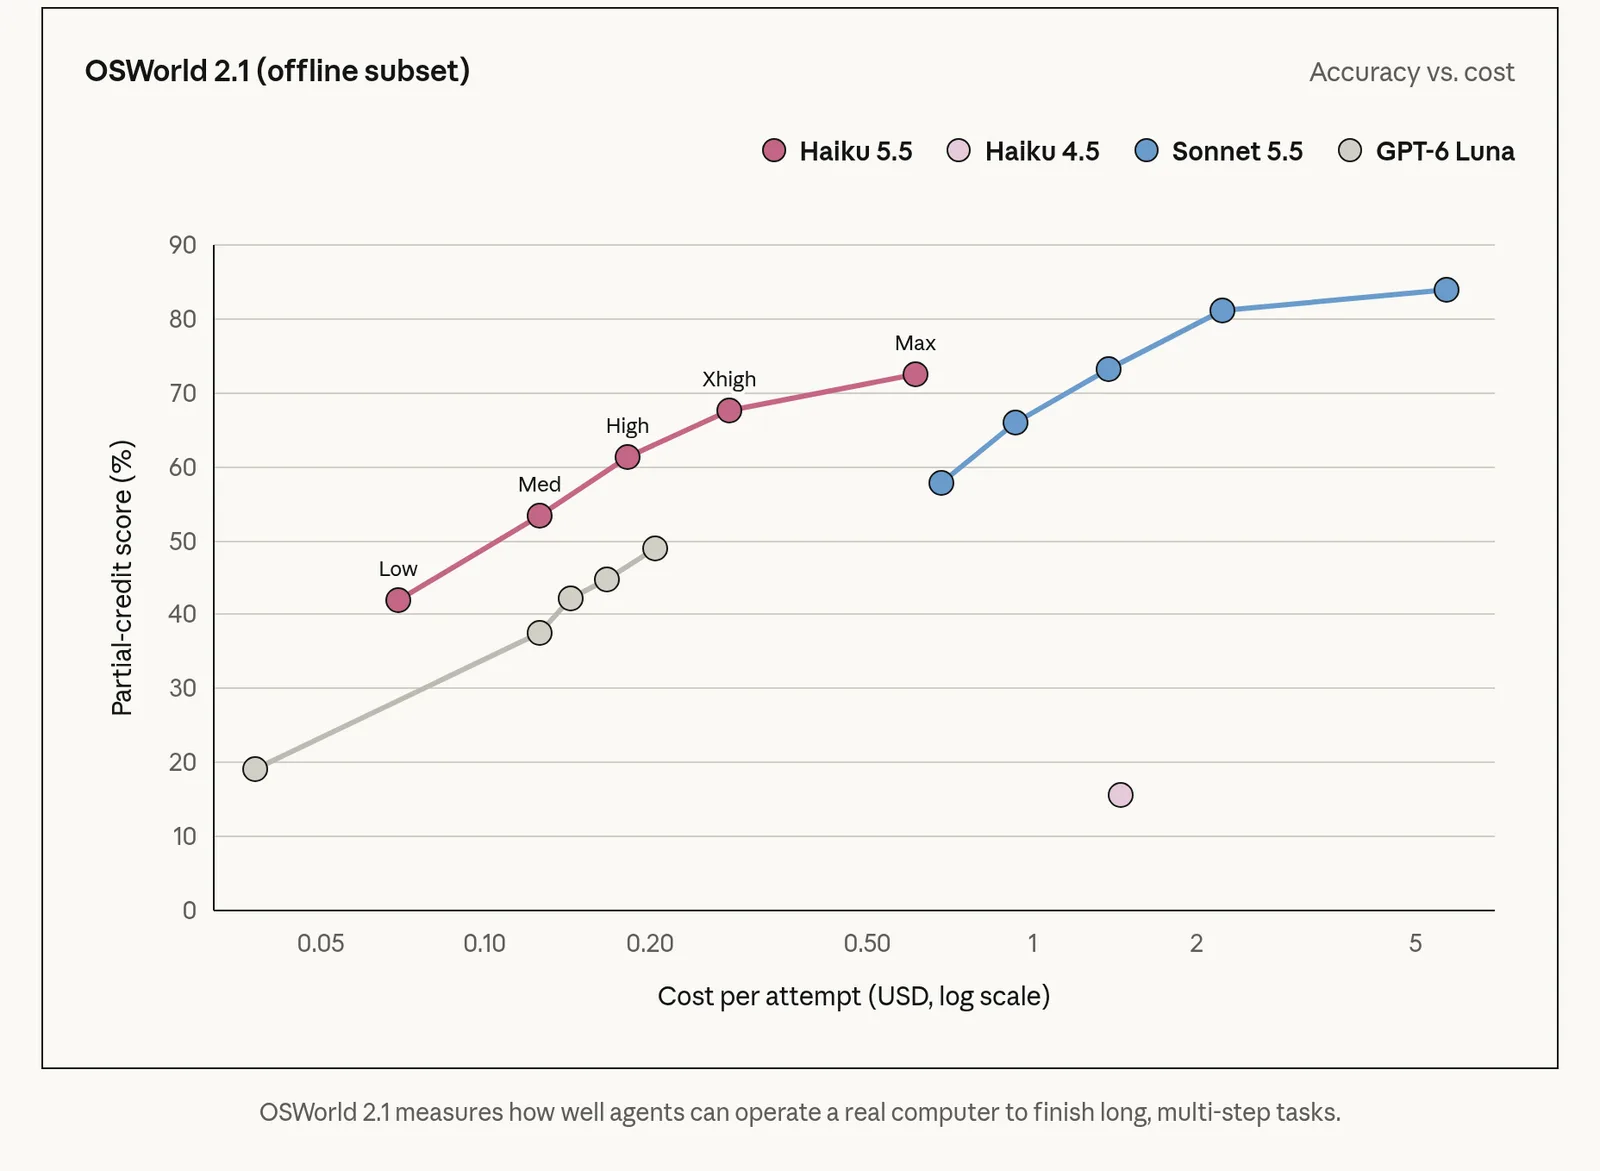
노력 설정은 모델이 답하기 전에 얼마나 생각할지를 정하는 손잡이다. Low로 두면 생각을 짧게 해서 싸고 빠르며, Max로 두면 길게 생각해 정확도가 올라가는 대신 토큰을 많이 쓴다. Anthropic은 이 설정으로 "비용과 지능 중 무엇을 우선할지 사용자가 정할 수 있다"고 설명했고, 이 기능이 Haiku급 모델에 들어간 건 처음이다.
공식 그래프를 보면 OSWorld에서 Haiku 5.5의 Low 지점은 40%대 초반, Max 지점은 72.4%이고, Max 지점의 시도당 비용도 1달러 아래에 있다. 같은 그래프에서 Haiku 4.5는 1달러가 넘는 비용 위치에 15.7%로 찍혀 있다. 단계를 하나 올릴 때마다 점수와 비용이 함께 오르는 모양이라, 작업의 난도에 맞춰 단계를 고르는 것이 이 설정의 쓰임새다.
시스템 카드에는 기본값에 관한 정보도 있다. 기본 노력 단계는 medium이고, GDPval-AA에서 medium은 1277점을 냈다. Max(1620점)보다 낮지만 출력 토큰은 Max의 약 10분의 1만 썼다. AA-Briefcase에서는 medium이 1372점이었고 출력 토큰은 Max의 4분의 1이 안 됐다. 벤치마크 표의 점수는 Max 기준이므로, 기본값 그대로 쓰면 그보다 낮은 점수가 나온다고 보는 것이 맞다.
API에서는 마이그레이션 가이드 예시처럼 thinking을 adaptive로 두고 output_config.effort에 단계를 넣는다. 아래 요청 본문은 마이그레이션 가이드에 실린 Haiku 5.5용 예시다.
{
  "model": "claude-haiku-5-5",
  "max_tokens": 16000,
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "medium" },
  "messages": [{ "role": "user", "content": "..." }]
}
마이그레이션 가이드는 Haiku 4.5에서 생각(thinking) 없이 쓰던 작업이나 작은 생각 예산으로 아끼던 작업이라면 낮은 노력 단계를 고르라고 안내한다. 낮은 단계에서는 쉬운 요청이면 생각을 아예 건너뛰기도 한다.
가격표와 평균 75% 저렴의 계산
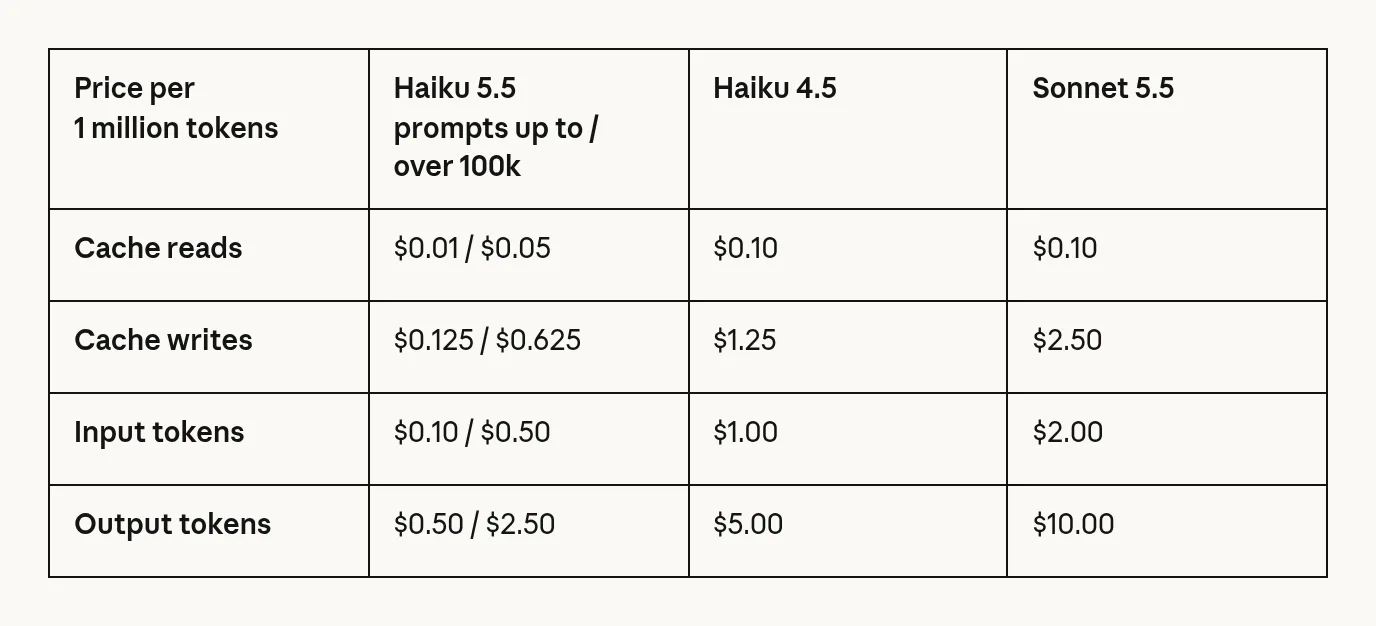
공식 가격은 다음과 같다. 단위는 100만 토큰당 달러다. Haiku 5.5는 프롬프트 길이가 10만 토큰 이하인지, 넘는지에 따라 값이 두 가지다.
| 100만 토큰당 가격 | Haiku 5.5 (10만 이하) | Haiku 5.5 (10만 초과) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| 캐시 읽기 | $0.01 | $0.05 | $0.10 | $0.10 |
| 캐시 쓰기 | $0.125 | $0.625 | $1.25 | $2.50 |
| 입력 토큰 | $0.10 | $0.50 | $1.00 | $2.00 |
| 출력 토큰 | $0.50 | $2.50 | $5.00 | $10.00 |
캐시 읽기는 이전 요청에서 저장해 둔 프롬프트 앞부분(시스템 프롬프트, 긴 문서 등)을 다시 쓸 때 내는 값이고, 캐시 쓰기는 그 앞부분을 처음 저장할 때 내는 값이다. 에이전트처럼 같은 맥락을 여러 번 보내는 작업에서는 캐시 읽기가 토큰 사용량의 큰 몫을 차지한다.
"평균 약 75% 저렴"은 각주 2에 계산 근거가 있다. Haiku 5.5의 정가는 10만 토큰 이하 요청에서 Haiku 4.5보다 90% 낮고, 10만 토큰 초과 요청에서는 50% 낮다. Haiku 4.5로 들어온 요청의 90%가 10만 토큰 이하였다. 여기에 토크나이저 차이를 반영했다. Haiku 5.5는 Sonnet 5.5, Opus 5.5와 비슷한 새 토크나이저를 써서 같은 작업에 토큰을 조금 더 쓴다. 이 세 가지를 합친 결과가 평균 75% 절감이라는 설명이다.
토큰이 얼마나 더 나오는지는 마이그레이션 가이드가 더 구체적으로 적었다. 같은 입력 텍스트가 Haiku 5.5에서는 Haiku 4.5보다 약 30% 더 많은 토큰으로 계산되며, 정확한 증가 폭은 내용에 따라 다르다. 그래서 Haiku 4.5에서 맞춰 둔 max_tokens 한도나 비용 추정은 Haiku 5.5 기준으로 다시 세는 것이 맞다.
예시 계산
아래는 공식 가격과 마이그레이션 가이드의 "약 30%"를 그대로 대입한 예시 계산이다. 실제 증가 폭은 내용마다 다르므로 감을 잡는 용도로만 본다. 요청 1,000건이 각각 입력 2만 토큰, 출력 1천 토큰이고 캐시는 쓰지 않는다고 가정한다.
| 항목 | Haiku 4.5 | Haiku 5.5 (토큰 30% 증가 가정) |
|---|---|---|
| 입력 토큰 합계 | 2,000만 | 2,600만 |
| 출력 토큰 합계 | 100만 | 130만 |
| 입력 비용 | $20.00 | $2.60 |
| 출력 비용 | $5.00 | $0.65 |
| 합계 | $25.00 | $3.25 (약 87% 절감) |
반대로 요청 하나가 15만 토큰짜리라면 이야기가 달라진다. 시스템 카드 설명대로 Haiku 5.5는 요청마다 그 요청의 프롬프트 길이에 해당하는 요율을 적용하므로, 이 요청은 입력 0.50달러 요율로 계산된다. 토큰이 30% 늘어 19만 5천 토큰이 되면 입력 비용은 약 0.098달러로, Haiku 4.5의 0.15달러보다 약 35% 싼 수준에 그친다. 긴 문서를 통째로 넣는 작업보다 짧게 잘라 보내는 작업에서 Haiku 5.5의 가격 이점이 커지는 이유다.
Sonnet 5.5 캐시 읽기 가격 인하
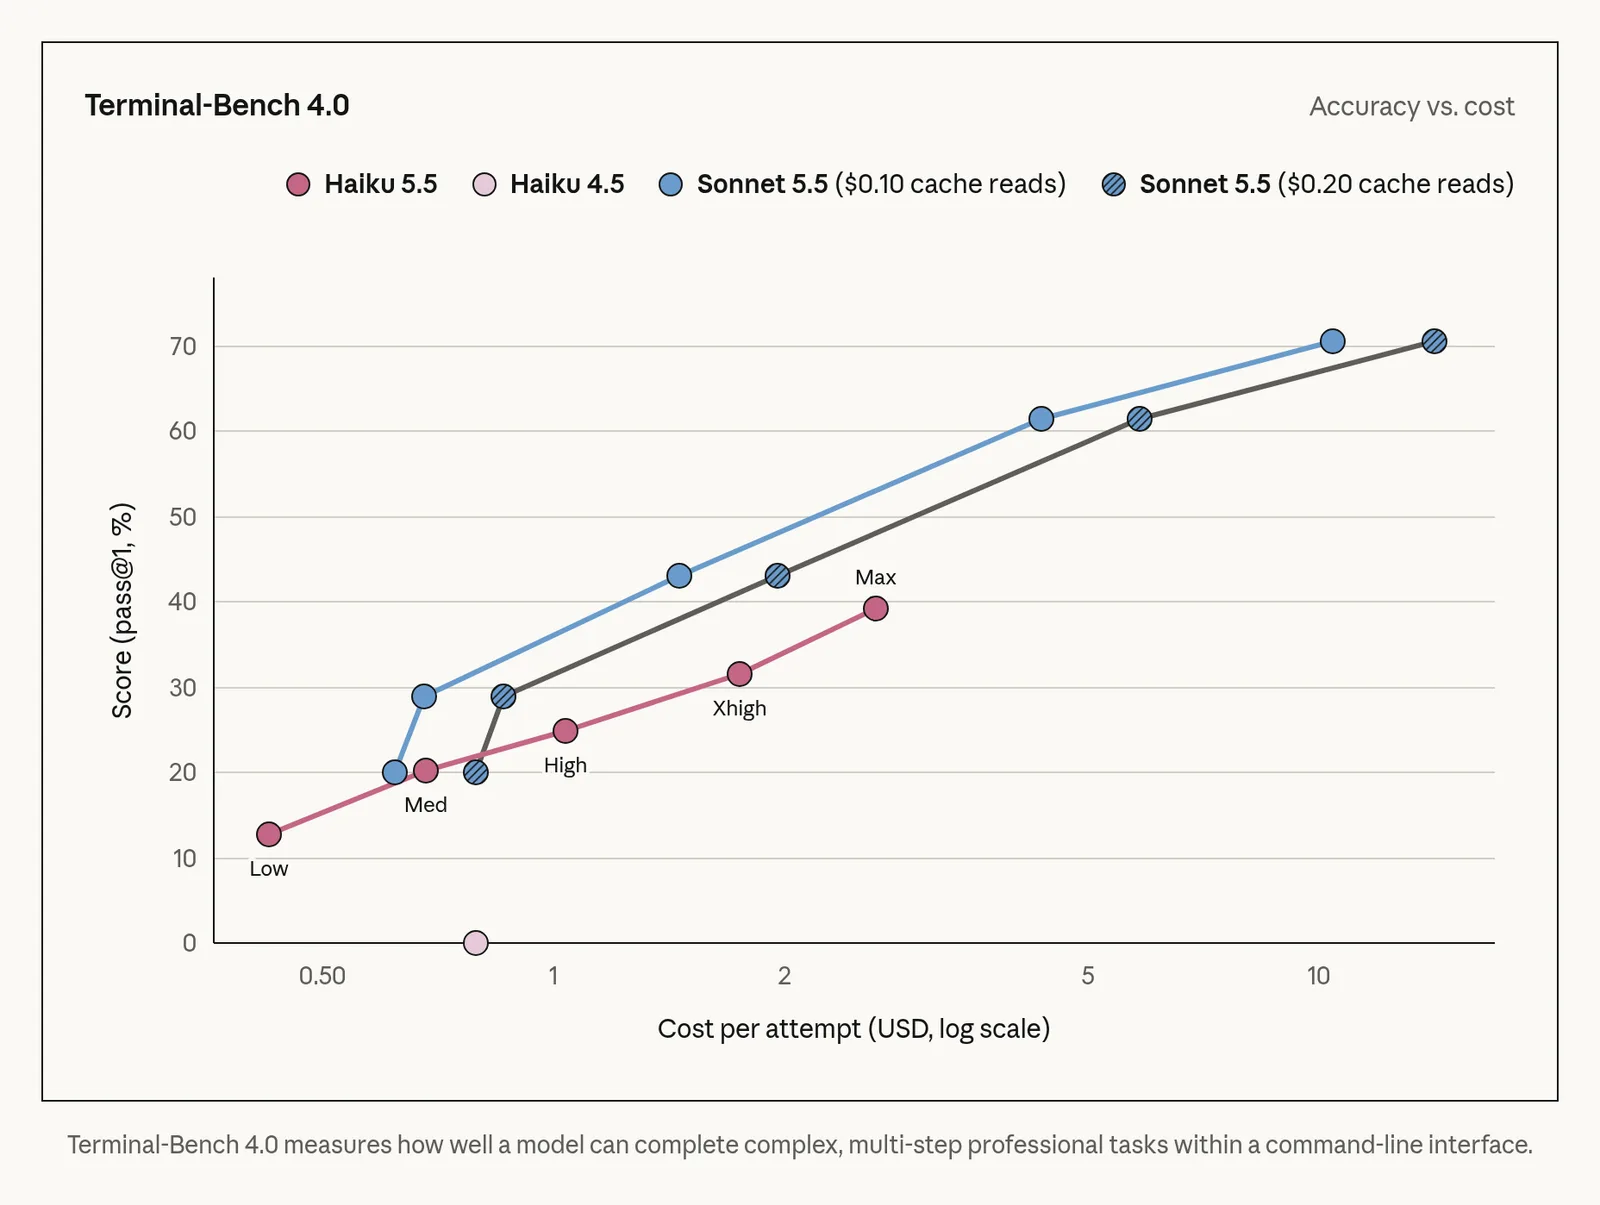
Haiku 5.5 발표와 함께 Anthropic은 Sonnet 5.5의 캐시 읽기 가격을 100만 토큰당 0.20달러에서 0.10달러로 50% 내렸다. 캐시 읽기는 에이전트 작업의 토큰 소비에서 큰 비중을 차지하기 때문에, Anthropic은 이 인하로 대부분의 에이전트 작업에서 Sonnet 5.5 비용이 약 20% 줄어든다고 설명했다. 그래서 위 가격표에서 Sonnet 5.5의 캐시 읽기는 Haiku 4.5와 같은 0.10달러로 적혀 있다.
그림 6은 이 인하를 Terminal-Bench 4.0으로 보여 준다. 진한 빗금 점은 예전 가격(0.20달러), 파란 점은 새 가격(0.10달러)의 Sonnet 5.5인데, 같은 점수를 더 왼쪽, 곧 더 싼 위치에서 낸다. 이 그래프에는 Haiku 5.5 선도 함께 있다. 그래프 눈금으로 읽으면 Sonnet 5.5는 시도당 약 1.5달러 위치에서 이미 40%를 넘는데, Haiku 5.5는 Max 단계에서 약 2.5달러를 쓰고 39.2%에 머문다.
Anthropic은 이 그래프로 Haiku 5.5와 큰 모델의 차이를 직접 설명했다. Sonnet 5.5와 Opus 5.5는 Terminal-Bench 4.0 같은 복잡한 에이전트 코딩에 여전히 더 나은 선택이고, Haiku 5.5는 컴팩션, 요약, 서브에이전트 작업처럼 범위가 좁은 일, 그러니까 이전 Claude로는 비용 때문에 엄두를 못 내던 일에 가장 잘 맞는다는 것이다. 복잡한 코딩을 Haiku로 돌린다고 무조건 싸지는 않다는 점이 숫자로 드러난 셈이다.
Max와 Team 구독자의 월간 API 크레딧
Anthropic은 이번 주 안에 모든 Max와 Team 구독자에게 매달 Claude Platform용 API 크레딧을 나눠 주기 시작한다고 밝혔다. 직접 API를 호출하는 도구, 앱, 에이전트를 만들어 보라는 취지이고, 어떤 Claude 모델에든 쓸 수 있다. 고객센터 문서 기준 금액은 다음과 같다.
| 플랜 | 월 크레딧 |
|---|---|
| Max 5x | $100 |
| Max 20x | $200 |
| Team Standard 좌석 | 좌석당 $20 (팀 전체 합산, 최대 $500) |
| Team Premium 좌석 | 좌석당 $100 (팀 전체 합산, 최대 $500) |
| 할인 Team 플랜(비영리, 과학자) | Standard $20, Premium $100 (합산 최대 $500) |
발표문은 Team을 "최대 500달러, 사용자 간 합산"이라고 요약했고, 고객센터 문서는 좌석별 금액을 더한 뒤 500달러에서 자르는 방식이라고 설명한다. 문서 속 예시로는 Standard 3석과 Premium 2석인 팀이 매달 260달러를 받는다. Free, Pro, Enterprise 플랜은 대상이 아니다.
받는 방법은 claude.ai의 결제 설정에서 Claude Console 조직을 하나 연결하는 것이다. Max는 구독자 본인, Team은 Primary Owner나 Owner가 연결하며, 가입 후 7일이 지나야 받을 수 있다. 연결할 수 있는 Console 조직은 하나뿐이고 직접 바꿀 수 없어서, 실제로 개발할 조직을 골라 연결하는 편이 낫다.
크레딧은 Claude API(Messages API, Message Batches API), Console의 Playground, Claude Managed Agents, Claude Agent SDK에 쓸 수 있다. 터미널, IDE, 데스크톱, 웹에서 대화형으로 쓰는 Claude Code에는 적용되지 않고, Amazon Bedrock이나 Google Cloud Vertex AI, Microsoft Foundry를 거친 사용에도 쓰이지 않는다. 남은 크레딧은 다음 달로 넘어가지 않고, 구매한 크레딧보다 먼저 차감된다.
SDK의 컴퓨터 사용, 브라우저 사용 베타
개발자용으로는 Claude Python SDK와 TypeScript SDK에 컴퓨터 사용(computer use)과 브라우저 사용(browser use) 지원이 베타로 추가됐다. Anthropic은 속도, 성능, 가격의 조합 때문에 Haiku 5.5가 이 작업에 특히 잘 맞는다고 설명했다.
Claude Platform 문서를 보면 구조는 이렇다. SDK에 브라우저 툴셋 클래스(BetaAbstractBrowserToolset20260801)와 컴퓨터 툴셋 클래스(BetaAbstractComputerToolset20260801)가 들어 있고, 개발자는 이 클래스를 상속해 navigate, screenshot, left_click 같은 동작을 자기 브라우저 자동화 코드(예: Playwright)에 맞춰 구현한다. SDK는 각 호출을 해당 메서드로 보내고, 정책 검사와 승인 콜백을 돌리고, 결과를 모델에 돌려줄 형식으로 만든다. 브라우저 자체나 완성된 드라이버는 SDK에 들어 있지 않다.
문서가 강조하는 안전장치도 함께 봐 둘 만하다. URL 정책을 직접 작성하지 않으면 SDK는 어떤 URL도 검사하지 않는다. javascript_exec와 file_upload 동작은 기본으로 꺼져 있고, 켜려면 사람에게 확인을 받는 confirm 콜백이 필요하다. 문서는 브라우저를 세션마다 별도 컨테이너나 VM에서 돌리고, 맡기기 싫은 계정에 로그인된 브라우저 프로필은 쓰지 말라고 안내한다. 파트너 연동으로는 Browser Use, Browserbase, E2B가 소개돼 있다.
마이그레이션 가이드에 따르면 Claude API와 Google Cloud에서 Haiku 5.5의 컴퓨터 사용은 computer_toolset_20260801 툴셋으로만 지원되고, 예전 computer_20250124 도구를 선언하면 400 에러가 난다. 웹페이지 안의 작업을 위한 브라우저 사용 도구(browser_toolset_20260801)는 Haiku 5.5에서 새로 지원되며 Haiku 4.5에는 없었다.
Haiku 4.5에서 옮길 때 바뀌는 점
Haiku 4.5를 쓰던 코드는 모델 ID만 바꿔서는 그대로 돌아가지 않을 수 있다. 마이그레이션 가이드가 정리한 주요 변경 사항은 다음과 같다.
| 항목 | Haiku 4.5 | Haiku 5.5 |
|---|---|---|
| 생각(thinking) 설정 | enabled + budget_tokens | adaptive + output_config.effort. 예전 방식은 400 에러 |
| 샘플링 파라미터 | temperature, top_p, top_k 사용 가능 | 빼는 것이 원칙. temperature는 1, top_p는 0.99만 허용, top_k는 에러 |
| 어시스턴트 프리필 | 생각이 꺼져 있으면 허용 | 거부(400). 마지막 메시지는 사용자 턴이어야 함 |
| 토큰 수 | 기준 | 같은 텍스트에 약 30% 더 많음 |
| 생각 블록 기본 표시 | 요약된 생각 반환 | 내용이 빈 블록과 서명만 반환 |
| 컴퓨터 사용 | computer_20250124 | computer_toolset_20260801 |
| 안전 분류기 거절 | 해당 없음 | stop_reason: refusal 처리 필요, 서버 측 대체 모델 없음 |
프리필을 출력 형식 고정용으로 쓰던 경우에는 구조화 출력(structured outputs)이나 enum 필드를 가진 도구로 바꾸라고 가이드는 안내한다. 분류 작업처럼 Haiku를 많이 쓰는 용도에서 자주 걸리는 부분이다. 응답의 첫 번째 블록을 답으로 읽던 코드도 고쳐야 한다. 적응형 생각이 기본으로 켜져 있어 응답이 thinking 블록으로 시작할 수 있기 때문에, 블록을 위치가 아니라 type으로 골라야 한다.
Claude Code를 쓴다면 번들된 Claude API 스킬로 이 작업을 자동화할 수 있다. 가이드에 실린 명령은 아래와 같고, 스킬은 수정 범위를 먼저 확인한 뒤 모델 ID 교체와 파라미터 변경을 적용하고 수동 확인 목록을 만들어 준다.
/claude-api migrate this project to claude-haiku-5-5안전성과 사용 제한
Anthropic은 Haiku 5.5가 Haiku 4.5보다 거의 모든 정렬(alignment) 평가에서 크게 개선됐다고 밝혔다. 잘못 정렬된 행동 사례가 훨씬 적었고, 오용에 협조하려는 경향도 낮았다. 평가 과정과 결과는 시스템 카드에 자세히 실려 있다.
사이버보안 안전장치는 모델 능력에 맞춰 Haiku 4.5보다 엄격하게 잡았지만, 최근 다른 모델에 적용한 것보다는 다소 느슨하다. 방어 목적 작업은 Sonnet 5.5의 안전장치보다 넓게 허용하면서도, 침투 테스트처럼 공격자가 쓸 가능성이 큰 기법은 여전히 막는다. 생물학 안전장치는 Sonnet 5, Sonnet 5.5, Opus 5와 같다. 연구용 생물학 질문은 허용하되 해를 끼칠 가능성이 높다고 판단되는 요청은 제한한다.
더 넓은 범위의 생물학, 사이버 작업을 해야 하는 조직은 Life Sciences Verification Program과 Cyber Verification Program에 신청할 수 있다. 개발 관점에서는 이 안전장치가 실제 응답에도 영향을 준다는 점이 중요하다. 마이그레이션 가이드는 Haiku 5.5가 요청을 거절할 수 있는 안전 분류기를 돌리며 서버 측 대체 모델이 없으므로, refusal 정지 사유를 코드에서 처리하라고 안내한다.
초기 고객 반응
발표문에는 출시 전 Haiku 5.5를 시험한 기업들의 평가가 실려 있다. Asana의 Aaron Vinh(Staff Software Engineer)은 "Claude Haiku 5.5, 특히 그 속도에 매우 깊은 인상을 받았다"며, 자사 AI 에이전트 제품 AI Teammates의 평가 묶음(버그 분류, 프로젝트 설정, 큰 포트폴리오에서 위험하거나 기한이 지난 작업 찾기)에서 지금 쓰는 모델보다 작업 완료 지연이 30% 넘게 줄고 에이전트 턴당 추론이 최대 2.5배 빨라졌다고 전했다.
다른 기업들의 숫자도 쓰임새를 가늠하는 데 도움이 된다. 아래는 발표문에 실린 인용을 요약한 것이다.
| 기업 | 사용 맥락 | 발표문에 실린 결과 |
|---|---|---|
| HubSpot | 모의 CRM 포털 평가 | 이 평가에서 본 최고 점수 92.8%(3회 평균). 오래되고 애매한 레코드 찾기에서 가장 빠르고 적중률 최고, 오탐률 최저 |
| AlphaSense | 문서 한두 개 위 질의응답(주 약 800만 호출) | 400개 질의에서 Haiku 4.5 대비 0.84 대 0.76, 통계적으로 유의한 개선 |
| Box | 대량 기업 문서 분석 | Haiku 4.5보다 11점 높고 지연은 약 절반 |
| Rogo | 짧고 많은 조회, 서브에이전트, 요약 | 큰 모델이 자료를 만드는 동안 Haiku 5.5 서브에이전트가 10-K에서 필요한 부문별 매출 줄을 찾아옴 |
| Cognition | Devin Fusion의 보조(sidekick) 모델 | Haiku 5.5를 보조로 쓴 Fusion이 FrontierCode 66.2점을 유지하면서 비용과 지연 감소. Devin CLI에서 Opus 5.5를 리더로 사용 가능 |
바이브 코더를 위한 Haiku 5.5, Sonnet 5.5, Opus 5.5 나눠 쓰기
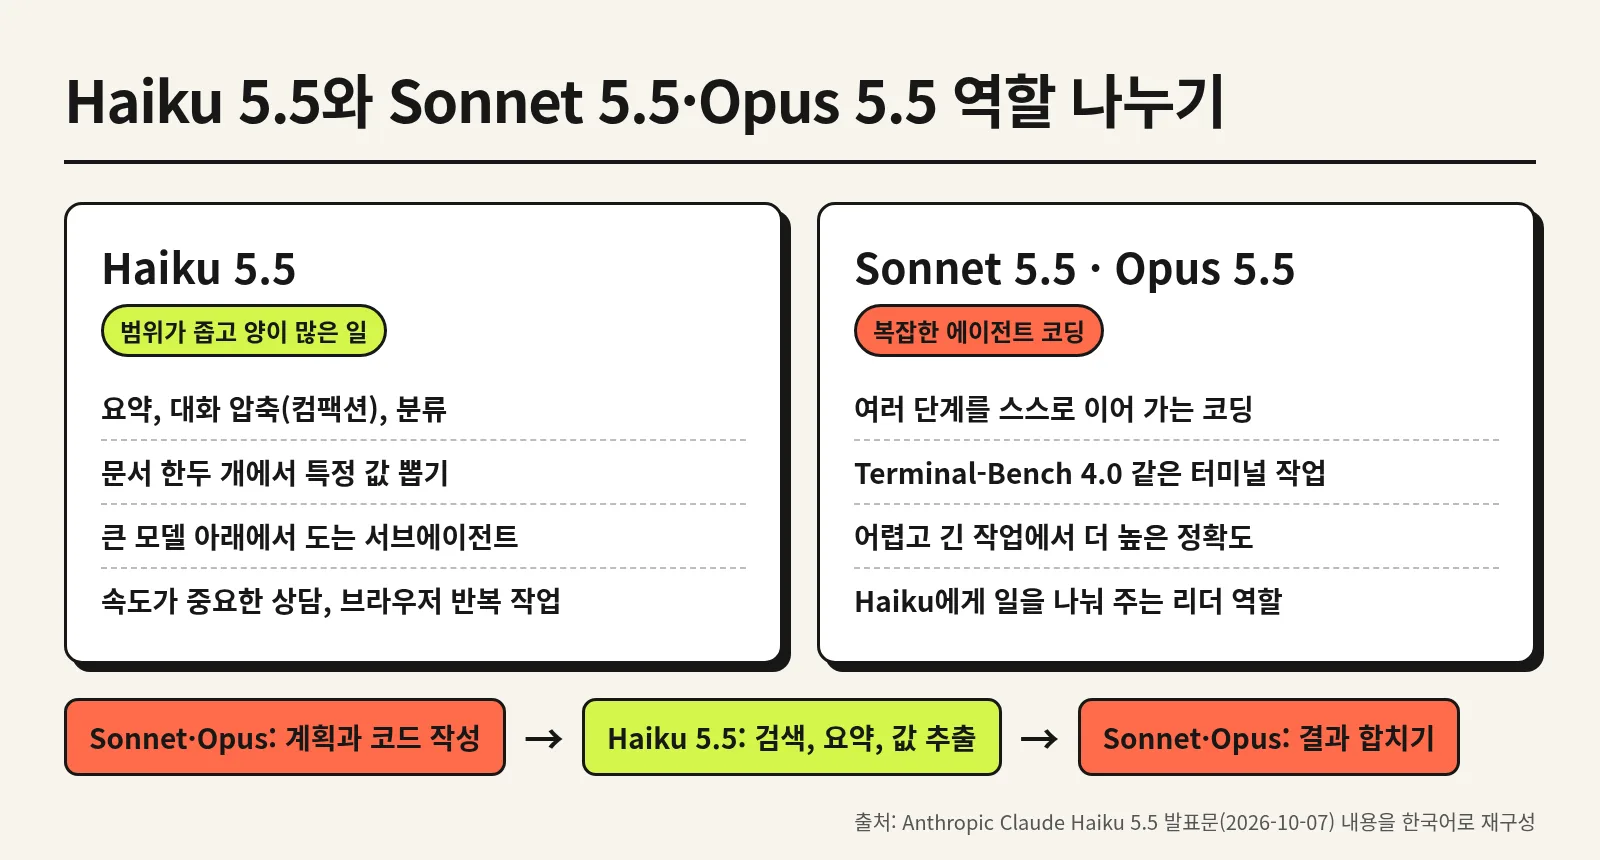
Anthropic의 기준은 명확하다. 복잡한 에이전트 코딩은 Sonnet 5.5와 Opus 5.5가 더 낫고, Haiku 5.5는 범위가 좁고 양이 많은 일에 맞는다. 바이브 코딩, 그러니까 AI에게 말로 지시해 앱을 만드는 작업에 이 기준을 대입하면 "Haiku로 전부 바꾼다"가 아니라 "큰 모델 옆에 Haiku를 붙인다"가 기본 그림이 된다. 아래 흐름은 모두 발표문과 공식 문서에 나온 쓰임새를 바탕으로 한 예시다.
리더와 서브에이전트 조합
첫 번째는 Rogo와 Cognition이 소개한 방식이다. 기능 구현과 설계 판단은 Opus 5.5나 Sonnet 5.5가 맡고, 문서 검색, 긴 로그 요약, 특정 값 추출처럼 결과만 돌려주면 되는 일은 Haiku 5.5 서브에이전트에게 넘긴다. 서브에이전트는 자주, 많이 호출되기 때문에 단가 차이가 전체 비용에 바로 반영된다. Cognition은 Opus 5.5를 리더로, Haiku 5.5를 보조로 둔 구성에서 FrontierCode 66.2점을 유지하면서 비용과 지연을 줄였다고 밝혔다. 66.2점은 Opus 5.5 리더와 함께 낸 점수라 Haiku 5.5 단독 점수(46.4%)와 같은 선에서 비교할 수는 없다. 다만 보조 자리에 싼 모델을 넣고도 상위권 점수가 유지됐다는 점이 이 조합의 요지다.
앱 안에서 대량으로 도는 기능
두 번째는 직접 만든 앱 안에서 반복 호출되는 기능이다. 사용자 문의를 카테고리로 나누기, 리뷰 감정 분류, 업로드된 문서 요약, 긴 채팅 기록 압축 같은 기능은 요청 하나가 짧고 건수가 많다. 가격표 기준으로 10만 토큰 이하 요청이 Haiku 5.5의 가장 싼 구간이고, AlphaSense처럼 "문서 한두 개 위에서 아주 구체적인 질문에 답하는" 용도가 발표문의 대표 사례다. 분류 결과를 정해진 형식으로 받으려면 프리필 대신 구조화 출력이나 enum 도구를 쓰는 것이 Haiku 5.5의 방식이다.
브라우저 반복 작업과 실시간 응답
세 번째는 속도가 중요한 작업이다. 새 SDK 브라우저 툴셋에 Haiku 5.5를 붙이면 웹페이지를 열고 값을 읽고 버튼을 누르는 반복 작업을 자동화할 수 있다. 이때 URL 정책, 격리된 브라우저, 위험한 동작의 사람 승인은 문서가 요구하는 기본값이다. 고객 상담 챗봇처럼 사용자가 답을 기다리는 화면도 Anthropic이 직접 꼽은 쓰임새다.
노력 단계 고르기
노력 단계는 작업의 난도에 맞춰 고른다. 시스템 카드 수치를 보면 기본값 medium은 Max보다 점수가 낮지만 출력 토큰을 훨씬 적게 쓴다. 단순 분류나 짧은 요약은 낮은 단계로 시작해 결과를 보고 올리고, 컴퓨터 조작이나 여러 단계 추론이 필요한 일은 높은 단계를 쓰는 식이다. 그래도 점수가 모자라면 Haiku의 단계를 끝까지 올리기보다 Sonnet 5.5로 넘기는 편이 쌀 수 있다는 것이 그림 6의 Terminal-Bench 그래프가 보여 주는 내용이다.
| 작업 예 | 권장 모델 | 근거 |
|---|---|---|
| 새 기능 설계, 여러 파일 수정, 터미널 작업 | Sonnet 5.5 또는 Opus 5.5 | Terminal-Bench 4.0 70.6%(Sonnet), 66.4%(Opus) 대 39.2%(Haiku) |
| 문서 검색, 값 추출, 로그 요약을 맡는 서브에이전트 | Haiku 5.5 | 발표문의 서브에이전트 용도, Rogo와 Cognition 사례 |
| 긴 에이전트 대화 압축(컴팩션) | Haiku 5.5 | 발표문이 비용 때문에 어려웠던 대표 작업으로 꼽음 |
| 앱 안의 대량 분류, 요약 | Haiku 5.5 (낮은 노력 단계부터) | 10만 토큰 이하 입력 $0.10, 출력 $0.50 |
| 브라우저 반복 작업, 실시간 상담 | Haiku 5.5 | 표준 속도 기준 가장 빠른 모델, SDK 브라우저 툴셋 베타 |
핵심 포인트: Haiku 5.5의 가격 이점은 짧은 요청을 많이 보낼 때 가장 크다. 복잡한 코딩을 Haiku로 옮기는 것보다, 큰 모델이 하던 잔일을 Haiku로 떼어 내는 쪽이 공식 수치와 맞는 사용법이다.
마무리
앞에서 다룬 Claude Haiku 5.5의 핵심만 짧게 정리한다.
- Claude Haiku 5.5는 2026년 10월 7일 공개된 Anthropic의 소형 모델이며, 모델 ID는
claude-haiku-5-5다. - 요약, 컴팩션, 분류, DB 조회, 서브에이전트, 실시간 상담, 브라우저 사용처럼 짧고 반복되는 일에 맞춰 설계됐다.
- 벤치마크에서 Haiku 4.5를 크게 앞섰고(Terminal-Bench 0.0%에서 39.2%, OSWorld 15.7%에서 72.4%), GPT-6 Luna보다도 높았지만 복잡한 코딩은 Sonnet 5.5와 차이가 크다.
- Haiku 최초로 Low부터 Max까지 노력 설정이 생겼고, 기본값은 medium이다.
- 가격은 10만 토큰 이하에서 입력 $0.10, 출력 $0.50으로 Haiku 4.5 대비 평균 약 75% 싸졌지만, 같은 텍스트가 약 30% 더 많은 토큰으로 계산된다.
- Sonnet 5.5 캐시 읽기는 $0.10으로 내려갔고, Max와 Team 구독자는 매달 $100에서 최대 $500의 API 크레딧을 받는다.
「큰 모델은 판단을, Haiku 5.5는 양을 맡긴다」 지금 쓰는 에이전트에서 요약이나 검색처럼 반복되는 단계를 하나 골라 Haiku 5.5로 바꿔 보고, 비용과 결과를 이전과 비교해 보는 것이 가장 안전한 시작이다.
출처와 링크
조사 기준: 2026년 10월 8일(KST). 벤치마크 표와 가격표 수치는 아래 공식 발표문에서 옮겼고, 시스템 카드 요약표와 대조했다.
- Anthropic 발표문 「Claude Haiku 5.5」(2026-10-07): https://www.anthropic.com/claude-haiku-5-5
- Claude Haiku 5.5 시스템 카드: https://www.anthropic.com/claude-haiku-5-5-system-card
- Claude Haiku 5.5 마이그레이션 가이드: https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- Claude 고객센터 「Monthly API credits for Max and Team plans」: https://support.claude.com/en/articles/17154008
- Claude Platform 문서 「Browser use SDK」: https://platform.claude.com/docs/en/agents-and-tools/tool-use/browser-use-sdk
- Anthropic Cyber Verification Program: https://www.anthropic.com/news/cyber-verification-program
- Anthropic Life Sciences Verification Program: https://www.anthropic.com/news/life-sciences-verification-program
본문의 그림 2부터 그림 6까지는 Anthropic 공식 발표 페이지(anthropic.com/claude-haiku-5-5)를 캡처한 원본이며, 그림 1과 그림 7은 같은 발표문 내용을 한국어로 다시 그린 것이다.
FAQ
자주 묻는 질문
Claude Haiku 5.5에서 Priority Tier를 쓸 수 있나요?
마이그레이션 가이드에 따르면 Priority Tier는 Claude Haiku 5.5에서 지원되지 않는다. Haiku 4.5에 Priority Tier 약정을 걸어 둔 조직은 Haiku 5.5로 옮길 때 처리 용량 계획을 따로 세워야 한다.
Haiku 5.5의 생각(thinking) 내용을 요약본으로 받을 수 있나요?
기본값에서는 thinking 블록의 내용이 비어 있고 서명만 돌아온다. 요약된 생각을 받으려면 thinking 값을 type adaptive에 display summarized를 더해 보내면 된다고 마이그레이션 가이드는 설명한다.
Haiku 5.5에서 tool_choice로 특정 도구를 강제하면 어떻게 되나요?
any나 특정 도구 이름으로 강제하는 것은 허용되지만, 이때 응답은 도구 호출로 바로 시작하고 thinking 블록이 붙지 않는다. 도구를 부르기 전에 생각하게 하려면 tool_choice를 auto로 두고 프롬프트에서 언제 도구를 쓸지 설명하라고 가이드는 안내한다.
Pro 요금제 사용자도 월간 API 크레딧을 받을 수 있나요?
받을 수 없다. 고객센터 문서 기준으로 대상은 Max와 Team(할인 Team 포함)뿐이고 Free, Pro, Enterprise는 제외된다. 크레딧 신청은 모바일로 가입했더라도 웹 브라우저의 claude.ai에서 해야 하며, Console에 결제 수단을 등록하지 않아도 된다.
월간 API 크레딧을 다 쓰면 Claude 구독 요금으로 청구되나요?
청구되지 않는다. 연결한 Console 조직에 구매한 크레딧이나 자동 충전이 있으면 그쪽에서 이어서 차감되고, 없으면 다음 달 크레딧이 들어올 때까지 API 요청이 멈춘다. Anthropic 영업팀을 통해 인보이스를 받는 조직이면 초과분이 평소처럼 청구된다.
Haiku 5.5가 안전 분류기 때문에 작업을 멈추는 일이 실제로 있나요?
시스템 카드의 Terminal-Bench 4.0 평가에서 Haiku 5.5는 대체 모델 없이 돌렸고, 안전장치가 요청을 걸러 시도가 중단된 경우가 전체 660회 중 12회(1.8%)였다. 그중 10회가 한 과제에 몰려 있었고 해당 시도는 모두 실패로 처리됐다.
저장해 둔 대화를 다른 계정으로 다시 보내도 Haiku 5.5의 생각 블록이 유지되나요?
유지되지 않는다. Haiku 5.5의 thinking 블록은 그것을 만든 계정이나 연결된 계정에서만 작동하고, 다른 계정이 보내면 API가 그 블록을 버린 채 요청을 처리한다. 여러 고객을 한 대화 저장소로 처리하는 서비스라면 대화마다 원래 계정으로 다시 보내야 한다.
Haiku 5.5에서 대화 중간에 시스템 프롬프트를 바꿔도 되나요?
thinking 블록을 다시 보내는 대화라면 system, tools, 이전 messages를 바꾼 뒤 그 블록을 보내면 400 에러가 난다. 그래서 대화는 뒤에 덧붙이기만 하는 방식으로 유지하라고 가이드는 권한다. 2026년 8월 31일 0시(UTC) 이전에 만든 계정은 특정 설정을 넣은 요청에서만 이 에러가 난다.
용어
관련 용어
Anthropic이 개발한 AI 모델 시리즈로, 안전성(safety), 정직성(honesty), 유용성(helpfulness)을 핵심 원칙으로 설계되었다. 바이브 코딩에서 가장 널리 사용되는 모델 중 하나이며, 깊은 코드 이해, 상세한 설명 생성, 100만 토큰의 업계 최대급 컨텍스트 윈도우가 주요 강점이다. 현재 Claude 4 패밀리로 구성되어 있으며, Claude Opus 4.6(가장 강력한 최상위 모델), Claude Opus 4.5, Claude Opus 4.1, Claude Opus 4, Claude Sonnet 4의 다섯 가지 모델이 있다. Opus 계열은 복잡한 추론과 대규모 코드 분석에, Sonnet 계열은 빠른 응답과 비용 효율에 최적화되어 있다. Claude Code(CLI 도구)를 통해 터미널에서 직접 사용하거나, Cursor·Windsurf 등 제3자 IDE에서 모델로 선택할 수 있다. API 모델 문자열은 'claude-opus-4-6'이며, 웹·모바일·데스크톱 채팅 인터페이스를 통해서도 접근 가능하다. Constitutional AI라는 독자적인 안전 기술로 유해한 출력을 최소화하면서도 유용한 코드 생성을 유지하는 것이 특징이다.
성능·최적화 지연시간요청을 보낸 후 응답을 받기까지 걸리는 시간으로, AI 코딩 도구에서는 프롬프트를 전송한 후 코드가 생성되기 시작할 때까지의 대기 시간을 의미한다. 밀리초(ms)에서 수 초(s)까지 다양하며, 개발자의 작업 흐름과 생산성에 직접적 영향을 미친다. AI 모델의 지연시간은 여러 요인에 의해 결정된다: 모델 크기(파라미터 수가 많을수록 느림), 입력 토큰 수(컨텍스트가 길수록 느림), 출력 토큰 수(긴 응답일수록 느림), 서버 부하(동시 사용자 수), 네트워크 거리(API 서버 위치). 바이브 코딩에서의 트레이드오프: Claude Opus 4.6은 가장 정확한 코드를 생성하지만 응답이 느리고, Codex mini나 Claude Sonnet은 빠르지만 복잡한 작업에는 부족하다. 이로 인해 많은 개발자가 '빠른 모델로 초안 생성 → 정확한 모델로 검증·수정'이라는 이중 모델 전략을 사용한다. 스트리밍 응답(streaming)은 전체 응답을 기다리지 않고 토큰이 생성되는 대로 표시하여 체감 지연을 줄이는 기법이며, 대부분의 AI 코딩 도구에서 기본으로 사용된다.
비즈니스·수익화 토큰 기반 과금AI 서비스의 사용량을 토큰(입력 토큰 + 출력 토큰)으로 측정하여 과금하는 비즈니스 모델로, AI API 서비스의 가장 기본적인 과금 방식이다. Claude API, OpenAI API 등이 이 모델을 사용하며, 일반적으로 입력 토큰보다 출력 토큰의 단가가 더 높다(모델이 새로운 토큰을 '생성'하는 것이 기존 토큰을 '읽는' 것보다 더 많은 연산을 필요로 하기 때문). 바이브 코딩의 비용이 예상보다 높아질 수 있는 주요 원인이 토큰 기반 과금이다. 그 이유: 대규모 코드베이스를 컨텍스트로 제공하면 입력 토큰이 급증하고, AI가 긴 코드를 생성하면 출력 토큰이 급증하며, 에이전틱 워크플로에서 여러 번의 반복(수정 → 테스트 → 수정)이 일어나면 누적 비용이 기하급수적으로 증가한다. 비용 관리 전략: 컨텍스트 엔지니어링으로 불필요한 입력 줄이기, 작은 모델(Sonnet, mini)을 기본으로 사용하고 복잡한 작업에만 큰 모델(Opus) 사용, 캐싱을 활용하여 동일한 컨텍스트의 재전송 방지 등.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
GPT-6 Sol과 Luna | OpenAI API 50% 인하와 비용-지능 곡선
OpenAI는 2026년 9월 초에 GPT-6 플래그십 Astra를 공개한 뒤, 같은 달 후반에 GPT-6 Sol과 GPT-6 Luna를 추가했다. 공식 발표문은 Astra와 비슷한 학습·정렬 방법을 더 빠르고 저렴한 티어에 옮겨, 비용-지능 곡선의 앞쪽을 채우는 모델이라고 적는다. 조사 기준일은 2026년 9월 23일 Asia/Seoul이다. 발표일 표기는 OpenAI 개발자 커뮤니티와 2차 보도 기준으로 2026년 9월 22일이다.
API 표준 가격은 GPT-5.6 시대의 프로모션 가격 대비 Sol·Luna 모두 약 50% 인하됐다. Sol은 입력 $4→$2, 출력 $20→$10(1M 토큰). Luna는 입력 $0.20→$0.10, 출력 **$1.20→$0.50…
Hermes 모델 제공자 | 보조 슬롯 11개와 64K 컨텍스트
Hermes Agent에서 provider 이름을 바꿔도 청구서가 거의 그대로인 경우가 많다. 이유는 벤치마크 순위가 아니라 설정 구조에 있다. 보조 작업 슬롯이 기본값 auto로 메인 모델을 그대로 쓰고, 컨텍스트 압축은 기본 50% 근처에서 걸리며, /model 전환이나 폴백이 한 번 일어나면 프롬프트 캐시가 깨져 다음 요청이 대화를 정가로 다시 읽는다.
세션 제목 생성, 압축, 승인 판정, 웹 추출처럼 사소해 보이는 작업이 같은 고가 모델을 물고 들어가면, OpenRouter를 Anthropic으로, Anthropic을 Portal로 갈아탔다고 생각하는데 실제 과금 구조는 거의 남는다. 반대로 로컬 모델로 비용을 아끼려 해도 컨텍스트가 부족하면 시작 단계에서 거부된다.
원문과 공식 Quickstart는 Hermes가 **64…