바이브코딩
Kokoro 82M TTS 사용법 | 무료 오픈 웨이트 영어 음성 모델의 윈도우 설치, API 가격, 한국어 지원
hexgrad가 만든 8,200만 파라미터 TTS가 무엇이고 왜 작은데 소리가 좋은지, 54개 보이스와 블렌딩, 윈도우 pip, ONNX, 도커 설치, 오픈라우터 API와 kokoro.js, 다른 TTS와의 비용 비교와 한계
Kokoro 82M은 영어 문장을 넣으면 사람 목소리에 가까운 음성 파일을 만들어 주는 TTS(Text-to-Speech) 모델이다. hexgrad라는 이름의 개발자가 만들었고, 파라미터가 8,200만 개뿐이라 모델 파일이 약 327MB에 그친다. 그래픽카드 없는 노트북에서도 돌아가고, 가중치가 Apache 2.0 라이선스로 공개되어 있어 유튜브 내레이션이나 상업용 앱에 넣어도 사용료를 따로 내지 않는다.
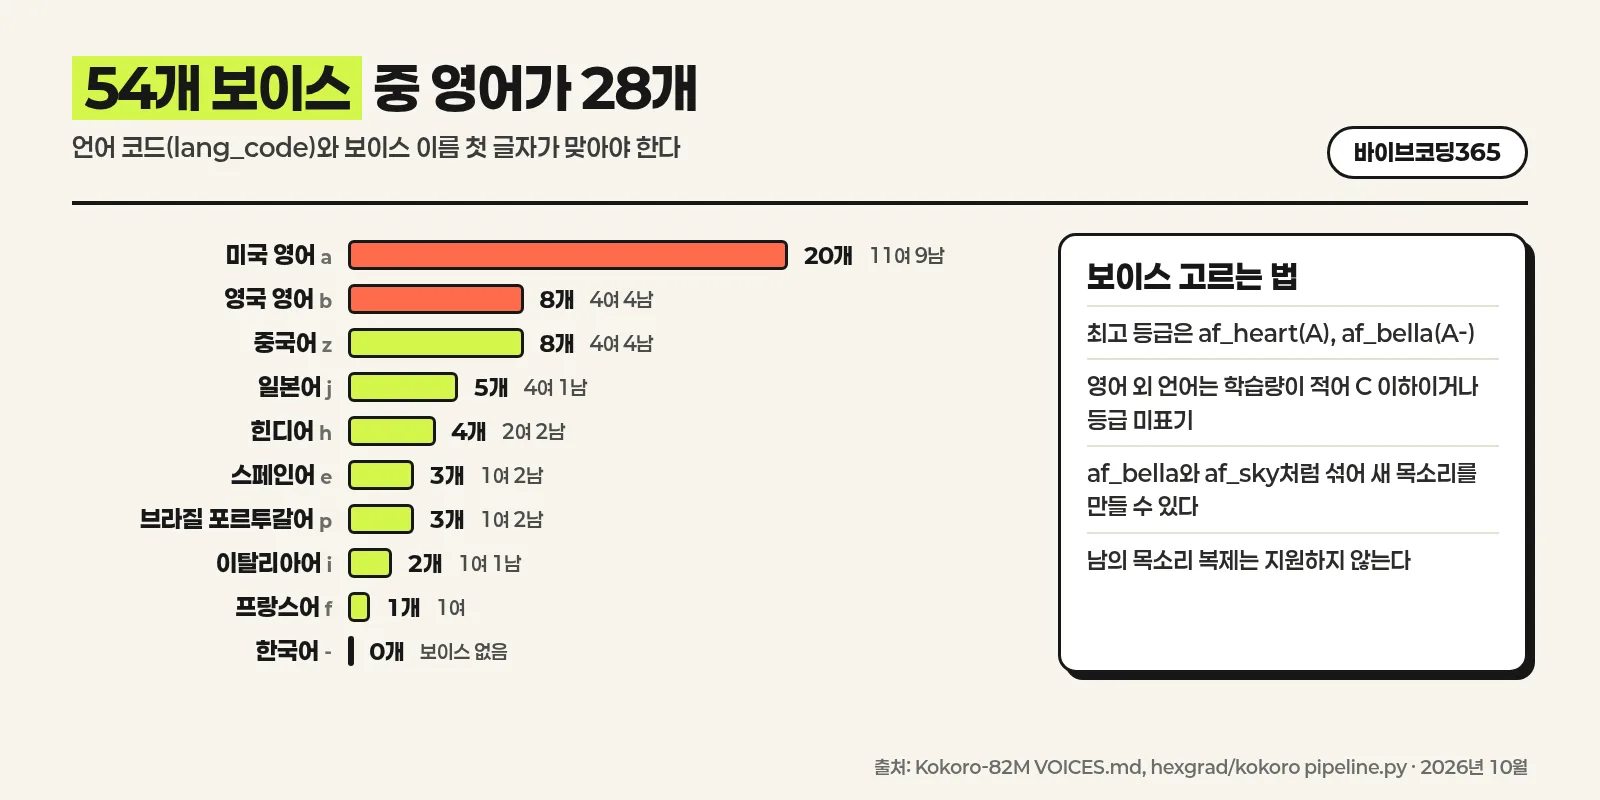
첫 공개는 2024년 12월 25일 v0.19였고, 지금 쓰이는 v1.0은 2025년 1월 27일에 나왔다. 미국 영어와 영국 영어를 중심으로 일본어, 중국어, 스페인어, 프랑스어, 힌디어, 이탈리아어, 브라질 포르투갈어까지 8개 언어(영어를 미국과 영국으로 나누면 9개 묶음)에 보이스 54개가 들어 있다. 한국어 보이스는 없다.
나온 지 거의 2년이 된 작은 모델이지만 사용량은 여전히 상위권이다. 2026년 10월 18일 0시 27분(한국 시간) 오픈라우터(OpenRouter) Speech 탭을 주간 사용량순으로 정렬하면 35개 음성 모델 가운데 4위로, 주간 3,740만 토큰을 처리했다. 허깅페이스의 지난 한 달 다운로드는 1,056만 회다. 오픈라우터에서 부르는 가격은 100만 자당 0.62달러로, 유료 TTS 중 가장 싸다.
아래에서는 Kokoro 82M이 무엇이고 왜 작은데도 소리가 좋은지, 언어와 보이스, 윈도우 설치 세 가지 방법, 오픈라우터 API와 브라우저 실행, 다른 TTS와의 비용 차이, 그리고 쓰기 좋은 곳과 한계를 차례로 다룬다. 숫자는 모두 2026년 10월 18일 조회값이다.
Kokoro 82M은 무엇을 하는 모델인가
Kokoro 82M은 글을 목소리로 바꾸는 음성 합성 모델이다. 대본을 텍스트로 넣고 보이스 이름 하나를 고르면 24kHz 음성 파일이 나온다. 챗GPT 같은 대화형 AI가 아니라, 이미 써 둔 문장을 소리 내어 읽는 일만 한다. 이름의 코코로(心)는 일본어로 "마음"이라는 뜻이다.
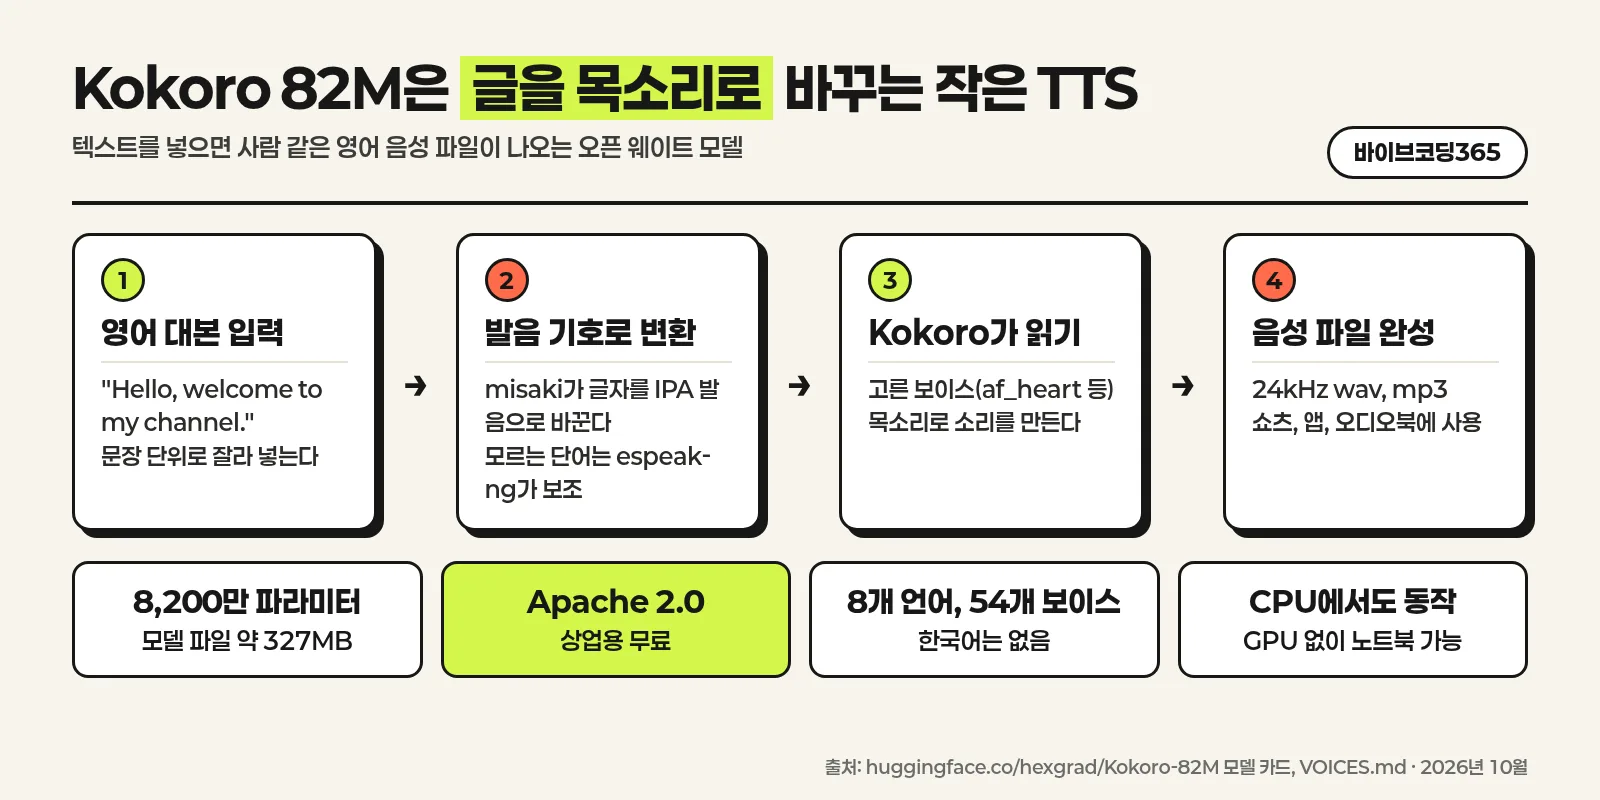
읽는 과정은 두 단계로 나뉜다. 먼저 misaki라는 발음 변환기(G2P)가 "Hello"를 "həlˈoʊ" 같은 국제 음성 기호로 바꾸고, 사전에 없는 단어는 오픈소스 발음 엔진 espeak-ng가 대신 처리한다. 그다음 Kokoro 모델이 이 발음 기호를 받아 고른 보이스의 말투로 소리를 만든다. 텍스트를 바로 소리로 바꾸지 않고 발음 기호를 거치기 때문에, 대본 안에 Kokoro처럼 단어 옆에 발음을 직접 적어 읽는 법을 고칠 수도 있다.
바이브 코더 입장에서 기억할 특징은 다섯 가지다.
- 무료 오픈 웨이트: Apache 2.0이라 상업용 서비스에 넣어도 된다. 모델 카드도 "실제 서비스 배포를 환영한다"고 적었다.
- 가벼움: 원본 모델 파일 327MB, ONNX 양자화판은 88~92MB다. CPU만으로 실시간보다 빠르게 읽는다.
- 54개 기본 보이스: 영어 28개가 중심이고, 보이스 두세 개를 섞어 새 목소리를 만들 수 있다.
- 여러 실행 방법: 파이썬 패키지, ONNX, 도커 서버, 브라우저용 자바스크립트, 유료 API까지 같은 모델을 여러 경로로 부른다.
- 영어 중심: 한국어 보이스가 없고, 남의 목소리를 복제하는 기능도 없다.
Better Stack 채널은 Kokoro를 로컬에서 직접 돌려 보며 유료 TTS API와 소리를 비교했다. 작은 모델이 어느 정도 소리를 내는지 먼저 들어 보기에 좋다.
영상 1. 8,200만 파라미터 Kokoro를 로컬에서 돌려 유료 TTS API와 비교한 영상. 출처: YouTube Better Stack
핵심 포인트: Kokoro 82M은 "영어 대본을 무료로, 빠르게, 내 컴퓨터에서 읽어 주는 작은 성우"에 가깝다. 감정 연기나 목소리 복제보다는 깔끔한 내레이션과 앱 음성 안내에 맞는다.
지금 알아둘 것: 무료로 쓰는 길, 가격, 제한
Kokoro를 쓰는 길은 크게 세 가지다. 내 PC에 설치해 무료로 무제한 돌리는 방법, 웹페이지 방문자의 브라우저에서 돌려 서버 비용을 없애는 방법, 그리고 오픈라우터 같은 API로 돈을 내고 빌려 쓰는 방법이다. 결과물은 모두 같은 v1.0 모델의 소리다.
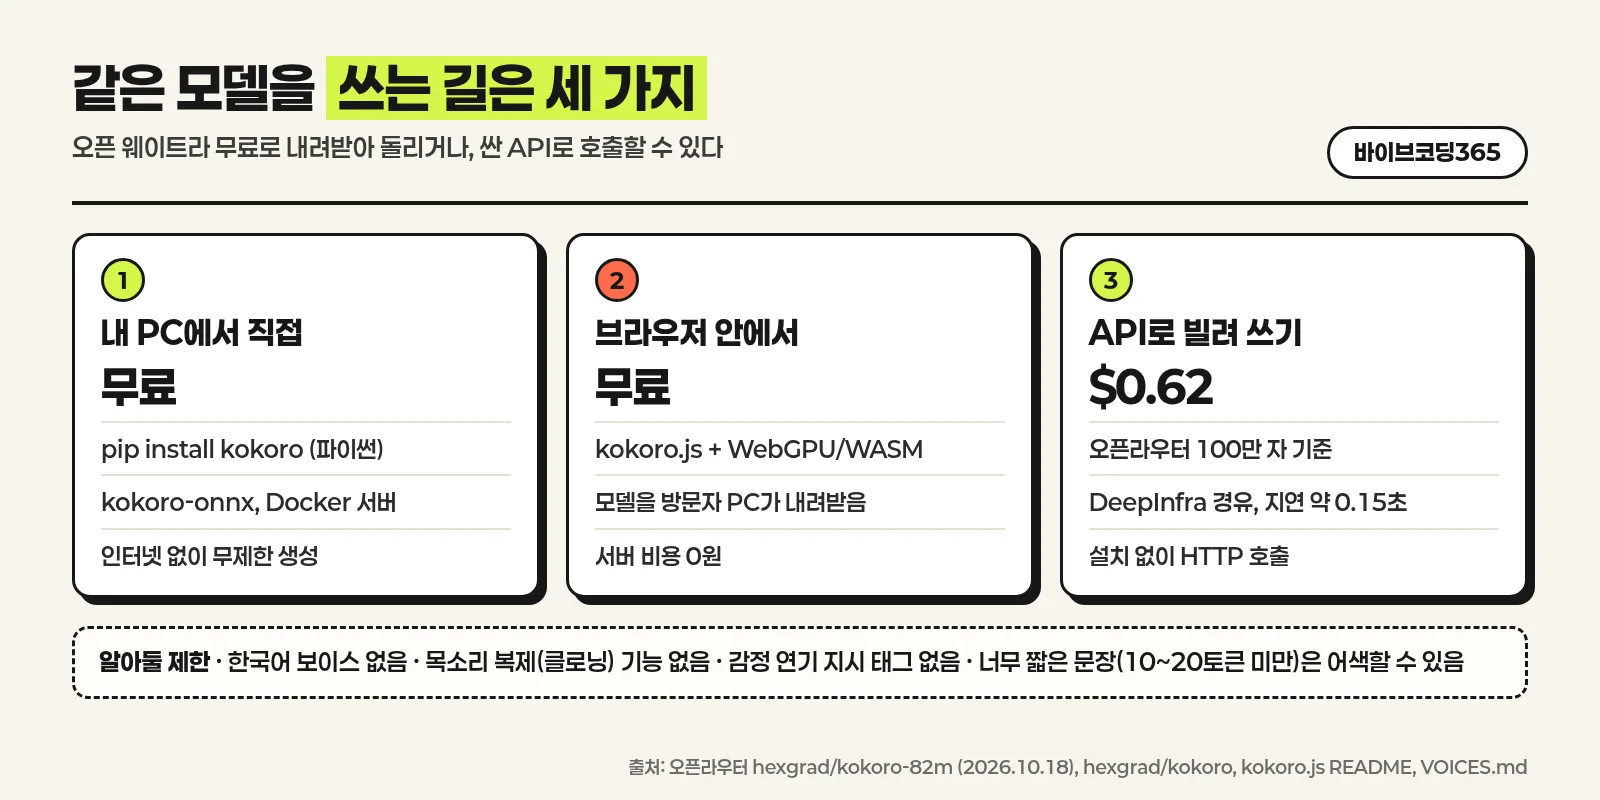
| 항목 | 내용 |
|---|---|
| 정체 | 영어 중심 TTS(음성 합성) 모델, 8,200만 파라미터 |
| 라이선스 | Apache 2.0, 상업적 이용 가능 |
| 로컬 실행 | 무료, CPU 가능, NVIDIA GPU면 더 빠름 |
| API 가격 | 오픈라우터 100만 자 0.62달러(DeepInfra), 4달러(Together) |
| 응답 지연 | 오픈라우터 표시 152ms, DeepInfra P50 0.17초 |
| 언어와 보이스 | 8개 언어, 보이스 54개, 한국어 없음 |
| 못 하는 것 | 목소리 복제, [웃음] 같은 감정 태그, 한국어 |
| 주의 | "kokoro"가 들어간 도메인의 유료 사이트는 공식이 아님 |
가격 감을 잡으려면 글자 수와 재생 시간의 관계를 알면 된다. 모델 카드는 입력 1,000자가 평균 약 1분 분량의 음성이라고 적었다. 100만 자는 약 1,000분, 16시간이 넘는 분량이고 오픈라우터에서는 이 분량이 0.62달러다. 직접 설치하면 이 비용조차 들지 않는다.
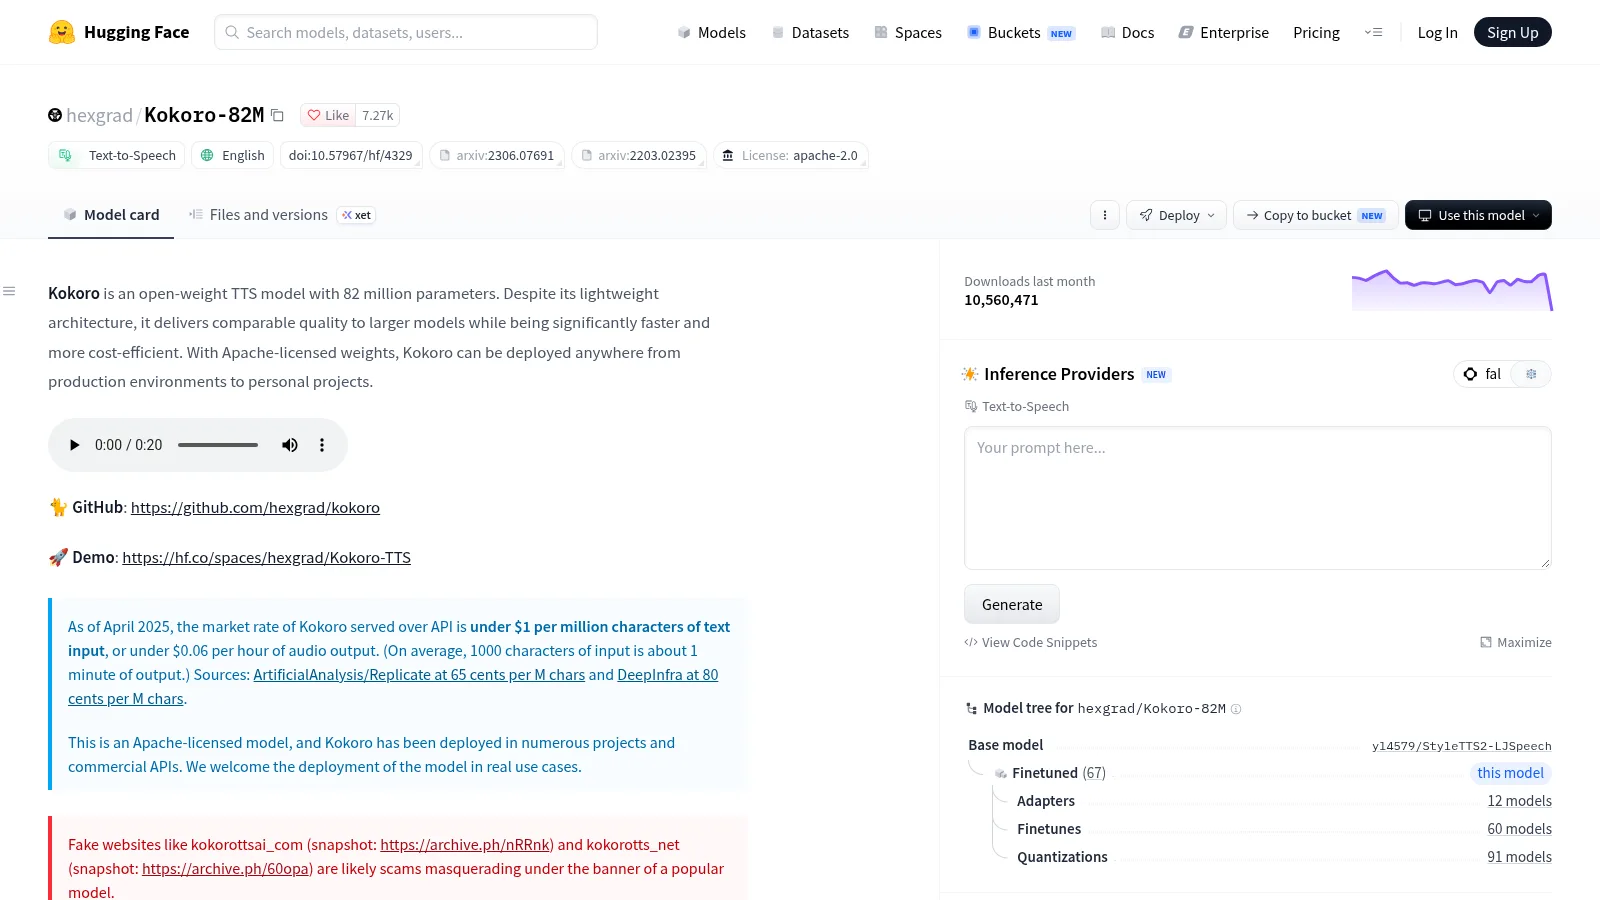
모델 카드 맨 위에는 사기 사이트 경고도 붙어 있다. kokorottsai, kokorotts 같은 주소처럼 도메인에 "kokoro"가 들어간 사이트는 모델 제작자와 관계가 없으며, 이런 사이트가 공식인 척하면 의심하라는 내용이다. 공식 위치는 허깅페이스 hexgrad/Kokoro-82M과 깃허브 hexgrad/kokoro 두 곳이다.
핵심 포인트: 개인 작업이면 로컬 설치로 0원, 서버에 붙일 때는 오픈라우터 기준 100만 자 0.62달러다. 한국어가 필요하면 처음부터 다른 모델을 골라야 한다.
작은데 소리가 좋은 이유
요즘 주목받는 음성 모델은 수억에서 수십억 파라미터가 흔하다. Kokoro는 8,200만 개로 그보다 한두 자릿수 작다. 그런데도 2025년 초 사람들이 블라인드로 듣고 고르는 TTS 아레나에서 상용 모델들과 나란히 섰다. 비결은 새 구조를 발명한 것이 아니라 검증된 구조를 가볍게 다듬고, 학습 데이터를 깨끗하게 고른 데 있다.
구조의 바탕은 2023년 논문으로 나온 StyleTTS 2다. 여기에 음성 파형을 빠르게 만들어 내는 ISTFTNet 보코더를 붙였다. 모델 카드는 "디코더만 쓰고, 확산(diffusion)도 없고, 인코더는 공개하지 않는다"고 설명한다. 원래 StyleTTS 2에 있던 확산 단계를 빼서 계산을 줄였고, 대신 보이스마다 미리 만들어 둔 스타일 벡터(보이스 파일)를 불러와 말투를 정한다. 보이스가 파일 하나로 정해지기 때문에 여러 보이스 파일을 평균 내 섞는 일도 간단하다.
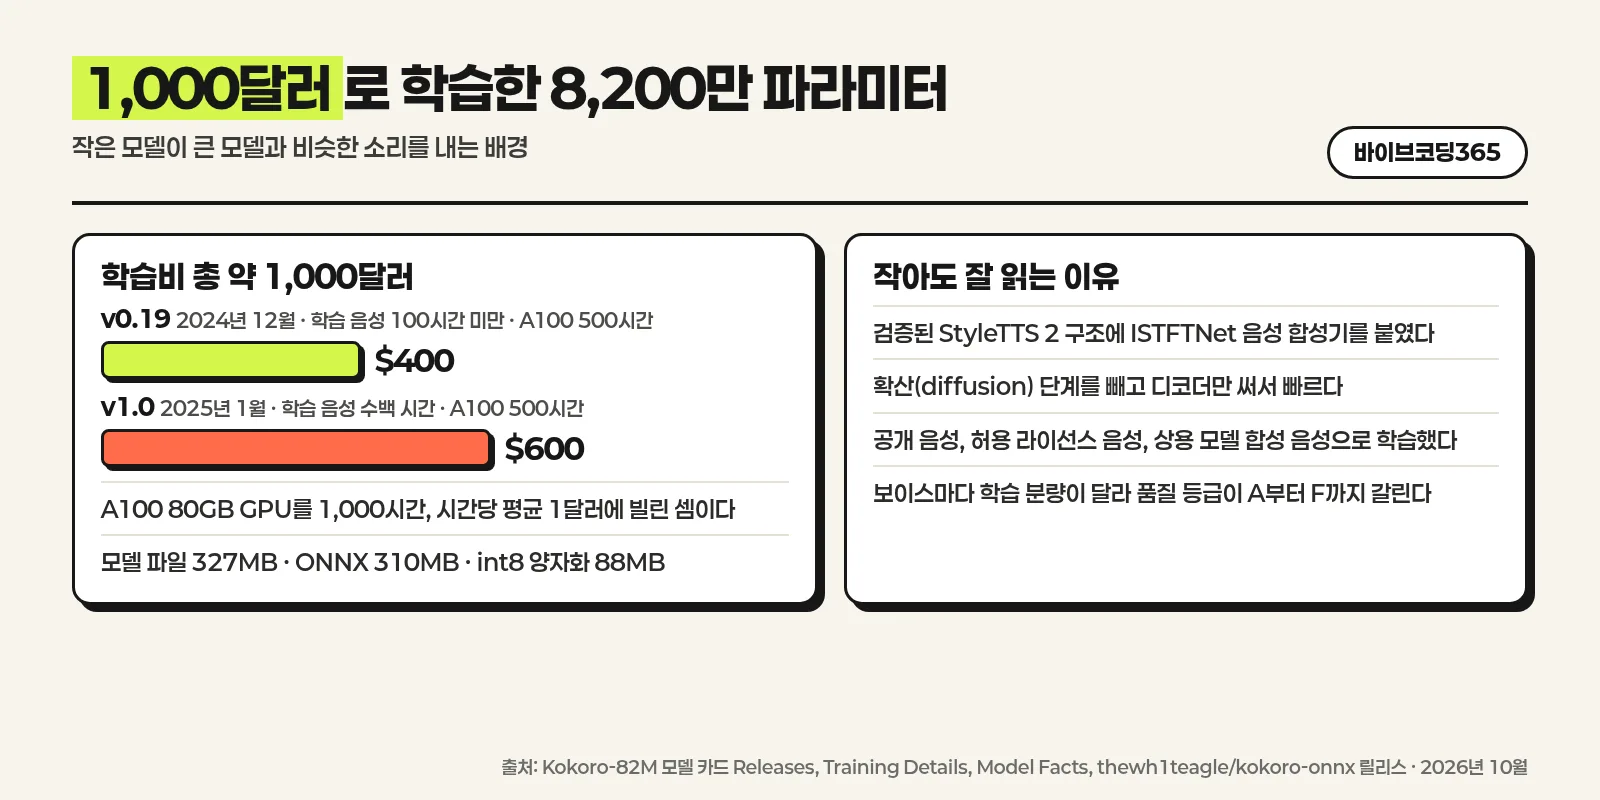
학습 데이터는 저작권 문제가 없는 음성만 썼다. 퍼블릭 도메인 음성, Apache나 MIT처럼 허용 라이선스가 붙은 음성, 그리고 대형 업체의 비공개 TTS 모델로 만든 합성 음성이 섞였다. 모델 카드는 오픈 TTS 모델이나 "커스텀 보이스 클론"으로 만든 합성 음성은 넣지 않았다고 밝혔다. 크리에이티브 커먼즈 출처로는 일본어 Koniwa(1시간 미만)와 프랑스어 SIWIS(11시간 미만)가 표기되어 있다.
| 버전 | 공개일 | 학습 음성 | 언어와 보이스 | 학습비 |
|---|---|---|---|---|
| v0.19 | 2024년 12월 25일 | 100시간 미만 | 1개 언어, 10개 | A100 500시간, 약 400달러 |
| v1.0 | 2025년 1월 27일 | 수백 시간 | 8개 언어, 54개 | A100 500시간, 약 600달러 |
| v1.1-zh | 2025년 2월 27일 | 중국어 화자 100명 추가 | 중국어 중심 | 공개되지 않음 |
v1.1-zh는 별도 저장소(hexgrad/Kokoro-82M-v1.1-zh)로 나온 실험판이다. 중국 데이터 회사 롱마오데이터가 무상 제공한 중국어 화자 100명과 영어 합성 음성 3시간을 더했지만, 모델 카드 스스로 "기존 보이스를 많이 빼서 전작의 엄격한 상위 호환은 아니다"라고 적었다. 일반적인 영어 용도라면 v1.0이 기본이다.
크기가 작다는 것은 그대로 속도와 비용으로 이어진다. ONNX로 바꾼 int8 모델(88MB)을 GPU 없는 8코어 인텔 제온 서버에서 돌렸을 때 268자 영어 문단, 즉 16.5초 분량 음성이 2.7초 만에 나왔다. 재생 시간보다 6배 이상 빠르다는 뜻이다. NVIDIA RTX 4060 Ti를 쓴 Kokoro-FastAPI 측정에서는 실시간 대비 35~100배 빠르게 나왔다.
핵심 포인트: Kokoro의 경쟁력은 "최고 음질"이 아니라 "이 크기에 이 음질"이다. 그래서 대량 생성, 저사양 기기, 실시간 응답처럼 속도와 비용이 중요한 곳에서 강하다.
사용량과 음질 순위
음질 순위와 사용량 순위는 다른 이야기를 한다. Kokoro는 공개 직후 음질 순위표 상단에 올랐다가 최신 상용 모델에 밀려 내려왔지만, 실제로 API를 거쳐 만들어지는 음성 분량은 여전히 손에 꼽힌다.
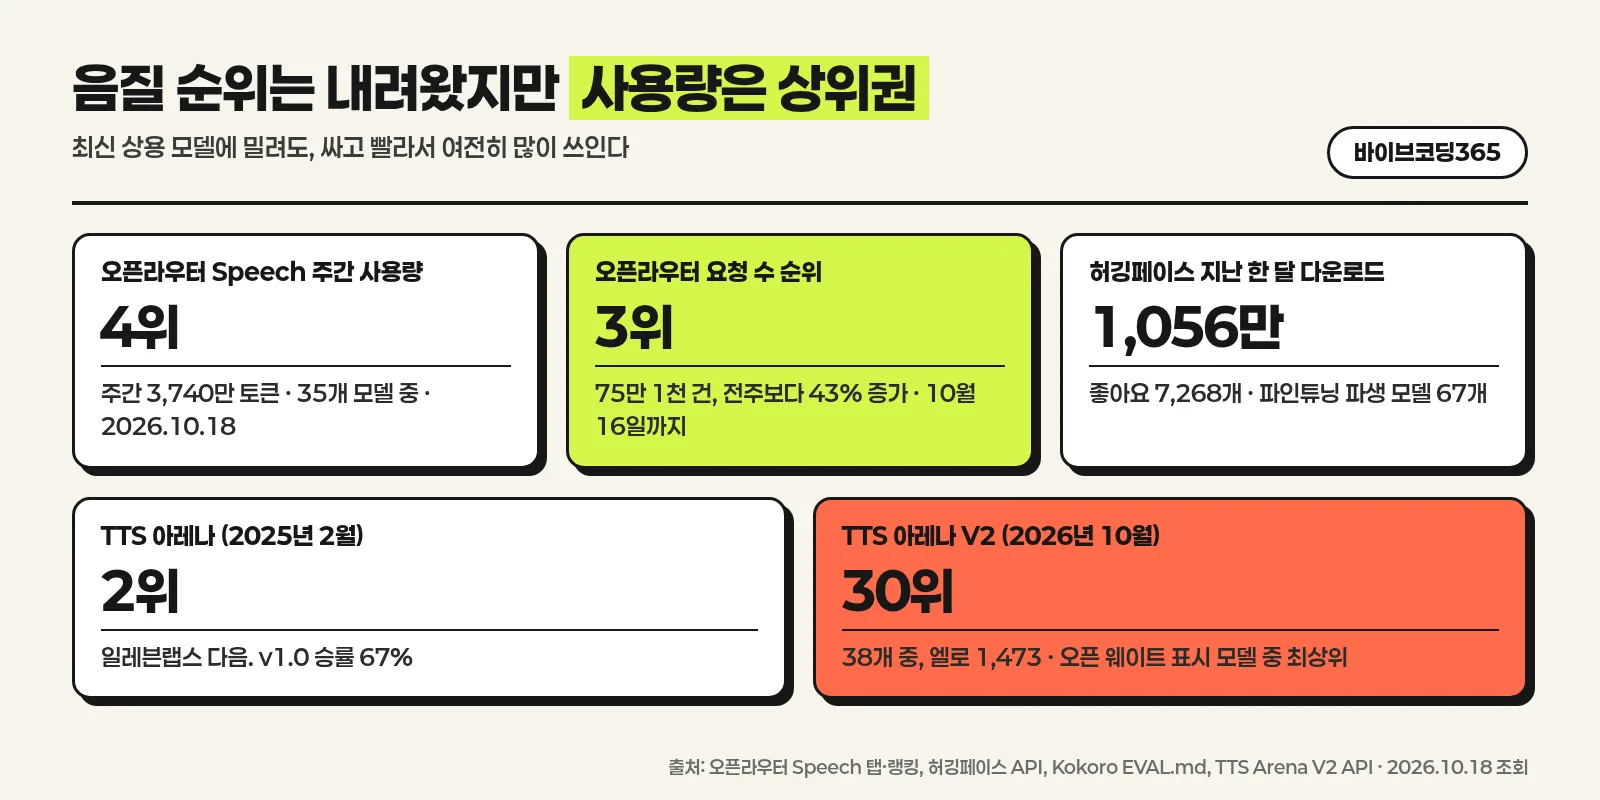
모델 카드의 EVAL.md에는 v1.0 공개 한 달 뒤인 2025년 2월 26일 캡처가 남아 있다. 당시 TTS 아레나에서 Kokoro v1.0은 일레븐랩스 다음 2위(승률 67.0%, 점수 1,291)였고, 이전 버전 v0.19도 4위에 있었다. 아티피셜 애널리시스 음성 아레나에서는 엘로 1,092로 7위였다.
1년 반이 지난 지금은 순위가 많이 내려왔다. 2026년 10월 18일 TTS 아레나 V2 순위표 API를 보면 Kokoro v1.0은 38개 모델 중 30위, 엘로 1,473, 승률 47.7%(투표 1,033회)다. 위쪽은 인월드, 미니맥스, 일레븐랩스 같은 상용 모델이 채웠고, 같은 순위표에서 오픈 웨이트로 표시된 모델 가운데에서는 Kokoro가 가장 높다. 오픈라우터 모델 페이지에 표시된 아티피셜 애널리시스 엘로는 1,061이다.
사용량은 반대로 강하다. 오픈라우터 Speech 탭 35개 모델 중 주간 토큰 4위(3,740만)이고, 요청 수로 세면 10월 16일까지 일주일 동안 75만 1천 건으로 3위다. 전주보다 43% 늘었다. 10월 5일로 시작하는 주에는 제작사 기준 음성 요청 점유율에서 hexgrad가 10.9%로 구글(54.3%) 다음 2위였다.
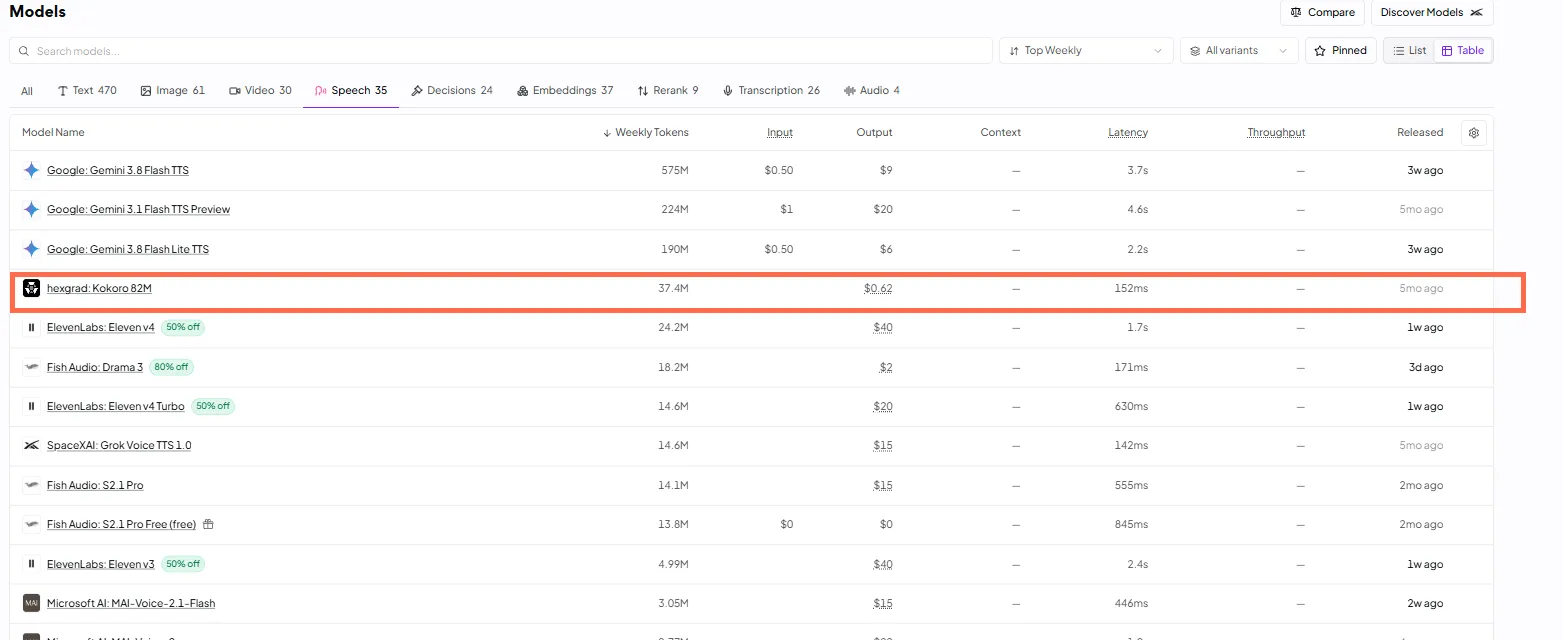
X에서도 비슷한 평가가 많다. 음성 에이전트를 직접 만드는 개발자 @analogalok은 7월 27일 "감정 표현이 풍부한 Qwen3 TTS는 1.7B라 일반 GPU에서 RTF 0.8 근처지만, 1초 미만 실시간 구성에서는 Kokoro 82M을 이길 게 없다"고 답했다. 10월 2일에는 한 사용자가 "CPU에서도 빠르고 bf_emma 보이스가 훌륭하다"고 적었다.
핵심 포인트: 음질 경쟁에서는 상용 최신 모델이 앞서지만, 싸고 빠르고 무료로 배포할 수 있다는 점 때문에 Kokoro는 여전히 가장 많이 쓰이는 TTS 중 하나다.
지원 언어와 한국어 상황
Kokoro v1.0은 언어마다 한 글자짜리 언어 코드를 쓴다. 파이썬 패키지의 KPipeline(lang_code='a')처럼 코드를 정하고, 보이스 이름의 첫 글자가 이 코드와 같아야 한다. af_heart의 a는 미국 영어, f는 여성(female)을 뜻한다.
| 코드 | 언어 | 보이스 | 발음 변환 | 추가 설치 |
|---|---|---|---|---|
| a | 미국 영어 | 20개 (여 11, 남 9) | misaki[en] | espeak-ng 보조 |
| b | 영국 영어 | 8개 | misaki[en] | espeak-ng 보조 |
| j | 일본어 | 5개 | misaki[ja] | pip install misaki[ja] |
| z | 중국어(표준어) | 8개 | misaki[zh] | pip install misaki[zh] |
| e | 스페인어 | 3개 | espeak-ng | espeak-ng 필수 |
| f | 프랑스어 | 1개 | espeak-ng | espeak-ng 필수 |
| h | 힌디어 | 4개 | espeak-ng | espeak-ng 필수 |
| i | 이탈리아어 | 2개 | espeak-ng | espeak-ng 필수 |
| p | 브라질 포르투갈어 | 3개 | espeak-ng | espeak-ng 필수 |
VOICES.md는 영어 외 언어에 대해 "발음 변환이 약하거나 학습 데이터가 부족해 지원이 없거나 얇을 수 있다"고 미리 밝혀 두었다. 프랑스어는 보이스가 하나뿐이고, 중국어 보이스 8개는 모두 D 등급이다. 실제로 쓸 만한 품질은 영어, 그다음이 일본어다.
한국어는 2026년 10월 현재 공식 지원하지 않는다. 헷갈리기 쉬운 지점이 하나 있는데, 발음 변환기 misaki 저장소에는 한국어 토크나이저(g2pK 기반)가 들어 있다. 하지만 Kokoro 파이썬 패키지의 언어 목록에 한국어 코드가 없고, 무엇보다 한국어로 학습된 보이스가 하나도 없다. 발음 기호를 만들 수 있어도 그 발음으로 말해 본 적 있는 목소리가 없는 셈이다.
깃허브에는 한국어 지원을 요청하는 이슈가 2025년 1월(#26)과 2026년 1월(#294)에 올라왔고, 외부 기여자가 2025년 8월 올린 "Korean language support added" 풀 리퀘스트(#245)도 병합되지 않은 채 열려 있다. kokoro-onnx에 언어를 "ko"로 넘기면 espeak-ng가 "ˈɐnnjʌŋhˌɐsejˌo" 같은 한국어 발음 기호를 만들고 소리도 나오지만, 이는 영어로 학습된 보이스가 한국어 발음 기호를 읽는 것이라 품질을 보장하지 않는다. 허깅페이스에서도 한국어 전용 Kokoro 파인튜닝은 찾기 어렵고, 베트남어(contextboxai/Kokoro-Vietnamese)나 러시아어 같은 다른 언어 파생 모델이 먼저 나와 있다.
국내 유튜브 채널 Nova AI가 Kokoro를 한국어로 소개한 영상도 있다. 2025년 초 TTS 아레나 1위 시절에 만든 영상이라 순위 언급은 당시 기준이다.
영상 2. Kokoro의 특징과 로컬 실행을 한국어로 설명한 영상(2025년 초 제작). 출처: YouTube Nova AI
한국어 음성이 꼭 필요하다면 오픈라우터 안에서도 대안이 있다.
| 모델 | 오픈라우터 가격 | 한국어 | 특징 |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 입력 0.50달러, 출력 9달러 (100만 토큰) | 지원 | 사용량 1위, 1분 약 0.0135달러 |
| MAI-Voice-2.1-Flash | 100만 자 15달러 | 지원 (ko-KR 보이스) | 지연 446ms |
| Grok Voice TTS 1.0 | 100만 자 15달러 | 지원 | 지연 142ms |
| Fish Audio Drama 3 | 100만 바이트 2달러 (할인가) | 지원 | 바이트 과금이라 한글은 3배 |
| Eleven v4 | 100만 자 40달러 (할인가) | 지원 | 감정 표현, 할인 종료 후 2배 |
핵심 포인트: Kokoro로 한국어 쇼츠를 만들 수는 없다. 영어 콘텐츠는 Kokoro로 싸게, 한국어 콘텐츠는 Gemini나 MAI-Voice 같은 다국어 모델로 나누는 구성이 현실적이다.
54개 보이스와 보이스 섞기
보이스 54개는 품질이 고르지 않다. VOICES.md는 보이스마다 녹음 품질(Target Quality)과 학습 분량(Training Duration)을 따로 매기고, 둘을 합친 종합 등급을 A부터 F까지 붙였다. 학습 분량이 수십 시간인 보이스는 등급이 높고, 몇 분밖에 안 되는 보이스는 낮다.
| 보이스 | 언어, 성별 | 종합 등급 | 메모 |
|---|---|---|---|
| af_heart | 미국 영어, 여성 | A | 공식 예제 기본 보이스 |
| af_bella | 미국 영어, 여성 | A- | 학습 분량 수십 시간 |
| af_nicole | 미국 영어, 여성 | B- | 학습 분량 수십 시간 |
| bf_emma | 영국 영어, 여성 | B- | 영국 영어 최고 등급 |
| ff_siwis | 프랑스어, 여성 | B- | 프랑스어 유일 보이스 |
| am_fenrir, am_michael, am_puck | 미국 영어, 남성 | C+ | 남성 보이스 중 가장 높음 |
| am_adam | 미국 영어, 남성 | F+ | 가장 낮은 등급 |
남성 내레이션이 필요하면 C+ 등급인 am_michael이나 am_fenrir부터 들어 보는 편이 낫고, 여성이면 af_heart와 af_bella가 무난하다. 스페인어와 포르투갈어 보이스는 등급이 표기되어 있지 않다.
문장 길이도 품질에 영향을 준다. VOICES.md에 따르면 대부분의 보이스는 한 번에 최대 약 500토큰 중 100~200토큰 구간에서 가장 좋은 소리를 낸다. 10~20토큰보다 짧은 문장은 어색해지기 쉬워 짧은 문장끼리 묶어 보내는 편이 낫고, 400토큰이 넘으면 말이 빨라지는 경향이 있어 잘게 나누거나 speed 값을 낮춘다.
보이스 섞기(블렌딩)는 Kokoro의 대표 기능이다. 보이스 파일이 말투를 담은 숫자 묶음이라, 두 보이스를 평균 내면 중간 성격의 새 목소리가 된다. 파이썬 패키지에서는 보이스 이름을 쉼표로 이으면 같은 비율로 섞인다.
from kokoro import KPipeline
import soundfile as sf

pipeline = KPipeline(lang_code='a', repo_id='hexgrad/Kokoro-82M')
# 쉼표로 이으면 두 보이스를 같은 비율로 평균 낸다
for i, (gs, ps, audio) in enumerate(pipeline("Welcome back to the channel.", voice='af_bella,af_sky')):
    sf.write(f'mix_{i}.wav', audio, 24000)
비율을 직접 정하고 싶다면 Kokoro-FastAPI 서버의 문법이 편하다. af_bella(2)+af_sky(1)처럼 괄호에 가중치를 적으면 67% 대 33%로 섞이고, DeepInfra API도 보이스를 여러 개 골라 섞는 옵션을 제공한다.
목소리 복제(클로닝)는 지원하지 않는다. 오픈라우터 엔드포인트 정보에도 보이스 클로닝은 false로 표시된다. Kokoro-FastAPI에는 3~30초 영어 음성을 넣어 기존 보이스를 그 방향으로 조정하는 실험 기능(/dev/tune)이 있지만, 문서 스스로 "복제기가 아니라 튜너라서 비슷한 동네까지만 간다"고 설명하고, 권한 있는 목소리에만 쓰라고 적었다.
Sam Witteveen 채널은 Kokoro 보이스를 직접 섞어 커스텀 보이스를 만드는 과정을 코드와 함께 보여 준다. 조회 15만 회를 넘긴 영상이다.
영상 3. Kokoro를 로컬에서 돌리고 보이스를 섞어 커스텀 보이스를 만드는 과정. 출처: YouTube Sam Witteveen
핵심 포인트: 처음에는 af_heart, af_bella, bf_emma처럼 등급 높은 보이스로 시작하고, 채널 고유의 목소리가 필요하면 두 보이스를 섞어 만든다. 실존 인물 목소리 복제는 Kokoro로는 할 수 없다.
윈도우에 설치하기: pip와 espeak-ng
윈도우에서 Kokoro를 돌리는 방법은 세 가지다. 파이썬 코드로 직접 다룰 때는 공식 pip 패키지, 무거운 PyTorch 없이 가볍게 쓰고 싶을 때는 kokoro-onnx, 다른 앱이나 자동화 도구에 붙일 서버가 필요할 때는 도커로 띄우는 Kokoro-FastAPI가 맞다.
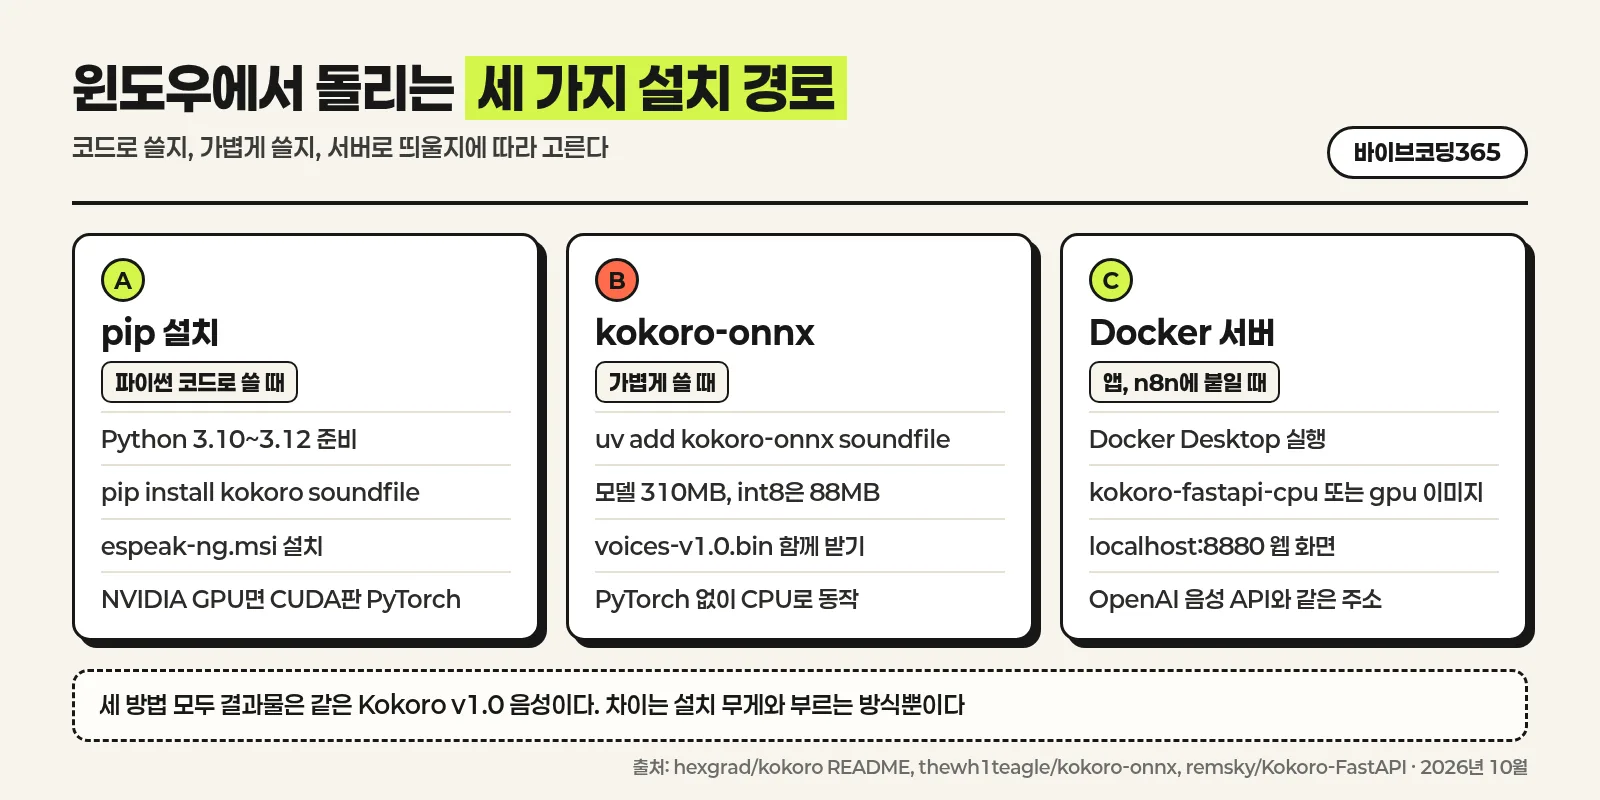
공식 패키지 kokoro의 최신판은 0.9.4이고, PyPI 기준 파이썬 3.10 이상 3.13 미만에서 설치된다. 파이썬 3.13을 쓰고 있다면 3.12 가상환경을 따로 만드는 편이 안전하다. uv를 쓰면 원하는 파이썬 버전을 자동으로 받아 준다.
uv venv -p 3.12 kokoro-env
kokoro-env\Scripts\activate
uv pip install "kokoro>=0.9.4" soundfile
NVIDIA 그래픽카드가 있다면 CUDA용 PyTorch를 먼저 깔아 둔다. 그냥 설치하면 CPU용 PyTorch가 들어갈 수 있고, Kokoro는 CUDA가 잡히면 GPU를 자동으로 쓴다. 아래는 CUDA 12.6용 예시다.
uv pip install torch --index-url https://download.pytorch.org/whl/cu126다음은 espeak-ng다. 영어에서 사전에 없는 단어를 처리하고, 스페인어나 프랑스어처럼 misaki가 직접 다루지 않는 언어에서는 발음 변환 전체를 맡는다. 공식 README는 espeak-ng 깃허브 릴리스에서 최신 msi 파일을 받아 설치하라고 안내한다. 2026년 10월 현재 최신판은 2024년 12월에 나온 1.52.0의 espeak-ng.msi다.
설치했는데도 "espeak not installed" 오류가 나면 파이썬이 DLL 위치를 못 찾는 경우가 많다. 공식 이슈 #101에서 해결책으로 공유된 방법은 스크립트 맨 위에 DLL 경로를 직접 적는 것이다.
import os
os.environ['PHONEMIZER_ESPEAK_LIBRARY'] = r"C:\Program Files\eSpeak NG\libespeak-ng.dll"
준비가 끝나면 짧은 영어 대본으로 첫 음성을 만들어 본다. 처음 실행할 때 허깅페이스에서 모델 파일(327MB)과 보이스 파일을 내려받으므로 시간이 조금 걸린다.
from kokoro import KPipeline
import soundfile as sf

pipeline = KPipeline(lang_code='a', repo_id='hexgrad/Kokoro-82M')
text = "This short video explains how vibe coding works in three steps."
for i, (gs, ps, audio) in enumerate(pipeline(text, voice='af_heart', speed=1.0)):
    sf.write(f'narration_{i}.wav', audio, 24000)
긴 대본은 기본 설정에서 줄바꿈 기준으로 나뉘어 조각마다 파일이 하나씩 생긴다. 쇼츠 한 편 분량이라면 문단을 한 줄씩 띄워 두고, 나중에 영상 편집기에서 이어 붙이거나 numpy로 합치면 된다. 일본어나 중국어를 쓰려면 pip install misaki[ja] 또는 misaki[zh]를 추가로 설치하고 lang_code를 j나 z로 바꾼다.
Aleksandar Haber 채널은 파이썬 가상환경을 만들고 pip로 Kokoro를 설치해 첫 음성을 뽑는 과정을 처음부터 따라 한다.
영상 4. 파이썬 가상환경에 Kokoro-82M을 설치하고 로컬에서 실행하는 과정. 출처: YouTube Aleksandar Haber PhD
가볍게 돌리는 kokoro-onnx
kokoro-onnx는 Kokoro를 ONNX 런타임으로 돌리는 별도 패키지다. PyTorch를 깔지 않아 설치가 가볍고, CPU에서도 빠르다. 저장소는 MIT 라이선스(모델은 Apache 2.0)이고 깃허브 별은 2,788개, 최신판은 0.6.1이다. espeak-ng를 함께 내려받는 espeakng-loader 패키지가 의존성으로 같이 설치된다.
설치는 uv로 새 폴더를 만들고 패키지 두 개를 추가하면 끝난다.
uv init -p 3.12 kokoro-onnx-test
cd kokoro-onnx-test
uv add kokoro-onnx soundfile
모델 파일은 저장소 릴리스 페이지에서 따로 받는다. 원본 정밀도 kokoro-v1.0.onnx는 310MB, fp16은 169MB, int8은 88.1MB이고 보이스 묶음 voices-v1.0.bin(26.9MB)이 함께 필요하다. 파일 두 개를 스크립트와 같은 폴더에 두고 아래처럼 부른다.
from kokoro_onnx import Kokoro
import soundfile as sf

kokoro = Kokoro("kokoro-v1.0.int8.onnx", "voices-v1.0.bin")
samples, sample_rate = kokoro.create(
    "Small models can sound surprisingly natural.",
    voice="af_heart", speed=1.0, lang="en-us",
)
sf.write("audio.wav", samples, sample_rate)
int8 모델로 GPU 없는 8코어 서버에서 268자 영어 문단을 읽혔을 때 af_heart는 16.5초 분량을 2.7초에, bf_emma는 15.2초 분량을 2.2초에 만들었다. 모델 로딩은 0.6초였고, 268자가 16.5초라는 결과는 "1,000자에 약 1분"이라는 모델 카드 설명과도 맞아떨어진다. 보이스 섞기는 kokoro.get_voice_style("af_bella")로 꺼낸 보이스 값을 비율대로 더해 voice 자리에 넘기면 된다.
도커로 띄우는 Kokoro-FastAPI
Kokoro-FastAPI는 Kokoro를 OpenAI 음성 API와 같은 모양의 서버로 감싼 프로젝트다. 깃허브 별 5,556개로 kokoro-onnx(2,788개)의 두 배에 가깝고, 10월 15일(한국 시간)에도 코드가 갱신됐다. 서버를 한 번 띄워 두면 OpenAI용으로 만든 코드, Open WebUI, SillyTavern, n8n 같은 도구가 주소만 바꿔 Kokoro를 쓴다.
윈도우에서는 Docker Desktop을 켜 둔 상태에서 한 줄이면 된다. 그래픽카드가 없으면 CPU 이미지를 쓴다.
docker run -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-cpu:latestNVIDIA GPU가 있으면 GPU 이미지를 쓴다. README 기준 GTX 900 시리즈부터 RTX 40 시리즈까지는 기본 이미지(CUDA 12.6), RTX 50 시리즈는 latest-cu128 태그다. 안정적으로 쓰려면 latest 대신 릴리스 태그를 고정하라고 권한다.
docker run --gpus all -p 8880:8880 ghcr.io/remsky/kokoro-fastapi-gpu:latest서버가 뜨면 브라우저에서 localhost:8880/web으로 웹 화면을, localhost:8880/docs로 API 문서를 볼 수 있다. OpenAI 파이썬 SDK를 그대로 쓰되 base_url만 바꾸면 된다. 아래 코드는 보이스 두 개를 섞어 mp3로 저장한다.
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8880/v1", api_key="not-needed")
with client.audio.speech.with_streaming_response.create(
    model="kokoro",
    voice="af_bella(2)+af_sky(1)",
    input="Thanks for watching. See you in the next video.",
    response_format="mp3",
) as response:
    response.stream_to_file("outro.mp3")
Kokoro-FastAPI는 단어별 타임스탬프 자막 생성, 대본 안 [voice:...] 태그로 화자를 바꾸는 다중 화자 대화, SSML 일부 지원, 발음 기호에서 바로 음성을 만드는 엔드포인트까지 갖췄다. README 측정값은 RTX 4060 Ti에서 실시간 대비 35~100배, 스트리밍 첫 소리까지 GPU 약 300ms, 오래된 i7 CPU 약 3.5초, M3 Pro CPU 1초 미만이다.
Professor Patterns 채널은 윈도우에서 도커로 Kokoro 서버를 띄우고 Open WebUI의 음성 출력으로 연결하는 과정을 보여 준다.
영상 5. 윈도우에서 Kokoro TTS 서버를 띄워 Open WebUI 음성으로 연결하는 방법. 출처: YouTube Professor Patterns
로컬 한 대가 아니라 대량 생성 서버로 키우는 방법은 Trelis Research 영상이 자세하다. 동시 요청 처리량을 늘리는 구성과 로컬 실행을 함께 비교한다.
영상 6. Kokoro를 로컬과 고처리량 서버 두 방식으로 운영하는 방법. 출처: YouTube Trelis Research
오픈라우터 API로 호출하기
설치가 번거롭거나 서버리스 환경에서 음성을 만들어야 한다면 오픈라우터 API가 가장 간단하다. 오픈라우터는 2026년 4월 23일 hexgrad/kokoro-82m을 등록했고, DeepInfra(100만 자 0.62달러)와 Together(4달러) 두 곳이 실제 처리를 맡는다. 같은 모델인데 제공사에 따라 가격이 6배 넘게 차이 난다.
호출 주소는 OpenAI와 같은 형식의 /api/v1/audio/speech다. 응답은 JSON이 아니라 오디오 바이트 그대로 오므로 파일로 바로 저장한다. 윈도우 PowerShell에서는 따옴표 처리가 까다로우니 요청 내용을 body.json 파일로 따로 저장해 두는 편이 편하다.
{"model": "hexgrad/kokoro-82m", "input": "Hello from Kokoro.", "voice": "af_heart", "response_format": "mp3"}그다음 PowerShell에서 curl.exe를 명시해 이 파일을 보낸다. 키 자리에는 오픈라우터에서 발급한 API 키를 넣는다.
curl.exe https://openrouter.ai/api/v1/audio/speech -H "Content-Type: application/json" -H "Authorization: Bearer 여기에_오픈라우터_키" -d "@body.json" --output hello.mp3앱 코드에서는 파이썬 requests로 부르는 쪽이 따옴표 문제가 적다. 키는 코드에 직접 쓰지 말고 환경 변수에서 읽는다.
import os, requests

r = requests.post(
    "https://openrouter.ai/api/v1/audio/speech",
    headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},
    json={"model": "hexgrad/kokoro-82m", "input": "Your order has shipped.",
          "voice": "bf_emma", "response_format": "mp3"},
)
r.raise_for_status()
open("notice.mp3", "wb").write(r.content)
오픈라우터에서 고를 수 있는 보이스는 54개 전부이고, 출력 형식은 mp3와 pcm 두 가지다(기본값 pcm). 엔드포인트 정보상 한 요청의 컨텍스트는 4,096으로 표시되어 있어, 긴 대본은 문단 단위로 나눠 보내는 편이 안전하다. 응답 헤더의 X-Generation-Id로 과금 내역을 확인할 수 있다. 오픈라우터를 거치지 않고 DeepInfra에 직접 가입해 쓰면 공식 페이지 표시가는 100만 자 0.99달러이고, 대신 opus, flac, wav 출력과 속도 조절(0.25~4배), 타임스탬프 옵션을 쓸 수 있다.
브라우저에서 돌리는 kokoro.js
kokoro.js(npm 패키지 이름 kokoro-js)는 Kokoro를 웹 브라우저 안에서 100% 로컬로 돌리는 자바스크립트 라이브러리다. 허깅페이스 Transformers.js 위에서 동작하며, 방문자의 브라우저가 모델을 한 번 내려받아 캐시하고 그 뒤로는 서버 없이 음성을 만든다. 최신판은 1.2.1이다.
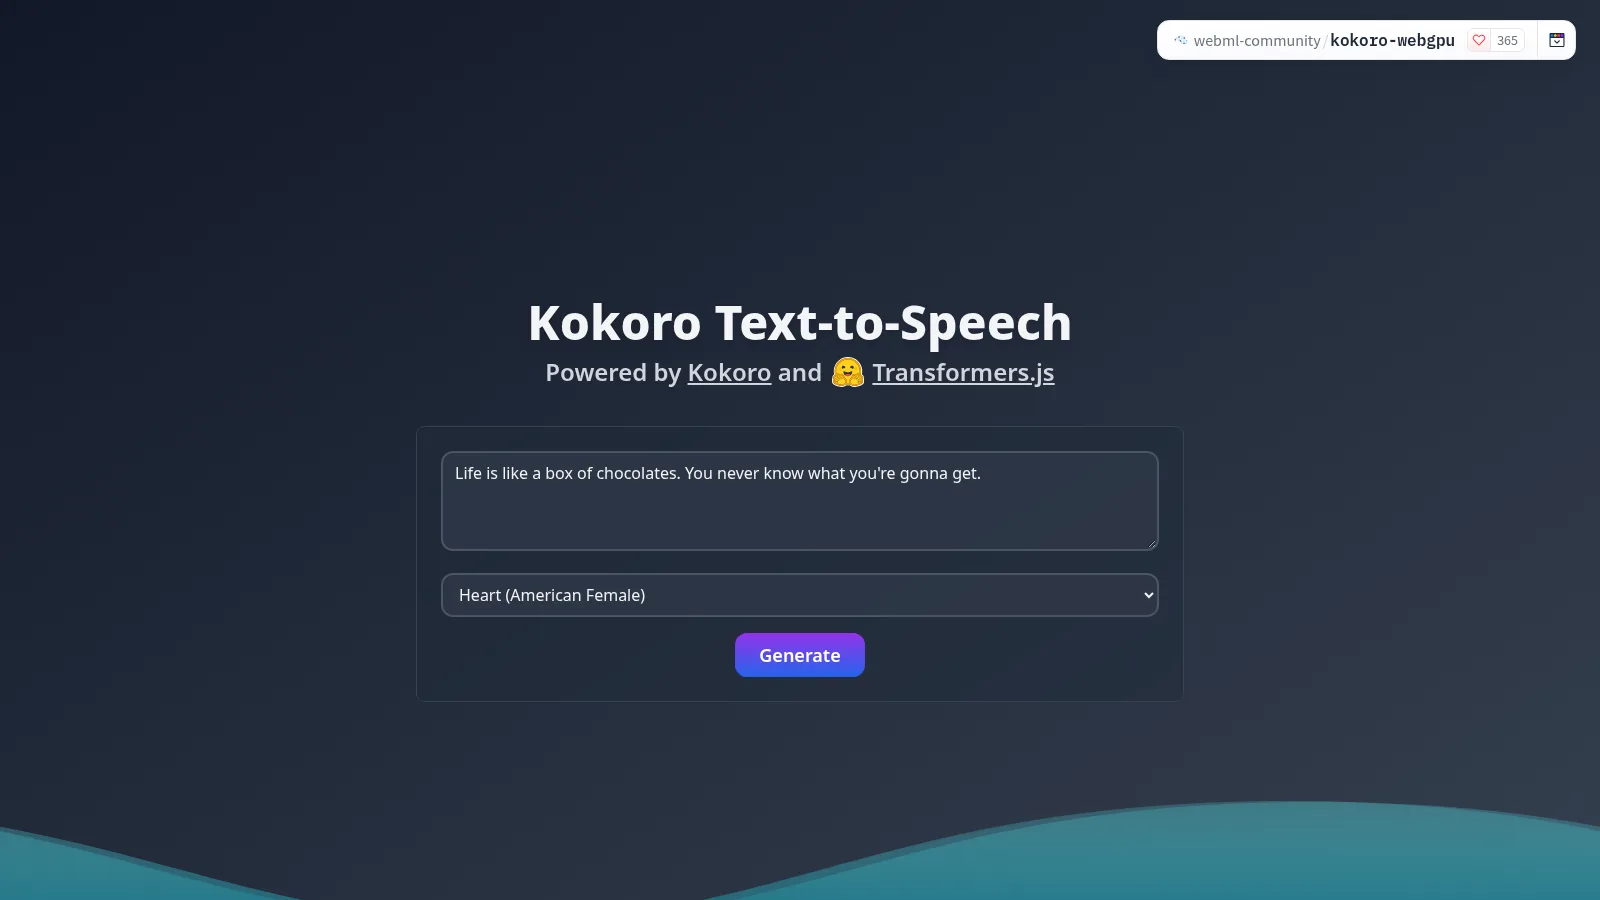
설치는 npm 한 줄이고, 모델 정밀도(dtype)와 실행 장치(device)를 골라 불러온다. q8은 약 92MB로 가볍고, WebGPU를 쓸 때는 fp32(약 326MB)를 권장한다.
import { KokoroTTS } from "kokoro-js";

const tts = await KokoroTTS.from_pretrained("onnx-community/Kokoro-82M-v1.0-ONNX", {
  dtype: "q8",      // fp32, fp16, q8, q4, q4f16
  device: "wasm",   // 브라우저는 wasm 또는 webgpu, Node.js는 cpu
});
const audio = await tts.generate("Welcome to my portfolio.", { voice: "af_heart" });
audio.save("welcome.wav");
LLM이 한 단어씩 답을 내보내는 화면에 음성을 붙이고 싶다면 TextSplitterStream으로 문장이 완성되는 대로 소리를 만들 수 있다. kokoro.js README의 보이스 표는 미국 영어와 영국 영어만 다룬다.
X 사용자 @ukauwa_david는 7월 2일 자기 사이트의 음성 기능에 대해 "Kokoro가 방문자 브라우저에서 kokoro-js와 ONNX로 완전히 돌아가서 TTS 비용이 0원"이라고 설명했다. 포트폴리오나 데모 페이지에 읽어 주기 기능을 붙일 때 서버 비용 없이 쓸 수 있는 방법이다. 다만 첫 방문 때 수십~수백 MB 모델을 받아야 하므로 모바일 데이터 환경에서는 부담이 될 수 있다.
Fahd Mirza 채널은 Kokoro를 브라우저에서 오프라인으로 돌리는 과정을 짧게 보여 준다.
영상 7. 설치 없이 브라우저 안에서 Kokoro 82M을 오프라인으로 실행하는 방법. 출처: YouTube Fahd Mirza
다른 TTS와 비용 비교
오픈라우터 Speech 탭에 올라온 35개 모델 중 유료 모델로는 Kokoro가 가장 싸다. 단위가 제각각이라 그대로 비교하기 어렵기 때문에, 아래는 영어 1분을 약 1,000자로 놓고 100만 자(약 1,000분) 기준으로 맞춘 값이다. 일레븐랩스 가격은 10월 20일 0시(한국 시간)에 끝나는 한시 할인가다.
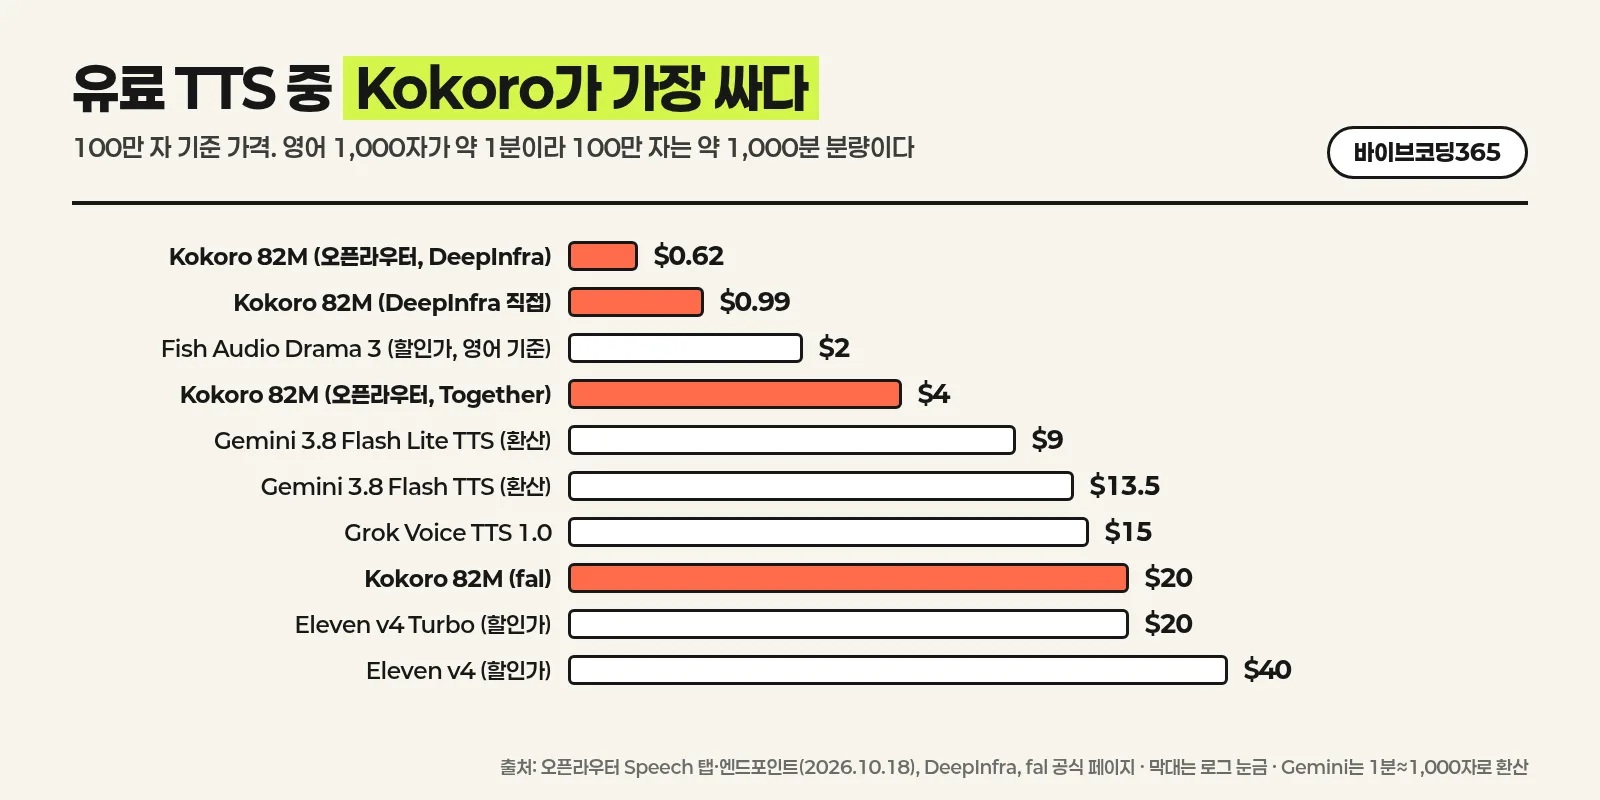
| 모델 (제공처) | 100만 자 기준 | 쇼츠 30편 (약 3만 자) | 오디오북 10시간 (약 60만 자) |
|---|---|---|---|
| Kokoro 82M (오픈라우터, DeepInfra) | 0.62달러 | 약 0.02달러 | 약 0.37달러 |
| Kokoro 82M (DeepInfra 직접) | 0.99달러 | 약 0.03달러 | 약 0.59달러 |
| Kokoro 82M (오픈라우터, Together) | 4달러 | 약 0.12달러 | 약 2.4달러 |
| Kokoro 82M (fal) | 20달러 | 약 0.6달러 | 약 12달러 |
| Gemini 3.8 Flash TTS (환산) | 약 13.5달러 | 약 0.41달러 | 약 8.1달러 |
| Grok Voice TTS 1.0 | 15달러 | 약 0.45달러 | 약 9달러 |
| Eleven v4 Turbo (할인가) | 20달러 | 약 0.6달러 | 약 12달러 |
| Eleven v4 (할인가) | 40달러 | 약 1.2달러 | 약 24달러 |
같은 Kokoro라도 어디서 부르느냐에 따라 값이 크게 다르다. fal은 1,000자당 0.02달러로 100만 자 20달러이고, 그 엔드포인트에서는 미국 영어 보이스 19개만 고를 수 있다. 레플리케이트의 커뮤니티 버전(jaaari/kokoro-82m)은 글자가 아니라 실행 시간으로 과금해 1회 약 0.00034달러로 안내한다. 모델 카드는 2025년 4월 기준 API 시세를 "100만 자당 1달러 미만"으로 적어 두었다.
표에서 보듯 영어 쇼츠 30편을 만들어도 Kokoro는 몇 센트 수준이다. 비용 차이가 실제로 체감되는 것은 오디오북이나 대량 안내 음성처럼 분량이 수십만 자를 넘을 때다. 반대로 분량이 적고 감정 연기가 중요한 광고 내레이션이라면, 몇 달러 차이보다 음질과 표현력 차이가 더 크게 느껴질 수 있다.
핵심 포인트: 영어 음성을 대량으로 만들면 Kokoro가 압도적으로 싸다. 다만 오픈라우터에서도 Together로 라우팅되면 6배 넘게 비싸지고, fal은 30배 넘게 비싸므로 제공처 가격부터 확인한다.
바이브 코더가 쓰기 좋은 곳과 한계
Kokoro가 가장 빛나는 곳은 영어 콘텐츠를 많이, 싸게, 빨리 만들어야 하는 자리다. 해외 시청자를 겨냥한 영어 쇼츠 내레이션, 영어 학습 앱의 예문 읽기, 블로그 글을 팟캐스트처럼 읽어 주는 기능, 게임 NPC 대사 초안 같은 작업이 여기에 해당한다. 대본을 LLM으로 쓰고 Kokoro로 읽혀 자막과 함께 영상으로 합치는 자동화 파이프라인은 거의 비용 없이 돌아간다.
두 번째는 앱과 서비스에 음성을 붙이는 일이다. 주문 알림, 접근성용 화면 읽기, 음성 비서의 대답처럼 짧고 정확한 안내 음성은 Kokoro의 빠른 응답 속도와 잘 맞는다. Whisper 같은 음성 인식과 로컬 LLM, Kokoro를 묶으면 인터넷 없이 돌아가는 음성 대화 에이전트도 만들 수 있고, X와 유튜브에도 이런 조합의 사례가 꾸준히 올라온다.
세 번째는 오프라인과 개인정보가 중요한 경우다. 사내 문서나 의료, 법률 자료처럼 외부 API로 보내기 어려운 텍스트도 내 PC 안에서 음성으로 바꿀 수 있다. Apache 2.0이라 만든 음성의 상업적 사용에도 제약이 없다.
한계도 분명하다.
| 한계 | 내용 | 대안 |
|---|---|---|
| 한국어 미지원 | 한국어 보이스와 언어 코드가 없음 | Gemini 3.8 Flash TTS, MAI-Voice-2.1, Grok Voice |
| 목소리 복제 불가 | 참조 음성으로 새 화자를 만들 수 없음 | 클로닝 지원 상용 모델 |
| 감정 연기 약함 | [웃음], [속삭임] 같은 연기 태그가 없음 | Eleven v4, Fish Audio Drama 3 |
| 짧은 문장, 긴 문장 | 10~20토큰 미만은 어색, 400토큰 초과는 빨라짐 | 문장 묶기, 문단 단위로 나누기 |
| 영어 외 언어 품질 | 보이스가 적고 등급이 낮음 | 언어별 전용 모델 |
| 라이브러리 정체 | PyPI kokoro 0.9.4 이후 공식 패키지 업데이트가 뜸함 | kokoro-onnx, Kokoro-FastAPI 커뮤니티판 |
마지막 항목은 눈여겨볼 만하다. 공식 hexgrad/kokoro 저장소의 마지막 코드 반영은 2025년 8월이고, 모델 자체도 v1.0 이후 영어 기준 새 버전이 나오지 않았다. 반면 Kokoro-FastAPI와 kokoro-onnx 같은 커뮤니티 프로젝트는 2026년에도 꾸준히 갱신되고 있다. 장기 프로젝트라면 공식 패키지보다 활발히 관리되는 커뮤니티 래퍼 쪽이 운영에 편할 수 있다.
마무리
앞에서 다룬 Kokoro 82M의 핵심만 짧게 정리한다.
- Kokoro 82M은 8,200만 파라미터, 약 327MB의 영어 중심 오픈 웨이트 TTS로 Apache 2.0이라 상업용으로 써도 된다.
- 8개 언어 54개 보이스가 있지만 한국어는 없고, 목소리 복제와 감정 태그도 지원하지 않는다.
- 2025년 2월 TTS 아레나 2위에서 2026년 10월 V2 30위로 내려왔지만, 오픈라우터 사용량은 주간 4위, 요청 수 3위다.
- 윈도우에서는 pip와 espeak-ng, kokoro-onnx, 도커 Kokoro-FastAPI 세 경로로 무료 실행할 수 있다.
- 오픈라우터 API는 100만 자 0.62달러(DeepInfra)로 유료 TTS 중 가장 싸지만, Together나 fal은 몇 배 비싸다.
- 브라우저에서는 kokoro.js로 서버 비용 없이 음성을 만들 수 있다.
「영어는 Kokoro로 싸게, 한국어는 다국어 모델로」 영어 쇼츠, 앱 안내 음성, 오프라인 읽어 주기처럼 분량이 많고 감정 연기가 덜 중요한 작업에 Kokoro를 두고, 한국어나 연기가 필요한 장면은 다른 모델에 맡기는 구성이 비용과 품질을 함께 잡는다.
출처와 링크
- 허깅페이스 hexgrad/Kokoro-82M 모델 카드
- Kokoro-82M VOICES.md (보이스와 등급)
- Kokoro-82M EVAL.md (2025년 2월 순위 캡처)
- Kokoro-82M-v1.1-zh 모델 카드
- 깃허브 hexgrad/kokoro (파이썬 패키지, kokoro.js)
- 깃허브 hexgrad/misaki (발음 변환기)
- 깃허브 hexgrad/kokoro 이슈 #26, #294 (한국어 요청)
- 깃허브 thewh1teagle/kokoro-onnx
- 깃허브 remsky/Kokoro-FastAPI
- npm kokoro-js
- Kokoro WebGPU 데모
- espeak-ng 릴리스
- 오픈라우터 hexgrad/kokoro-82m
- 오픈라우터 TTS API 문서
- DeepInfra Kokoro-82M
- fal Kokoro (미국 영어)
- 레플리케이트 jaaari/kokoro-82m
- TTS Arena V2
- StyleTTS 2 논문
- ISTFTNet 논문
조사 기준: 2026년 10월 18일 (한국 시간). 가격, 순위, 다운로드, 별 수는 조회 시점 값이며 할인가는 바뀔 수 있다.
FAQ
자주 묻는 질문
Kokoro 82M은 무료로 상업적 이용이 가능한가요?
모델 가중치가 Apache 2.0 라이선스로 공개되어 있어 상업용 서비스나 수익 창출 영상에 써도 된다. 내 PC에 설치해 돌리면 사용료가 들지 않고, 모델 카드도 실제 서비스 배포를 환영한다고 밝혔다. API로 부를 때만 제공사 요금이 붙는다.
Kokoro 82M으로 한국어 음성을 만들 수 있나요?
2026년 10월 기준 공식 한국어 보이스와 언어 코드가 없어 한국어 음성용으로는 쓸 수 없다. 발음 변환기 misaki에 한국어 토크나이저가 있지만 한국어로 학습된 화자가 없다. 한국어가 필요하면 Gemini 3.8 Flash TTS, MAI-Voice-2.1, Grok Voice TTS 같은 다국어 모델을 쓰는 편이 맞다.
GPU 없는 노트북에서도 Kokoro가 돌아가나요?
CPU만으로도 실시간보다 빠르게 음성을 만든다. GPU 없는 8코어 서버에서 int8 ONNX 모델로 16.5초 분량 영어 음성을 약 2.7초에 만들었다. NVIDIA GPU가 있으면 Kokoro-FastAPI 기준 실시간 대비 35~100배까지 빨라진다.
Kokoro로 특정 사람의 목소리를 복제할 수 있나요?
Kokoro는 목소리 복제 기능이 없고 미리 학습된 54개 보이스만 쓴다. 보이스 두세 개를 섞어 새 느낌의 목소리를 만드는 블렌딩은 가능하다. Kokoro-FastAPI의 튜닝 기능도 스스로 복제기가 아니라 튜너라고 설명한다.
오픈라우터에서 Kokoro 82M 가격은 얼마인가요?
2026년 10월 18일 기준 DeepInfra 경유 100만 자당 0.62달러, Together 경유 4달러로 표시된다. 영어 1,000자가 약 1분 분량이라 100만 자는 약 1,000분이다. 같은 모델이라도 제공사에 따라 6배 넘게 차이 난다.
윈도우에서 espeak not installed 오류가 나면 어떻게 하나요?
espeak-ng 깃허브 릴리스에서 espeak-ng.msi를 받아 설치한 뒤에도 오류가 나면 파이썬이 DLL 위치를 못 찾는 경우가 많다. 공식 이슈 #101에서는 스크립트 맨 위에 PHONEMIZER_ESPEAK_LIBRARY 환경 변수로 libespeak-ng.dll 경로를 지정하는 방법이 공유됐다. 영어만 쓴다면 espeak-ng 의존성이 함께 설치되는 kokoro-onnx를 쓰는 방법도 있다.
Kokoro 보이스 중 어떤 것이 가장 자연스러운가요?
VOICES.md 종합 등급으로는 미국 영어 여성 af_heart가 A, af_bella가 A-로 가장 높다. 영국 영어는 bf_emma가 B-로 가장 높고, 남성 보이스는 am_michael, am_fenrir, am_puck이 C+다. 영어 외 언어는 대부분 C 이하라 품질 차이가 크다.
브라우저에서 Kokoro를 쓰면 서버 비용이 드나요?
kokoro.js는 방문자 브라우저가 모델을 내려받아 WebGPU나 WASM으로 직접 음성을 만들기 때문에 TTS 서버 비용이 들지 않는다. 다만 첫 방문 때 q8 기준 약 92MB 모델을 받아야 한다. 모바일 데이터 환경에서는 이 다운로드가 부담이 될 수 있다.
용어
관련 용어
LLM이 텍스트를 처리하는 기본 단위로, AI 모델의 비용 산정과 성능을 이해하는 데 가장 기본이 되는 개념이다. 토크나이저(tokenizer)라는 알고리즘이 텍스트를 토큰으로 분할하며, 단어 하나가 반드시 토큰 하나가 되는 것은 아니다. 영어의 경우 대략 단어 1개 ≈ 1~1.5 토큰이지만, 한국어는 음절 단위로 분할되어 같은 의미의 텍스트가 영어보다 2~3배 많은 토큰을 소비한다(예: '안녕하세요' ≈ 3~5 토큰). 코드의 경우 'console.log("Hello World")' ≈ 약 6토큰이다. 토큰은 AI 코딩 도구의 사용량과 비용을 결정하는 핵심 단위로, API 과금은 입력 토큰과 출력 토큰을 각각 계산한다. 모델마다 다른 토크나이저를 사용하므로, 같은 텍스트도 모델에 따라 소비하는 토큰 수가 다를 수 있다. 바이브 코딩에서 예상보다 비용이 높아지는 주요 원인이 토큰 소비이므로, 컨텍스트 엔지니어링을 통해 불필요한 토큰 소비를 줄이는 것이 비용 관리의 핵심이다.
AI 모델·프로바이더 클로드Anthropic이 개발한 AI 모델 시리즈로, 안전성(safety), 정직성(honesty), 유용성(helpfulness)을 핵심 원칙으로 설계되었다. 바이브 코딩에서 가장 널리 사용되는 모델 중 하나이며, 깊은 코드 이해, 상세한 설명 생성, 100만 토큰의 업계 최대급 컨텍스트 윈도우가 주요 강점이다. 현재 Claude 4 패밀리로 구성되어 있으며, Claude Opus 4.6(가장 강력한 최상위 모델), Claude Opus 4.5, Claude Opus 4.1, Claude Opus 4, Claude Sonnet 4의 다섯 가지 모델이 있다. Opus 계열은 복잡한 추론과 대규모 코드 분석에, Sonnet 계열은 빠른 응답과 비용 효율에 최적화되어 있다. Claude Code(CLI 도구)를 통해 터미널에서 직접 사용하거나, Cursor·Windsurf 등 제3자 IDE에서 모델로 선택할 수 있다. API 모델 문자열은 'claude-opus-4-6'이며, 웹·모바일·데스크톱 채팅 인터페이스를 통해서도 접근 가능하다. Constitutional AI라는 독자적인 안전 기술로 유해한 출력을 최소화하면서도 유용한 코드 생성을 유지하는 것이 특징이다.
백엔드·인프라 수파베이스Google의 Firebase에 대한 오픈소스 대안으로, PostgreSQL 기반의 백엔드 서비스(인증, 실시간 데이터베이스, 파일 스토리지, Edge Functions, 벡터 검색)를 올인원으로 제공한다. 바이브 코딩으로 만드는 앱에서 가장 인기 있는 백엔드 선택지 중 하나이며, 특히 Lovable(러버블)과의 깊은 통합으로 유명하다. Supabase의 가장 큰 매력은 '바이브 코딩과의 궁합'이 뛰어나다는 점이다: SQL 기반이므로 AI가 스키마 정의와 쿼리 생성을 정확히 수행할 수 있고, Row Level Security(행 수준 보안)로 데이터 접근 제어를 선언적으로 정의할 수 있으며, 자동 생성되는 REST API와 실시간 구독으로 별도의 API 서버 코드가 필요 없다. 오픈소스이므로 자체 호스팅도 가능하고, 무료 티어가 넉넉하여 프로토타이핑에 비용 부담이 없다. AI에게 'Supabase로 백엔드 만들어줘'라고 하면 DB 스키마, RLS 정책, 인증 설정, 실시간 구독 코드까지 한 번에 생성된다.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
MCP 서버 추천 60선 | 개발, DB, 클라우드, 3D까지 종류별 연결법과 윈도우 설정
MCP(Model Context Protocol)는 Claude, Cursor, Codex 같은 AI 앱이 바깥 프로그램을 직접 읽고 조작하도록 이어 주는 공개 연결 규격이다. 깃허브 저장소, 노션 문서, 슬랙 대화, 데이터베이스, 웹 브라우저, 블렌더 같은 3D 프로그램까지 "MCP 서버"를 하나 연결하면 AI가 그 프로그램의 기능을 도구처럼 호출한다. 사람이 화면을 복사해 채팅창에 붙여 넣던 일을 AI가 직접 하게 되는 셈이다.
MCP는 Anthropic이 2024년 11월 공개했고, 2025년 12월 9일 리눅스 재단 산하 Agentic AI Foundation에 기증되어 특정 회사가 아닌 공동 관리 규격이 됐다. 2026년 10월 현재 Claude 앱과 Claude Code, Cursor, VS Code, Codex, Gemini CL…
Gemini 4 Argon 드디어 공개 | 누가 쓸 수 있고 얼마인지, 윈도우에서 API·Antig…
Gemini 4 Argon(제미나이 4 아르곤)은 구글이 10월 13일(한국 시간 10월 14일 새벽 1시)에 정식으로 풀기 시작한 최상위 AI 모델이다. 지금까지 구글의 가장 강한 모델이던 Gemini 3.1 Pro 다음 세대에 해당하고, 구글은 이 모델을 코딩, 기업 업무, 사이버 보안 방어 세 분야를 겨냥해 만들었다고 설명한다. 이름 끝의 "Argon"은 크기 등급이 아니라 이번 세대 첫 모델에 붙인 이름이다. 한 번의 답변으로 최대 100만 토큰까지 길게 써 내려갈 수 있다는 점이 가장 눈에 띄는 변화다.
바이브 코딩을 하는 사람에게 중요한 질문은 세 가지다. 어디서 쓸 수 있는지, 돈이 얼마나 드는지, 내가 쓰는 도구에 바로 붙일 수 있는지다. 결론부터 말하면 무료로는 쓸 수 없다. Google AI Ultra 구독자이거나, 결제를…