바이브코딩
Meta Muse Ember | 반복 에이전트 작업과 20만 토큰 가격
도구 호출과 코딩 하위 작업을 맡는 muse-ember-1.0의 구간 요금과 맥스 벤치
Meta Superintelligence Labs는 2026년 11월 9일 Muse Ember를 공개했다. 공식 블로그가 붙인 자리는 가장 작고 가장 효율적인 Muse 계열 모델이다. 복잡한 추론을 실행하는 쪽이고, 에이전트가 하루 종일 반복하는 도구 호출, 코딩 하위 작업, 요청 분류, 필드 추출, 긴 문서 읽기를 맡긴다.
모델 아이디는 muse-ember-1.0이다. 글, 이미지, 영상, 오디오, PDF를 넣고 글만 돌려준다. 문맥 창은 1,048,576토큰이고 한 번의 출력은 최대 524,288토큰이다. 파라미터 수는 공개되지 않았고, 가중치를 받아 로컬에 올리는 모델도 아니다.
입력 20만 토큰 이하이면 100만 토큰당 입력 0.10달러, 캐시된 입력 0.004달러, 출력 0.50달러다. 입력이 20만을 넘으면 그 요청 전체가 입력 0.30달러, 캐시 입력 0.012달러, 출력 1.50달러로 바뀐다. 넘친 구간만 할증되는 구조가 아니다. 가격과 문서의 조사 기준일은 2026년 11월 10일이다.
비교 숫자의 1차는 Meta 연구 블로그가 2026년 11월 9일에 올린 맥스 추론 표다. Artificial Analysis가 같은 날 올린 게시와 점수가 다른 항목은 같은 칸에 넣지 않는다. Cloudflare와 You.com이 말한 지연과 토큰 절감은 각 회사의 초기 시험 인용이다.
Muse Ember가 하는 일
엠버는 큰 모델을 같은 형식으로 수천 번 부르는 자리를 나누려고 나왔다. 블로그는 에이전트 토큰의 대부분이 작고 형식이 정해진 단계에 쓴다고 적는다. 기록을 꺼내고, 도구를 순서대로 부르고, 앱을 넘어 상태를 고치는 흐름이다.
문서가 꼽는 반복 작업은 네 묶음이다. 메인 에이전트가 넘긴 짧은 코딩, 터미널 명령, 조회가 하나다. 워크플로 안의 도구 호출이 다음이다. 호출마다 지연과 돈이 쌓이므로 단가가 낮은 모델이 맞다. 요청을 분류해 핸들러나 다른 모델로 보내는 라우팅이 있고, 사진 캡션, 필드 추출, 티켓 분류처럼 같은 일을 수천 건에 병렬로 돌리는 배치가 있다.
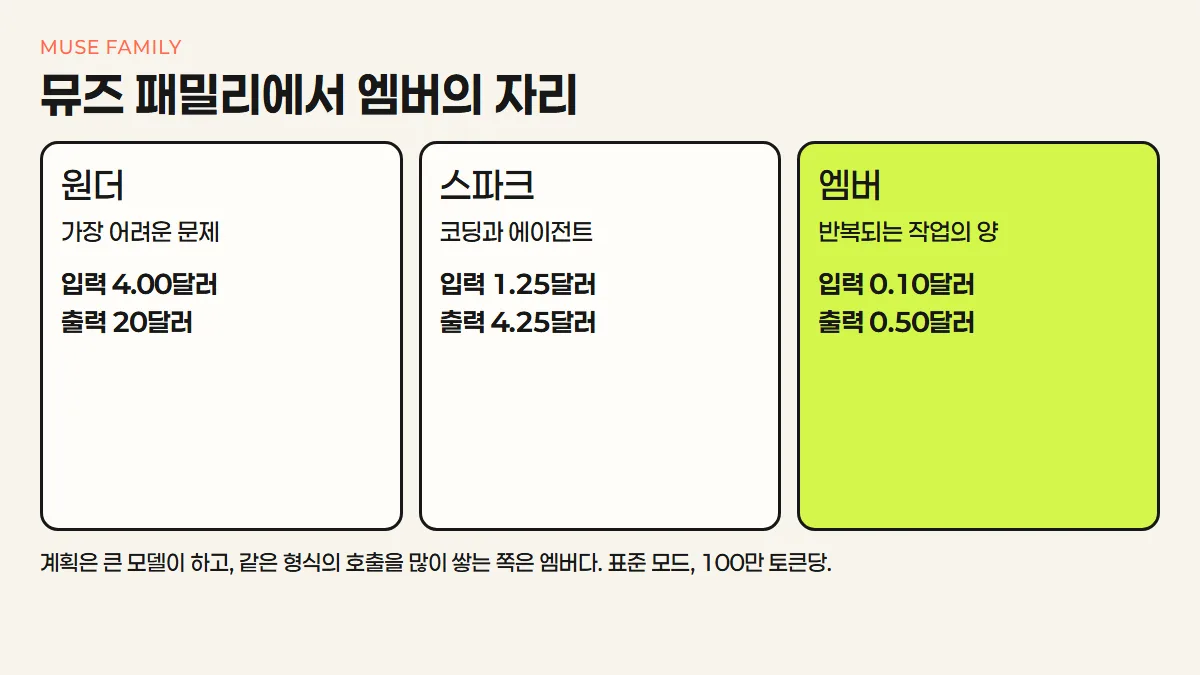
학습 계보도 블로그가 명시했다. Muse Wonder Full로 만든 첫 특화 모델이다. 포트폴리오는 세 칸이다. Wonder는 가장 어려운 문제, Spark는 코딩과 에이전트 워크플로, Ember는 반복 가능한 코딩과 에이전트 작업을 규모 있게 돌리는 칸이다. TechCrunch는 엠버를 Muse 브랜드의 네 번째 공개로 적었다. Spark가 4월, Glimmer가 8월, Wonder가 10월, Ember가 11월 9일이다.
한 문장으로 줄이면, 계획을 세우는 큰 모델 옆에 두고 같은 형식의 하위 작업을 많이 시키는 실행 모델이다. 한 번의 아주 어려운 코딩을 혼자 끝내는 용도로 문서가 권하지 않는다. 그 자리는 Spark나 Wonder다.
핵심 포인트: 입력 20만 토큰을 넘는 요청은 넘친 토큰만 비싸지는 것이 아니라, 그 요청의 입력과 출력이 모두 상위 단가다.
쓸 수 있는 곳과 가격
당일부터 Meta Model API와 Muse Code에서 쓸 수 있다. Model API는 종량제다. Muse Code는 종량제와 모든 구독 플랜에 들어 있다. Model API의 엠버는 Standard 모드만 있다. Contributor 모드 변형 아이디는 없다. Spark 1.3과 1.2만 muse-spark-1.3-contributor 같은 별도 아이디로 기여자 할인을 연다. Wonder와 Ember는 API에서 그 할인이 없다. Standard에서는 보낸 내용이 이후 모델 학습에 쓰이지 않는다고 가격 문서가 적는다.
Muse Code 구독의 기본값은 Contributor 모드이고 설정에서 끌 수 있다. 이것은 제품 설정이다. 엠버에 API 기여자 변형이 생겼다는 뜻은 아니다. 구독 안에서 입력 20만을 넘는 요청은 플랜 사용량을 더 빨리 깎는다.
가격 구간의 기준은 요청의 입력 토큰이다. 캐시된 토큰도 입력에 포함된다. previous_response_id로 저장된 대화를 이어 가면 그 대화도 입력에 들어간다. 20만 이하와 초과는 청구서에 따로 찍힌다.
| 구분 | 입력 20만 토큰 이하 | 입력 20만 토큰 초과 |
|---|---|---|
| 캐시 입력 | 100만 토큰당 0.004달러 | 100만 토큰당 0.012달러 |
| 입력 | 100만 토큰당 0.10달러 | 100만 토큰당 0.30달러 |
| 출력 | 100만 토큰당 0.50달러 | 100만 토큰당 1.50달러 |
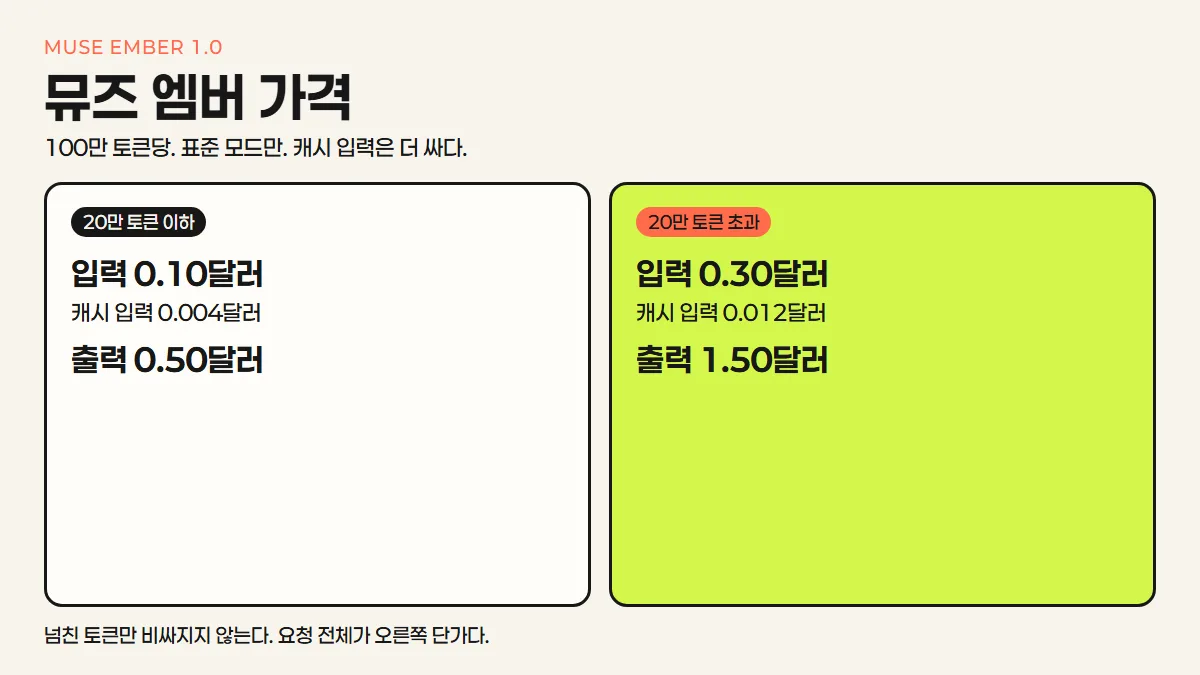
가격 문서의 단가에 토큰 수를 그대로 대입하면 경계의 크기가 보인다. 입력 18만 토큰, 캐시 없음, 출력 8,000토큰이면 입력 0.018달러에 출력 0.004달러를 더해 0.022달러다. 입력을 22만으로 올리면 출력은 같은 8,000토큰인데도 요청 전체가 상위 구간이라 입력 0.066달러, 출력 0.012달러, 합계 0.078달러다. 입력이 약 22퍼센트 늘었을 뿐인데 청구는 세 배 이상으로 뛴다.
캐시가 있으면 하위 구간이 더 얇아진다. 입력 18만 가운데 15만이 캐시 히트면 신선 입력 3만은 0.003달러, 캐시 15만은 0.0006달러다. 반복 프롬프트의 앞부분이 같으면 캐시 단가 0.004달러는 본입력 0.10달러의 25분의 1이다. 응답의 cached_tokens로 실제 히트를 본다.
웹 검색 그라운딩은 토큰과 별도다. web_search 도구는 검색 1,000회당 2.50달러다. Wonder, Spark, Ember에 공통이다. Muse Image의 이미지 검색은 이 줄과 다르고, 이미지당 0.01달러에 포함된다. 엠버는 이미지를 생성하지 않는다.
한도는 팀 단위다. 키마다 따로 쌓이지 않는다. muse-ember-1.0은 분당 3,000요청, 분당 400만 토큰이다. 다른 모델로 간 트래픽과 이 한도를 나누지 않는다. background: true로 백그라운드 응답을 새로 여는 것은 팀당 분당 600건이 추가 상한이다. 이미 도는 작업은 그 상한과 무관하고, 넘치면 HTTP 429와 Retry-After가 온다. 가격 문서는 429에 지수 백오프와 지터를 권하고, 성공 응답의 x-ratelimit-remaining-tokens와 x-ratelimit-remaining-requests를 먼저 보라고 적는다. Meta가 프롬프트에 넣는 짧은 스티어링 토큰은 청구와 사용량 집계에서 빠진다.
추론 강도는 "minimal"에서 "max"까지다. 기본값은 "max"다. "none"은 없다. 기본이 최대라서 짧은 분류에도 추론 토큰이 출력에 붙을 수 있다. 출력 단가는 하위 구간에서 입력의 다섯 배이므로 강도를 내리는 선택이 청구에 바로 보인다. 엔드포인트는 Responses, Chat Completions, Messages다. 요청 본문 형태는 Spark와 같아서, 많은 예제는 model 값만 muse-ember-1.0으로 바꾸면 된다. 컴퓨터 사용, 이미지 이해, 도구 호출, 구조화 출력, 검색 그라운딩을 문서가 지원 기능으로 적는다.
Responses API에 모델 아이디를 넣어 티켓을 한 줄로 나누는 호출은 아래 JSON이다.
{
  "model": "muse-ember-1.0",
  "input": "Classify this support ticket as billing, bug, or feature request."
}
주소는 https://api.meta.ai/v1/responses이고 인증 헤더는 Bearer MODEL_API_KEY다. Python과 TypeScript는 퀵스타트의 첫 호출에서 모델 값만 바꾸라고 문서가 안내한다.
데일리챗은 입력 100만 토큰당 0.10달러를 제목에 넣어 가장 작은 모델로 엠버를 소개했다.
영상 1. 입력 단가 0.10달러를 제목으로 뮤즈 엠버를 설명한 영상. 출처: YouTube 채널 DailyChat
테오(t3.gg)의 영상 Meta's Claude Code clone is INSANELY cheap는 엠버 출시 영상이 아니다. 뮤즈 코드의 가격을 다루는 가족 맥락이다.
OpenRouter에서 쓰기
OpenRouter 목록과 소개 페이지에 meta/muse-ember가 올라 있다. 표기 이름은 Meta: Muse Ember이고, 제공자는 Meta 하나다. Fireworks Ember-1과는 다른 모델이다. 페이지의 Released는 2026년 11월 9일이고, API created는 2026년 11월 10일 03:07:28 KST다.
리스트 단가는 100만 토큰당 입력 $0.10, 출력 $0.50, 캐시 읽기 $0.004, 캐시 쓰기 $0.125다. 입력, 출력, 캐시 읽기는 Meta 공식의 20만 토큰 이하 구간과 같다. 캐시 쓰기 $0.125는 OpenRouter 목록의 줄이다. 웹 검색은 호출 1,000회당 $2.50이다.
| 구분 | 100만 토큰당 |
|---|---|
| 입력 | $0.10 |
| 출력 | $0.50 |
| 캐시 읽기 | $0.004 |
| 캐시 쓰기 | $0.125 |
문맥 길이는 1,048,576토큰이다. 입력은 텍스트, 이미지, 비디오, 파일, 오디오이고 출력은 텍스트다. 최대 완성 토큰은 943,718로 적혀 있다. Meta 문서의 최대 출력 524,288과는 다른 칸이다. 추론은 기본이 max이고, 강도는 max, xhigh, high, medium, low, minimal이다. 도구 호출, tool_choice, 구조화 출력, 추론을 지원 항목으로 적는다.
모델 카드는 OpenRouter Muse Ember다.
OpenRouter 채팅 완성에 모델 아이디를 넣어 티켓을 나누는 요청은 아래 JSON이다.
{
  "model": "meta/muse-ember",
  "messages": [
    {
      "role": "user",
      "content": "Classify this support ticket as billing, bug, or feature request."
    }
  ]
}
주소는 https://openrouter.ai/api/v1/chat/completions이고 인증 헤더는 Bearer OPENROUTER_API_KEY다.
벤치마크와 비용
블로그의 비용 문장은 이렇다. 어느 추론 설정에서도 Claude Haiku 5.5나 GPT-6 Luna보다 달러당 지능이 높고, Haiku의 최고 점수에 약 3분의 1 비용으로 맞추며, Luna의 모든 설정보다 점수가 높다. Artificial Analysis 리더보드의 효율 프론티어에 있고, 과제당 비용이 더 낮은데 점수가 더 높은 모델은 없다고 적는다. 블로그가 든 과제당 약 0.14달러는 고시 가격으로 환산한 추정치다. 같은 페이지는 추론 강도마다 과제당 비용을 점으로 그리지만, 아래 표는 맥스로 고정해 나란히 적은 평가만 옮긴다.
맥스 추론에서 블로그가 나란히 둔 숫자만 아래에 둔다.
| 평가 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 부분 / 이진 | 69.5 / 33.8 | 68.9 / 27.8 | 50.5 / 17.0 |
| PerceptionBench, 도구 사용 | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Index | 36 | 36 | 28 |
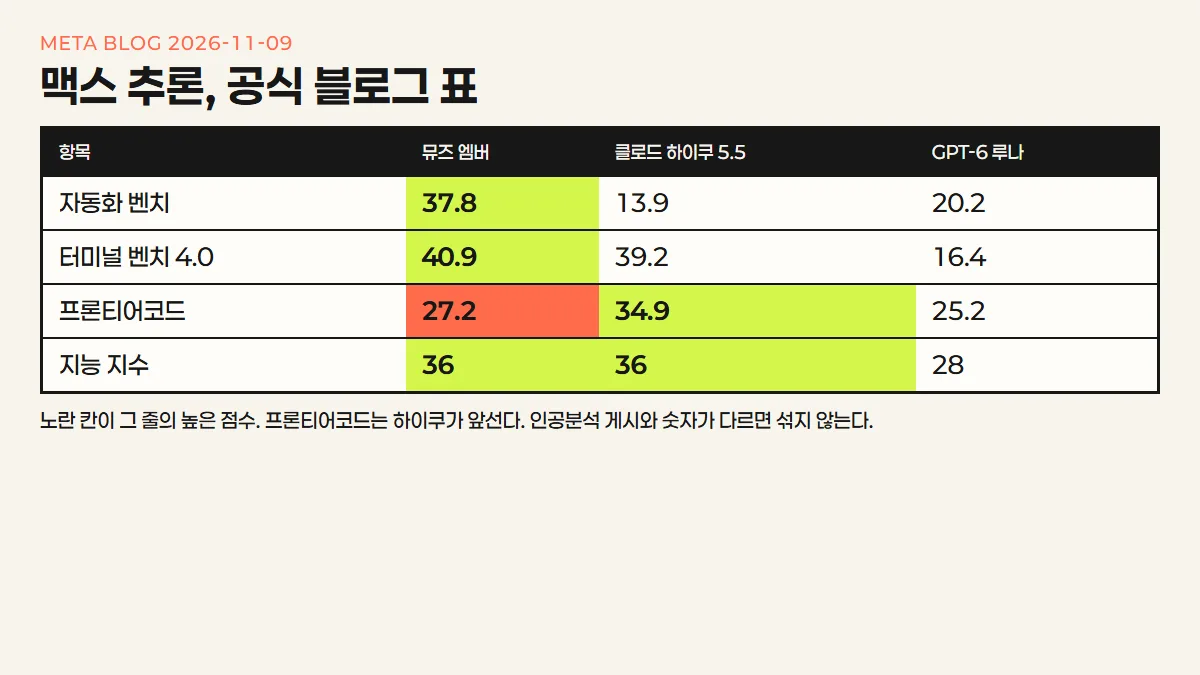
프론티어코드는 따로 읽어 둔다. Haiku 5.5가 34.9로 엠버 27.2보다 높다. Luna는 25.2다. 지능 지수는 엠버와 Haiku가 36으로 같고 Luna는 28이다. GDP.pdf는 엠버와 Luna가 22.8로 같고 Haiku는 20.8이다. 자동화 벤치는 37.8 대 13.9 대 20.2로 엠버 간격이 가장 크다. 터미널 벤치는 40.9로 Haiku 39.2와 가깝고 Luna 16.4와는 멀다.
각주가 하니스 차이를 밝힌다. Terminal-Bench 4.0은 모델마다 공개된 최선의 하니스를 썼다. 엠버는 mini-swe-agent, Haiku는 Claude Code, Luna는 Codex다. OSWorld 2.1의 69.5는 부분 점수이고 33.8은 이진 점수다. PerceptionBench 80.6은 도구를 켠 점수다. Agents' Last Exam 61.6은 Meta 내부 평가의 Linux 부분집합이다. Personal Superintelligence Index는 내부 합성으로, Agents' Last Exam, AutomationBench, FocusBench, JobBench, OfficeQA Pro, GDP.pdf, GDP.xlsx, VBT 여덟 개를 묶는다. 내부 항목과 Artificial Analysis 항목이 한 표에 같이 있어도 출처 열이 다르다는 뜻이다.
Artificial Analysis 계정은 같은 날 다른 숫자를 올렸다. AutomationBench-AA를 68.1퍼센트로 적었고, Terminal-Bench 4.0에서 Haiku를 32.8퍼센트로 적었다. 블로그 표의 37.8, 그리고 Haiku 39.2와 다르다. 하니스나 집계 시점이 다를 수 있으므로 비교 칸은 블로그 표를 유지한다. AA가 추가로 적은 내용 가운데 블로그 표에 없는 것은 지식 평가다. AA-Omniscience 정확도 21.1퍼센트, 질문의 64퍼센트를 답 거절, 환각률 17.4퍼센트다. AA는 이 환각률이 Haiku 맥스 설정의 절반이라고 적었다. 코딩 에이전트 지수 46은 Muse Code 안의 엠버이고, Haiku 37은 Claude Code, Luna 31은 Codex라고 AA도 블로그와 같이 적었다. AA는 캐시 입력이 Haiku, Luna보다 60퍼센트 싸고, 평가에서 엠버 맥스가 Haiku 맥스보다 출력 토큰을 대략 3분의 1만 쓴다고도 적었다. 그 토큰 비율은 AA 집계다.
스파크 1.3 맥스와의 블로그 비교는 세 줄이다. 지능 지수 36 대 37, 과제당 비용 약 0.14달러 대 2.39달러, 고시 가격은 입력 0.10달러와 출력 0.50달러 대 입력 1.25달러와 출력 4.25달러다. AA는 Wonder 맥스가 지수 44에 과제당 6.95달러라고 적어, 엠버가 8점 낮고 비용은 약 50분의 1이라고 말했다. 6.95달러는 AA 게시 수치다.
파트너 문장은 자체 측정이 아니다. Box의 야쇼다 바브나니는 계약서를 협상 플레이북과 조항별로 맞추고, 후보자 브리프에서 경계선 후보를 고르는 일을 예로 들었다. Cline의 사우드 리즈완은 서브에이전트의 코딩과 문서 분석에 맞다고 적었다. Oracle의 콘스탄티노스 파파밀티아디스는 초기 시험에서 복잡한 엔지니어링 과제를 다루는 쪽이 보였다고 적었다. Cloudflare의 데인 크네히트는 비교 대상보다 꼬리 지연이 최대 30퍼센트 짧았고, 여러 저장소를 넓게 보는 조사에 맞았다고 말했다. You.com의 차크 포티나는 자사 코딩 퀘스트에서 p95 2.2초였고, 출력 토큰이 36퍼센트에서 48퍼센트 적었으며, 시험한 오픈 웨이트 모델보다 4배에서 13배 빠르다고 말했다. 2.2초와 30퍼센트는 각 사의 시험 조건이다.
아레나 채널은 엠버를 리더보드 자리에 올려 출시 당일 영상을 냈다.
영상 2. 뮤즈 엠버를 아레나 리더보드 맥락에서 소개한 영상. 출처: YouTube 채널 Arena
입력 형식과 긴 문맥
입력은 글, 이미지, 영상, 오디오, PDF다. 출력은 글뿐이다. 이미지를 새로 그리는 모델이 아니다. 스크린샷, 차트, 스캔 문서, 음성 메모, 회의 녹음, 영상을 같은 호출에서 읽고 글로 답한다. 블로그는 긴 실제 문서를 읽고, 스크린샷으로 컴퓨터를 직접 다루며, 시각의 세부도 고른다고 적는다.
문맥 1,048,576은 블로그의 1M과 같고, 문서가 정확한 정수로 적는다. 최대 출력 524,288은 블로그의 512K와 같다. 블로그는 코드베이스나 문서 묶음을 한 호출에 넣을 수 있다고 적는다. 다만 입력이 20만을 넘는 순간 요청 전체의 단가가 바뀌므로, 1M 창을 가득 채우는 호출과 문서를 나눠 20만 아래에 두는 호출은 다른 상품이다. Wonder와 Spark는 창이 길어져도 단가가 그대로다. 긴 문맥 할증은 엠버에만 있다.
긴 문서 점수는 GDP.pdf-AA다. 맥스에서 엠버 22.8, Luna 22.8, Haiku 20.8이다. 화면을 보고 컴퓨터를 움직이는 OSWorld 2.1은 부분 점수 69.5로 Haiku 68.9, Luna 50.5보다 높고, 이진 점수는 33.8 대 27.8 대 17.0이다. 시각 세부 PerceptionBench는 도구를 켠 80.6으로 Haiku 78.6, Luna 62.8보다 높다. 세 숫자 모두 블로그 표의 맥스다.
구조화 출력은 라우팅과 추출에서 JSON 스키마를 고정할 때 문서가 안내하는 다음 기능이다. 검색이 필요하면 토큰 외에 검색 1,000회당 2.50달러가 붙는다. 배치로 이미지를 수천 장 캡션할 때도 출력은 글이고, 이미지 파일 자체가 답으로 나오지 않는다.
Wonder와 Spark와 나누는 일
문서의 짝짓기는 분명하다. 메인 루프의 계획과 추론은 Wonder나 Spark가 하고, 반복 하위 작업은 Ember가 받는다. 같은 요청 본문을 쓰므로 하니스는 model 필드만 갈라 주면 된다. 한 번의 어려운 코딩, 지식이 무거운 질문, 화면을 보고 코드를 짜는 일은 Spark나 Wonder 쪽이라고 선택 문서가 적는다. 엠버끼리만 이어 붙여 계획을 대신하게 두는 구성은 그 문서의 문장과 어긋난다.
표준 모드 고시 가격으로 입력과 출력을 나란히 두면 역할이 돈으로도 갈린다. Wonder 1.0은 입력 4.00달러, 캐시 입력 0.20달러, 출력 20달러다. 장문 할증이 없다. Spark 1.3 표준은 입력 1.25달러, 캐시 0.15달러, 출력 4.25달러다. 역시 창이 가득 차도 단가가 그대로다. Ember의 하위 구간은 입력 0.10달러, 출력 0.50달러다. 출력만 비교해도 Wonder는 엠버의 40배, Spark는 8.5배다. 입력이 20만을 넘어 엠버 출력이 1.50달러가 되어도 Wonder 출력 20달러, Spark 출력 4.25달러보다는 낮다.
안전 평가는 출시 전에 Meta Superintelligence Scaling Framework로 했다. 화학과 생물, 사이버, 통제 상실이 포함되고, 평가한 범주에서 고위험 임계 아래였다고 블로그가 적는다. 작은 모델이라도 핵심 안전 학습과 시험은 같았다고 한다. 사용자를 대신해 행동할 때의 평가도 있다. 사용자 의도를 지키는지, 민감 정보를 다루는지, 웹 페이지와 문서와 도구 출력에 숨은 지시가 경로를 바꾸려 할 때 버티는지, 영향이 큰 행동 전에 사람에게 묻는지다. 임계의 원점수표는 블로그 본문에 없다.
블로그의 마지막 문장은 개인용 초지능을 모두가 쓸 가격으로 내리는 쪽이다. 더 효율적인 모델이 학습 중이라고만 적혀 있고, 이름과 날짜는 없다.
호출 전에 보는 조건
종량 청구가 바뀌는 지점은 입력 20만 토큰 한 줄이다. 대화를 이어서 붙이다가 그 선을 넘으면 이전 턴까지 포함한 입력 전체가 상위 단가다. 배치로 수천 건을 돌릴 때는 건마다 20만 아래인지가 청구서의 단가 열을 가른다. 캐시 히트는 단가를 낮추지만 구간의 기준 토큰 수에서는 빠지지 않는다.
기본 추론이 max라서 분류 한 줄에도 출력 토큰이 길어진다. 강도는 minimal까지 내릴 수 있고, 블로그는 그 강도별 과제당 비용을 차트로만 보여 준다. 맥스 표의 37.8이나 지수 36을 차트 위의 더 싼 점에 옮겨 적으면 다른 설정의 점수가 된다.
가중치는 공개되지 않았다. 파라미터 수도 공개되지 않았다. 다운로드해서 자체 GPU에 올리는 경로를 블로그와 API 문서가 제시하지 않는다. 출시 글 아래에는 받아 쓸 수 있는지 묻는 답이 있었고, 공식 경로는 API와 Muse Code다.
지식 질문에서 답을 거절하는 비율이 높다는 AA 서술을 라우터에 반영할 수 있다. 거절이 많으면 환각은 줄지만, 사실 조회를 엠버 한 곳에만 맡기면 빈 답이 쌓인다. 사실 확인이 본업인 단계는 Spark나 검색 도구 쪽으로 보내고, 엠버는 이미 정해진 스키마로 필드를 뽑는 쪽에 두는 짝이 문서의 역할 분담과 맞다.
웹 검색을 매 턴 켜 두면 토큰 단가와 별도로 1,000회당 2.50달러가 자란다. 반복 서브에이전트가 매번 검색하면 0.10달러 입력이 본비용이 아니게 된다. 검색은 추출이 막혔을 때의 도구로 두고, 기본 루프의 필드 채우기에는 붙이지 않는 편이 가격 문서의 줄과 맞다.
공개 당일 반응
수치는 2026년 11월 10일 KST에 해당 게시의 공개 카운터를 다시 읽은 값이다. 이후 좋아요와 조회는 변한다.
마크 저커버그 계정은 출시 글에서 엠버를 급에서 달러당 지능이 더 높은 가장 작은 모델이라고 적고, 도구 호출, 코딩 하위 작업, 라우팅, 추출, 긴 문서 파싱을 나열했다. 게시 2119851180948152590은 좋아요 2,509, 리포스트 203, 답글 200, 조회 91,887이었다. 사용처로 Meta Model API와 Muse Code를 적었다.
AI at Meta 스레드의 첫 글 2119853591703998787은 좋아요 524, 리포스트 60, 답글 51, 조회 24,680이었다. 워크플로를 앱 너머로 잇고, 도구를 순서대로 부르며, 테스트를 돌리고 코드를 골라 고친다고 적었다. 이어지는 글 2119853595453702580은 좋아요 62, 조회 4,728이었고, 지수에서 Haiku와 비슷한 성능에 과제당 비용이 약 3분의 1이며 Luna의 모든 추론 설정보다 높다고 적었다. 세 번째 글 2119853597542568405는 좋아요 39, 조회 3,750이었고, API 가격을 입력 0.10달러, 출력 0.50달러로 반복한 뒤 연구 블로그 주소를 달았다.
Artificial Analysis 게시 2119854348587123007은 좋아요 129, 리포스트 6, 답글 24, 조회 14,840이었다. 지수 36이 Haiku 맥스와 같고 과제당 0.14달러이며 Haiku 맥스는 0.41달러라는 비교가 본문에 있다. 자동화 벤치 68.1퍼센트, 터미널 벤치에서 Haiku 32.8퍼센트, 지식 정확도 21.1퍼센트와 답 거절 64퍼센트, 환각률 17.4퍼센트는 같은 스레드의 이어지는 글에 있다. 자동화 벤치와 터미널 벤치의 Haiku 점수는 블로그 표와 다르므로 벤치 절의 표를 이 게시로 갈아 끼우지 않는다.
TestingCatalog 게시 2119852955885297719는 좋아요 83, 조회 4,335였고 저커버그 글을 인용했다. 본문은 Haiku와 비슷하다는 짧은 소개다. 답글에는 작은 모델이 반복을 맡고 큰 모델이 어려운 생각을 맡는다는 읽기와, 20만 토큰을 넘으면 요청 전체가 세 배라는 가격 페이지 인용이 있었다. 다운로드를 묻는 답글은 AI at Meta 출시 글 아래에 있었고 좋아요 6, 조회 635였다.
뉴럴 데일리는 가장 싼 모델이라는 제목으로 출시 영상을 올렸다. 제목의 최상급은 채널 문장이다. 고시 비교로 블로그가 직접 놓은 범위는 Haiku, Luna, 그리고 Spark 1.3의 가격이다.
영상 3. 뮤즈 엠버 출시를 가격이 낮은 쪽으로 소개한 영상. 출처: YouTube 채널 Neural Daily
마무리
앞에서 다룬 Muse Ember의 역할과 가격, 표의 읽기를 짧게 모은다.
- 2026년 11월 9일 공개된 실행 모델이고 아이디는 muse-ember-1.0이다.
- 도구 호출, 코딩 하위 작업, 라우팅, 추출, 긴 문서 파싱처럼 반복되는 구간에 둔다.
- 입력 20만 토큰 이하는 100만 토큰당 0.10달러, 0.004달러, 0.50달러다.
- 20만을 넘으면 요청 전체가 0.30달러, 0.012달러, 1.50달러다.
- 블로그 맥스 표에서 지능 지수는 Haiku와 같은 36이고, 프론티어코드는 Haiku 34.9가 엠버 27.2보다 높다.
- Wonder Full로 학습한 첫 특화 모델이며 가중치와 파라미터 수는 공개되지 않았다.
- 가격과 리더보드 점수는 바뀐다. 청구 전에는 가격 문서의 구간을 다시 본다.
「반복 호출의 단가와 20만 토큰 경계가 이 모델의 조건이다」 계획과 어려운 한 방은 더 큰 Muse 모델에 두고, 같은 형식의 하위 작업이 쌓이는 자리에 엠버를 둔다.
출처와 링크
조사 기준: 2026년 11월 10일 Asia/Seoul. 블로그와 가격 문서는 2026년 11월 9일에서 10일 사이 공개본이다. OpenRouter 목록과 소개 페이지는 같은 날 다시 확인했다. X 카운터는 2026년 11월 10일에 다시 읽었다.
FAQ
자주 묻는 질문
Muse Ember는 어떤 작업에 두나요?
메인 에이전트가 이미 쪼갠 짧은 코딩, 터미널 명령, 조회, 도구 호출, 요청 분류, 필드 추출에 둔다. 한 번의 아주 어려운 설계는 Spark나 Wonder 쪽에 남긴다. 모델 아이디는 muse-ember-1.0이다.
입력 20만 토큰을 넘으면 요금이 어떻게 바뀌나요?
넘친 토큰만 오르지 않는다. 그 요청의 입력, 캐시 입력, 출력이 모두 상위 단가로 바뀌어 100만 토큰당 0.30달러, 0.012달러, 1.50달러가 된다. 캐시된 토큰도 20만 판정에 포함된다.
파라미터 수와 가중치는 공개됐나요?
둘 다 공개되지 않았다. 블로그와 API 문서는 로컬 GPU에 올려 쓰는 경로를 제시하지 않고, 당일 제공 경로는 Meta Model API와 Muse Code다.
프론티어코드에서는 어느 모델이 앞섰나요?
Meta 블로그의 맥스 표에서는 Claude Haiku 5.5가 34.9로 Muse Ember 27.2보다 높다. GPT-6 Luna는 25.2다. 지능 지수는 엠버와 Haiku가 둘 다 36이다.
Artificial Analysis의 자동화 벤치 숫자와 블로그 표가 다른 이유는 무엇인가요?
AA 게시는 AutomationBench-AA를 68.1퍼센트로 적었고 블로그 표는 37.8이다. 하니스나 집계 시점이 다를 수 있어 한 칸에 합치지 않는다. 이 글의 비교 표는 블로그 맥스 숫자를 유지한다.
Contributor 모드로 더 싸게 호출할 수 있나요?
Model API의 엠버에는 기여자 변형 아이디가 없다. Standard만 있고, 그 모드에서는 보낸 내용이 이후 학습에 쓰이지 않는다고 가격 문서가 적는다. Spark 1.3과 1.2만 별도 기여자 아이디가 있다.
Muse Spark와 요청 형식은 같나요?
문서상 요청 본문은 Spark와 같고, model 값만 muse-ember-1.0으로 바꾸면 된다. 엔드포인트는 Responses, Chat Completions, Messages다. 기본 추론 강도는 max이고 none은 없다.
OpenRouter에서 바로 쓰려면 모델 값은 무엇인가요?
채팅 완성 본문의 model에 meta/muse-ember를 적으면 그 경로로 호출된다. 목록이 보여주는 입력은 100만 토큰당 0.10달러, 출력은 0.50달러다. 캐시 읽기와 캐시 쓰기는 그 목록에 따로 있다.
용어
관련 용어
긴 대화 이력이나 대규모 컨텍스트를 요약·압축하여 컨텍스트 윈도우를 효율적으로 사용하는 기술로, 컨텍스트 부패(Context Rot)를 방지하는 핵심 전략이다. 데이터베이스의 컴팩션이 분산된 데이터를 정리하여 성능을 회복하듯, AI 대화의 컴팩션은 축적된 대화 이력을 핵심 내용으로 압축하여 모델의 응답 품질을 회복한다. 실용적 방법: AI 에이전트와 100턴이 넘는 긴 대화를 했을 때, AI에게 '지금까지의 대화에서 핵심 결정사항, 현재 코드 상태, 남은 작업을 요약해줘'라고 요청한 뒤, 이 요약을 새로운 대화 세션의 시작점으로 사용한다. 이렇게 하면 100턴의 대화가 소비하던 수만 토큰 대신, 요약 몇 백 토큰으로 동일한 맥락을 유지할 수 있다. Claude Code는 자체적인 컴팩션 메커니즘을 내장하고 있으며, Anthropic의 'Long-running Agents' 연구에서도 컴팩션이 핵심 주제로 다루어지고 있다. 수동 컴팩션(인간이 요약 요청)과 자동 컴팩션(도구가 자동 실행)으로 나뉘며, 자동 컴팩션의 정확도가 에이전트의 장기 작업 능력을 결정한다.
커뮤니티·문화 SWE 벤치AI 코딩 에이전트의 실제 소프트웨어 엔지니어링 능력을 측정하는 벤치마크로, Princeton NLP 그룹이 2023년 10월에 발표했다. 단순한 코드 생성 능력이 아니라, 실제 오픈소스 GitHub 리포지토리에서 보고된 실제 이슈(버그 리포트, 기능 요청)를 해결하는 능력을 평가한다는 점에서 기존 벤치마크(HumanEval, MBPP 등)와 차별화된다. 테스트 과정: 에이전트에게 GitHub 이슈 설명과 관련 코드베이스가 주어지면, 에이전트가 코드를 수정하고 이 수정이 기존 테스트를 통과하는지 확인한다. 이는 실제 소프트웨어 개발 환경과 가장 유사한 평가 방식이다. 2026년 3월 기준 주요 성적: Claude Code 80.8%, Codex CLI 약 70%대(변형에 따라 상이). SWE-bench는 AI 코딩 도구 성능 비교의 사실상 표준(de facto standard)이 되었으며, 새로운 도구나 모델이 출시될 때 SWE-bench 성적이 가장 먼저 언급된다. SWE-bench Verified(검증된 하위 집합), SWE-bench Lite(경량 버전), Terminal Bench(터미널 에이전트 특화) 등의 변형도 존재한다.
CLI·터미널 도구 코덱스 CLIOpenAI가 개발한 에이전틱 코딩 도구로, ChatGPT 웹 인터페이스, 터미널 CLI, VS Code 확장, Cursor/Windsurf 통합 등 다양한 접근 경로를 제공한다. 핵심 워크플로는 '계획(Plan) → 실행(Execute) → 관찰(Observe) → 반복(Iterate)'으로, AI가 작업을 계획한 뒤 코드를 작성·실행하고, 결과를 관찰하여 문제가 있으면 스스로 수정을 반복한다. ChatGPT 인터페이스의 Codex 탭에서는 클라우드 기반으로 에이전트가 작업을 수행하므로, 로컬 환경 설정 없이도 에이전틱 코딩을 경험할 수 있다. Codex mini 모델은 빠르고 저렴한 편집에 최적화된 경량 모델로, 간단한 코드 수정이나 리팩토링에 적합하다. ChatGPT Plus($20/월) 또는 Pro($200/월) 구독에 포함되어 별도 비용 없이 사용 가능하며, OpenAI 생태계(GPT-4, o1, o3 등)와의 자연스러운 통합이 강점이다. Claude Code와 함께 CLI 기반 AI 코딩 에이전트의 양대 산맥을 형성하고 있다.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
Nex-N2.6 | 오픈라우터의 GLM-5.3-Flash 기반 에이전트 모델
Nex AGI가 2026년 11월 10일 오픈라우터에 올린 Nex-N2.6이다. GLM-5.3-Flash 위에 두었고, 글과 사진을 읽어 글을 낸다. 할인 후 입력은 100만 토큰에 0.12달러다.
LiquidAI LFM3-1.7B 무료 | OpenRouter에서 토큰 요금 없이 부르는 글 모델
OpenRouter의 liquid/lfm-3-1.7b:free는 글을 받아 글로 답하고 토큰 단가가 0이다. 분당과 하루 요청 상한, 학습 보관, 유료 식별자와의 차이를 2026년 11월 9일 기준으로 적는다.