바이브코딩
NVIDIA Nemotron 3.5 Transcribe | 녹음을 글로 바꾸는 음성 모델
1시간 녹음, 한국어 Leading, OpenRouter는 초 단위
2026년 10월 28일 Hugging Face에 NVIDIA 글이 올라왔다. 글의 모델은 Nemotron 3.5 Transcribe다. 녹음 파일을 넣으면 글이 나온다. 말을 듣는 즉시 받아 적는 스트리밍 엔진이 아니다. 모델 카드와 출시 글은 녹음이 끝난 파일을 읽는 오프라인 모델이라고 적는다.
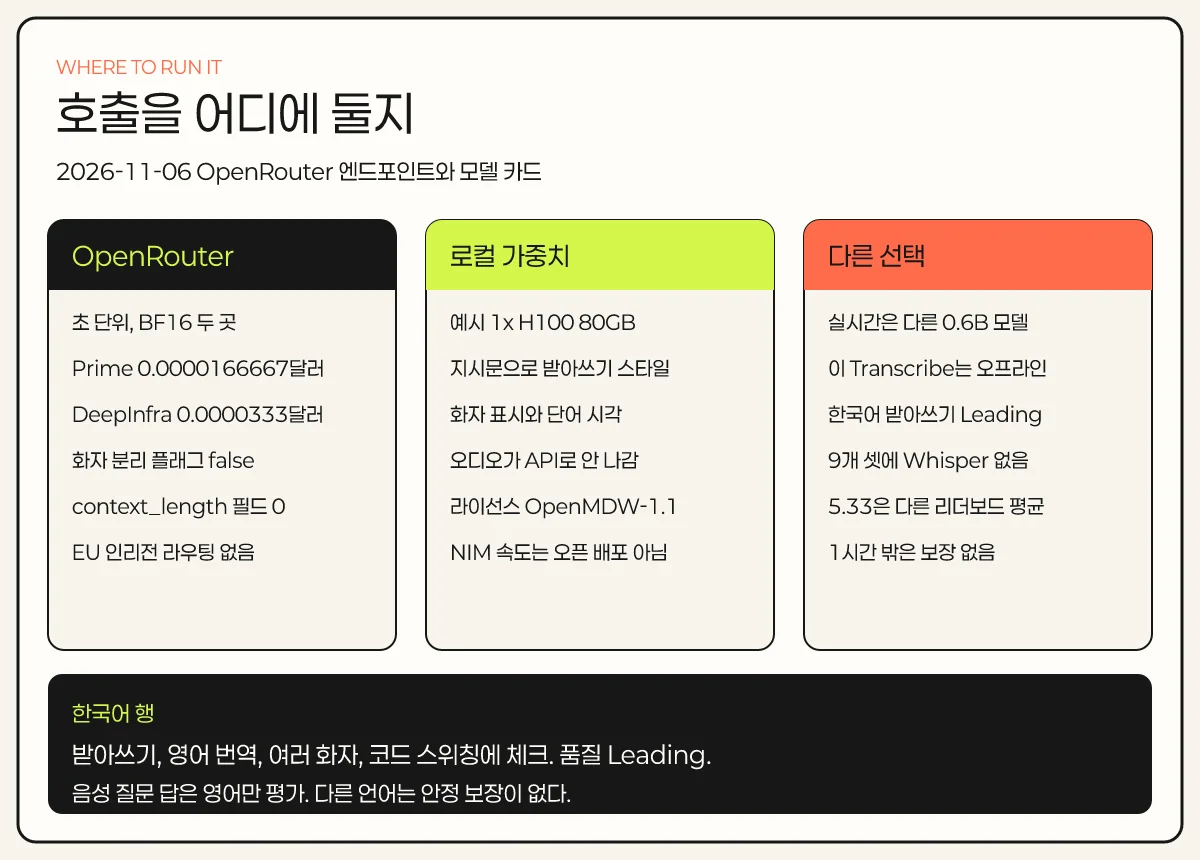
OpenRouter 아이디는 nvidia/nemotron-3.5-transcribe다. 카탈로그 생성 시각은 2026-10-29 00:51:51 UTC, 한국 시간으로 2026년 10월 29일 오전 9시 51분이다. 입력은 audio, 출력은 transcription이다. 글자 토큰을 사 오는 챗 모델과 과금 단위가 다르다. 2026년 11월 6일 확인한 엔드포인트는 Prime Intellect와 DeepInfra 두 곳이고, 둘 다 음성 초 단위로 청구한다.
가중치는 총 약 340억 파라미터이고, 오디오 인코더를 넣어 한 번에 켜지는 양은 약 43억이다. 학습 때 맥락은 65536 토큰, 녹음은 1시간까지다. 그 밖은 카드가 보장하지 않는다. 한국어는 언어 표에서 Leading이다. 받아쓰기, 영어 양방향 번역, 여러 화자 받아쓰기, 한 녹음 안의 언어 전환에 체크가 있다. 이 글의 숫자 확인일은 2026년 11월 6일이다.
녹음을 넣으면 글이 나오는 모델
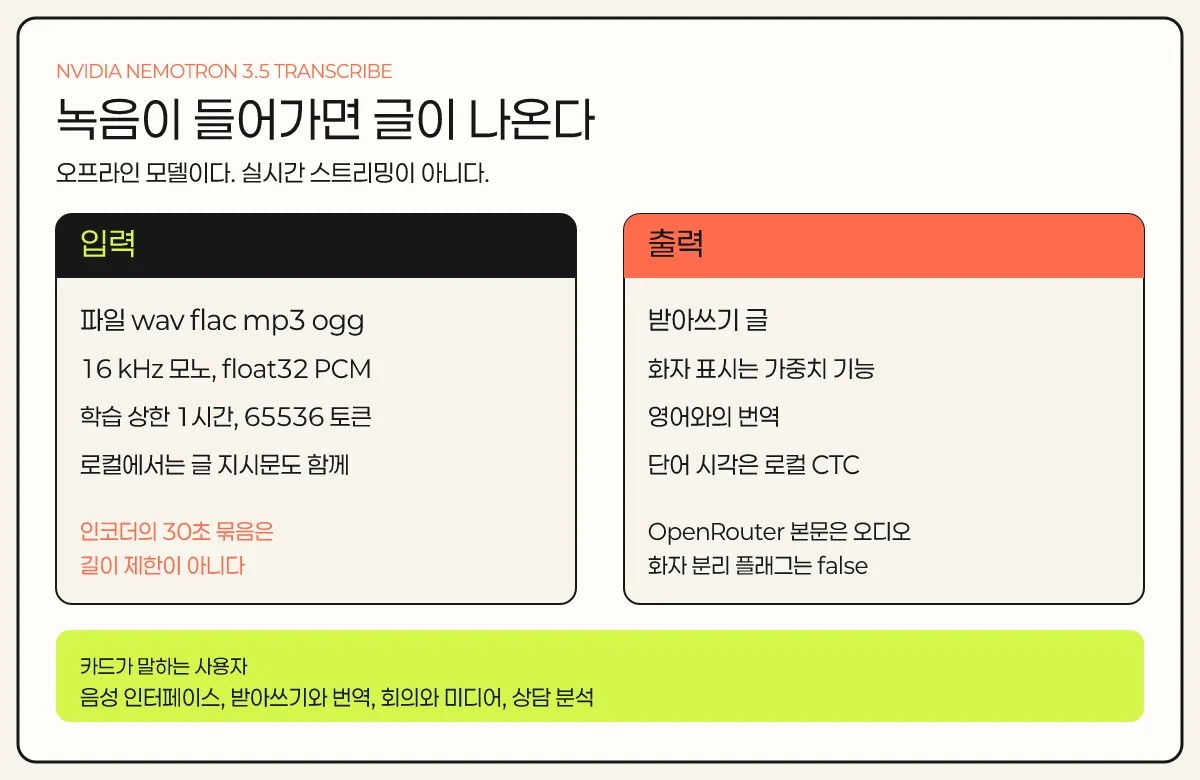
입력은 소리이고 출력은 글이다. 카드가 받는 파일은 wav, flac, mp3, ogg이고, 16 kHz 모노 float32 PCM으로 풀리는 녹음이면 된다. 로컬 가중치에서는 글 지시문과 선택적 맥락이 오디오와 함께 들어간다. 지시문으로 받아쓰기 스타일을 고른다. 그대로 받아 적기, 글로 정리된 표기, 기대 용어를 힌트로 주기, 화자 표시, 풍부한 전사, 영어 번역, 말한 언어 판별, 음성에 대한 질문 답이 한 체크포인트의 일이다.
화자 표시는 한 녹음 안에서 누구의 말인지를 가르는 라벨이다. 카드는 그 라벨이 현실의 신원을 증명하지 않는다고 적는다. 단어 시각은 CTC 정렬 헤드가 만든다. 로컬 vLLM에서는 미들웨어와 요청 옵션을 켜야 하고, 타임스탬프에는 V1 모델 러너가 필요하다. 환경 변수 이름은 VLLM_USE_V2_MODEL_RUNNER=0이다.
인코더는 특징을 뽑은 뒤 30초 단위로 묶는다. 카드는 이 묶음을 30초 길이 제한이나 스트리밍 지연이라고 적지 않는다. 학습 상한은 1시간과 65536 토큰이다. 출시 글도 이 모델을 녹음된 오디오용으로 두고, 라이브 스트리밍이 아니라고 적는다.
카드가 말한 사용자는 음성 인터페이스, 받아쓰기와 번역 도구, 회의와 미디어 처리, 고객 상담 분석, 오디오 이해 응용을 만드는 개발자와 연구자다. 상업적 이용과 비상업적 이용 모두 가능하다고 카드가 적는다. 라이선스 이름은 OpenMDW-1.1이다.
NVIDIA Developer 채널이 출시 다음 날 53초 소개 영상을 올렸다. 공개 설명문은 이 모델, 40개 언어, 해당 Hugging Face 저장소를 가리킨다. 영상 속 대사는 확인하지 않았고, 설명문에 없는 점수는 인용하지 않는다.
영상 1. NVIDIA Developer의 Nemotron 3.5 Transcribe 소개. 출처: YouTube NVIDIA Developer.
2026년 6월 7일에 올라온 다른 영상은 nvidia/nemotron-3.5-asr-streaming-0.6b를 다룬다. 이름이 비슷해도 이 글의 오프라인 Transcribe와 다른 모델이라 넣지 않았다. 개인 리뷰 영상이 자기 점수를 말한 경우도, 그 조건을 모델 카드에서 다시 열지 못하면 본문 숫자로 쓰지 않는다.
가격, 길이, 한국어
OpenRouter 안내문은 이 모델의 단가를 초로 적는다. 2026년 11월 6일 엔드포인트 JSON의 prompt 가격은 Prime Intellect 0.0000166667달러, DeepInfra 0.0000333달러다. 같은 날 llms.txt는 각각 초당 0.000017달러, 초당 0.000033달러로 반올림한다. 완료 토큰 가격은 둘 다 0이다. 태그는 primeintellect/bf16, deepinfra/bf16이다. 별도 요청당 요금 필드는 이 응답에서 보이지 않았다.
초당 단가에 60을 곱하면 분당 계산값이 된다. Prime Intellect는 약 0.001달러, DeepInfra는 약 0.001998달러다. 한 시간으로 늘리면 약 0.06달러와 약 0.12달러다. 이 환산은 안내문의 초당 단가를 곱한 것이고, 실제 청구가 반올림되거나 최소 단위를 두면 달라질 수 있다. 제공자마다 단가가 달라서, 라우팅이 바뀌면 같은 길이의 녹음도 금액이 달라진다.
| 제공자 | 태그 | 입력 단가 | 완료 단가 | 양자화 | 화자 분리 |
|---|---|---|---|---|---|
| Prime Intellect | primeintellect/bf16 | 초당 0.0000166667달러 | 0 | bf16 | false |
| DeepInfra | deepinfra/bf16 | 초당 0.0000333달러 | 0 | bf16 | false |
uptime_last_1d는 두 곳 모두 100이었다. status 필드 값은 0이었다. 이 글은 그 0을 장애로 해석하지 않는다. latency_last_30m은 비어 있었다. 그래서 OpenRouter에서의 응답 시간을 숫자로 적지 않는다. context_length 필드도 0이다. 65536은 가중치 학습 맥락이지, 이 API 필드가 확인한 길이가 아니다. supported_parameters는 빈 배열이다. supports_diarization은 둘 다 false다.
EU 인리전 라우팅은 llms.txt가 현재 불가라고 적는다. 유럽 리전 안에 오디오를 가두려면 이 아이디의 호스팅 경로로는 안 된다.
길이의 공식 문장은 가중치 쪽에 있다. 1시간과 65536 토큰을 넘는 일반화는 보장되지 않는다. OpenRouter가 그보다 짧게 자르는지는 엔드포인트 필드만으로는 확인되지 않았다. 공통 STT 스키마는 멀티파트 파일 업로드의 문서상 한도를 25MB로 적고, 더 큰 파일은 base64 JSON이나 일부 제공자의 source_url로 보내라고 한다. 이 모델 안내문이 필수로 적은 필드는 model과 input_audio다.
한국어 행은 ASR, 영어 양방향 번역, 여러 화자 ASR, 코드 스위칭이 모두 체크이고 품질은 Leading이다. Leading은 카드의 말로, 추가 학습 없이 그 언어에서 최상급이거나 그에 가깝다는 등급이다. Production-ready는 실무 수준, Supported는 지원하되 미세조정이 필요할 수 있다는 등급이다. FLEURS 한국어 오류는 글자 오류율(CER) 2.78이다. CoVoST2 한국어 칸은 비어 있다. 영어 단어 오류율 4.71과 이 2.78을 평균하면 안 된다. 단위가 다르고 데이터도 다르다.
음성 이해, 추론, 말로 된 지시 따르기는 영어로만 평가되었고, 다른 언어에서는 안정적으로 동작하지 않을 수 있다고 카드가 적는다. 한국어 받아쓰기가 Leading인 것과, 한국어 녹음에 질문하고 답을 받는 것은 다른 일이다.
가중치가 말하는 크기
카드는 크기를 한 숫자로 접지 않는다. 요약 표의 총 파라미터는 340억이고, 그중 활성은 오디오 인코더를 포함해 약 43억이다. 다른 문장은 언어 백본 활성이 약 35억이고, 약 8억 파라미터의 결합 오디오 인코더를 더하면 약 43억이라고 적는다. 베이스는 NVIDIA Nemotron 3.5 Lightning 30B-A3B BF16이다. 그 위에 약 6억 파라미터의 사전학습 ASR 트랜스포머와, 약 9900만 파라미터의 Nemotron 3 Diarization 화자 인코더가 붙는다. 화자 인코더는 얼려 둔다. 체크포인트 이름은 30B-A4B다. OpenRouter 짧은 설명은 30B와 약 4B 활성으로 둥글게 말한다. 본문은 카드의 340억과 43억을 기준으로 둔다.
이 숫자들은 서로 다른 층을 가리킨다. 340억은 전체, 43억은 한 번에 켜지는 양, 30B-A4B는 파일 이름, Lightning 30B-A3B는 언어 백본으로 쓰인 다른 모델이다. 6억과 9900만은 오디오 쪽 모듈이다. 하나를 고쳐서 나머지를 맞추면 카드가 한 말이 사라진다.
정밀도는 BF16이 기준 가중치고, FP8과 NVFP4 변형이 있다. 연구 페이지는 GGUF와 DFlash2 드래프트도 링크한다. DFlash2는 추측 디코딩용 드래프트이고, 그 자체로 받아쓰기를 끝내는 모델이 아니다. MTP와 DFlash2는 대안이지 동시에 켜는 조합이 아니다. OpenRouter 두 엔드포인트의 양자화 표기는 bf16이다. NIM이 광고하는 NVFP4 처리량을 이 API의 속도로 옮기면 안 된다.
아키텍처 유형은 Mamba-Transformer 하이브리드 MoE 언어 모델에 Transformer 오디오 인코더를 붙인 형태다. 카드는 Speech-Augmented Language Model 계보로 arXiv의 SALM을 인용한다. 2026년 기술보고서 PDF는 모델 카드와 NVIDIA 연구 페이지가 링크한다. 그 링크와 별개인 학회 논문 URL은 이 확인에서 열리지 않았다.
언어 표와 한국어
카드 요약과 출시 글은 40개 언어라고 말한다. 모델 카드 YAML의 language 목록도 40개 코드다. 그 목록에 노르웨이어 코드는 없다. 공개된 언어 행렬은 41행이고, 노르웨이어 행만 ASR, 번역, 여러 화자, 코드 스위칭이 모두 비어 있으며 품질 칸만 Supported다. 어느 행을 빼야 요약의 40이 되는지는 카드가 한 줄로 정정하지 않는다. 노르웨이어를 한국어와 같은 Leading 전사 언어로 읽으면 표와 어긋난다. 확장 결과표에는 FLEURS 노르웨이어 단어 오류율이 따로 있으나, 지원 행렬의 체크와는 다른 칸이다.
Leading 13개는 체코어, 네덜란드어, 영어, 프랑스어, 독일어, 힌디어, 이탈리아어, 한국어, 폴란드어, 포르투갈어, 러시아어, 슬로바키아어, 스페인어다. 영어는 미국, 인도, 영국, 프랑스어는 프랑스와 캐나다, 포르투갈어는 포르투갈과 브라질, 스페인어는 미국과 스페인이 괄호로 적혀 있다. Production-ready 15개는 불가리아어, 크로아티아어, 덴마크어, 에스토니아어, 핀란드어, 헝가리어, 일본어, 라트비아어, 리투아니아어, 루마니아어, 슬로베니아어, 스웨덴어, 태국어, 터키어, 우크라이나어다. Supported로 남은 행은 아랍어, 벵골어, 중국어 만다린, 그리스어, 히브리어, 인도네시아어, 몰타어, 마라티어, 노르웨이어, 타갈로그어, 타밀어, 텔루구어, 베트남어다.
여러 화자 ASR 체크는 13개다. 영어, 프랑스어, 독일어, 힌디어, 이탈리아어, 한국어, 포르투갈어, 러시아어, 스페인어, 일본어, 태국어, 아랍어, 중국어다. 출시 글의 "13개 언어에서 화자를 가른다"와 개수가 같다. 번역 체크가 없는 행은 터키어, 벵골어, 인도네시아어, 마라티어, 노르웨이어, 타갈로그어, 타밀어, 텔루구어, 베트남어다. 영어 자신의 행까지 체크를 세면 32이고, 영어를 빼면 31이다. 출시 글이 말한 "40개 중 31개를 영어와 서로 번역"은 이 세기와 맞다. 한국어는 그 31에 들어 있다.
코드 스위칭은 한 녹음 안에서 언어가 바뀌는 경우다. 노르웨이어 행만 그 칸도 비어 있다. 지역 변종은 해당 언어의 일부로 지원된다고 카드가 적는다.
같은 조건의 단어 오류율
단어 오류율(WER)은 기준 전사와 모델 전사를 비교해, 빠뜨림과 끼워 넣기와 바꿔 쓰기를 단어 단위로 센 비율이다. 낮을수록 기준 전사에 가깝다. 100단어 중 약 5단어가 어긋나면 5 전후가 된다. 글자 오류율(CER)은 같은 생각을 글자로 센 것이고, 한국어, 중국어, 일본어, 태국어, 베트남어의 단독 FLEURS 표가 이 단위를 쓴다. 서로 평균하지 않는다.
영어 공개 9개 셋의 대표 숫자는 동일 가중 평균 4.71이다. 카드의 캡처일은 2026년 10월 12일이다. 아홉 셋은 AMI 7.81, Earnings22의 Open ASR 부분집합 5.29, GigaSpeech 7.18, LibriSpeech test-clean 1.09, LibriSpeech test-other 2.60, 인도 영어 Monsoon 3.65, SPGISpeech 1.91, URGENT24 11.00, VoxPopuli의 Open ASR 부분집합 1.84다. 아홉 수를 더해 9로 나누면 4.71과 맞다. 같은 줄에서 카드가 적은 다음 오픈 웨이트는 Qwen3-ASR-1.7B 평균 4.94다.
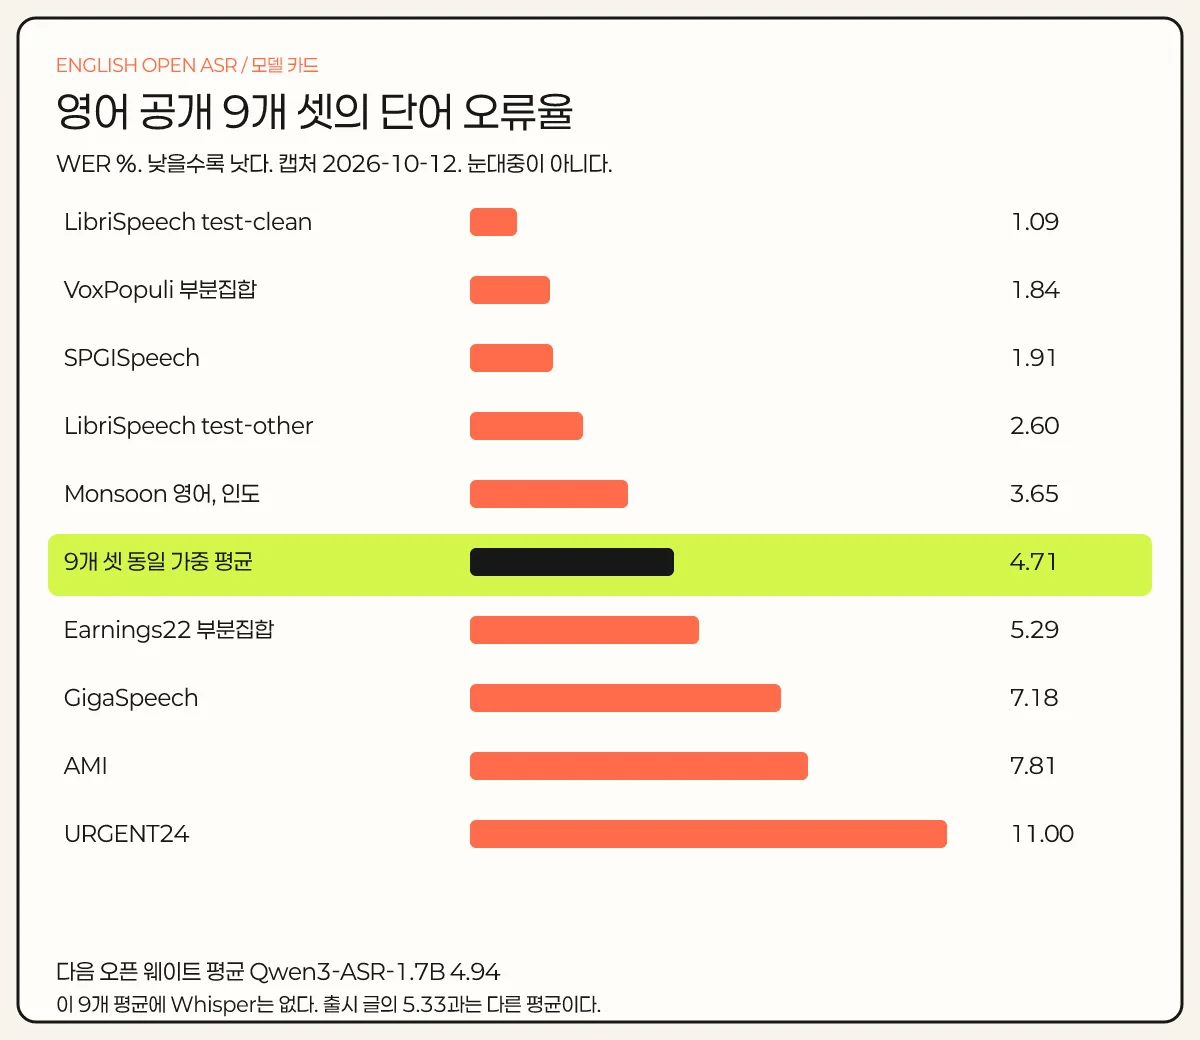
Hugging Face 출시 글은 영어 Open ASR 리더보드에서 오픈 웨이트 1위가 평균 5.33이라고 적고, API 모델은 그 순위에서 빠졌다고 캡션에 적는다. 4.71과 5.33을 하나의 순위로 합치지 않는다. 4.71은 카드가 이름을 붙인 공개 9개 셋의 동일 가중 평균이다. 5.33은 출시 글이 리더보드 평균이라고 부른 다른 집계다. 그래프를 눈대중해 만든 숫자가 아니다. 출시 글 캡션의 RTFx 462.09도, 아래 H100 배치 처리량 표와 조건이 같다고 보지 않는다.
| 셋 | WER % |
|---|---|
| 9개 동일 가중 평균 | 4.71 |
| AMI | 7.81 |
| Earnings22 Open ASR 부분집합 | 5.29 |
| GigaSpeech | 7.18 |
| LibriSpeech test-clean | 1.09 |
| LibriSpeech test-other | 2.60 |
| Monsoon 영어, 인도 | 3.65 |
| SPGISpeech | 1.91 |
| URGENT24 | 11.00 |
| VoxPopuli Open ASR 부분집합 | 1.84 |
장문 Open ASR은 녹음을 55분 덩어리로 자르고 5초를 겹친다. 전체는 CORAAL, Earnings21, Earnings22의 동일 가중 평균 10.98이다. CORAAL은 지역 평균 13.39, Earnings21은 7.57, Earnings22는 11.99다. CORAAL 지역은 Rochester 8.17에서 Princeville 21.06까지 벌어진다. 10.98만 보면 그 폭이 사라진다. 카드가 이 장문 평균의 다음 오픈 웨이트로 적은 모델은 Parakeet-TDT-0.6B-v3의 13.37이다. 이 13.37을 영어 9개 셋 순위에 끼워 넣으면 조건이 섞인다.
다국어 Open ASR 전체 WER은 4.62다. 카드의 다음 오픈 웨이트는 Qwen3-ASR-1.7B 6.49다. 이 보드는 FLEURS, Common Voice, Multilingual LibriSpeech, Monsoon을 다루고 전 구간을 WER로 센다. 일곱 언어 평균의 동일 가중이다. 단독 FLEURS는 언어에 따라 CER을 쓰고 정규화도 다르므로, 카드는 두 점수를 바로 비교하지 말라고 적는다. 한국어 CER 2.78은 이쪽 4.62의 부분 점수가 아니다.
여러 화자 점수는 cpWER다. 예측 화자 라벨을 기준 화자에 맞춘 뒤 단어 오류를 센다. 카드의 전체 세션 평균은 AMI, CALLHOME, Mixer 6, NOTSOFAR-1에서 15.80이고, 그 줄의 다음 공개 결과는 DiCoW v3.3과 DiariZen의 16.83이다. 카드는 이것을 공개된 결과 중 나은 쪽으로 적었지, 오픈 웨이트만의 순위라고 적지 않았다. 조건별로 나누면 AMI 헤드셋 10.29, AMI 단일 원거리 마이크 17.34, CALLHOME 미국 영어 CH109 11.50, Mixer 6 채널 4는 14.80, NOTSOFAR-1 헤드셋 14.94, NOTSOFAR-1 단일 채널 원거리 25.91이다. 15.80은 이 표의 산술 평균을 이 글이 다시 계산한 값이 아니라 카드가 전체 세션 평균으로 적은 값이다. 중국어 회의의 cpCER은 AISHELL-4 32.91, AliMeeting 34.95다. 글자 오류에 화자 배정이 더해진 만다린 숫자이고 한국어 점수가 아니다.
Preference-ASR에서는 기본 7.56, 지시를 준 경우 6.16이다. 같은 칸의 Canary-Qwen은 8.16과 8.36이다. 이 비교는 그 벤치 안으로 한정한다. ContextASR-Bench는 힌트 없음 3.33, 거친 힌트 3.34, 세밀한 힌트 1.71이다. 고유명사만 보면 없음 12.21에서 세밀한 힌트 2.20으로 줄어 있다. 용어 목록이 전사에 도움이 되는 조건과, 그냥 받아쓰기의 조건은 다르다.
Whisper large-v3는 카드의 이 9개 셋 비교에 없다. 출시 글의 5.33 순위도 API 모델을 뺐다고 적혀 있다. 격차를 만들어 "항상 더 낫다"고 쓰지 않는다. Artificial Analysis의 AA-WER은 출시 글이 2.80 전후로 말하지만, Open ASR의 4.71이나 5.33과 같은 시험이 아니다. 이 글은 그 지수를 다시 계산하지 않았다.
핵심 포인트: 영어 공개 9개 셋의 동일 가중 평균은 4.71이고, 출시 글의 5.33은 다른 집계다. 한국어 FLEURS는 CER 2.78이라 둘을 한 순위에 넣지 않는다.
OpenRouter 호출
호출 주소는 POST https://openrouter.ai/api/v1/audio/transcriptions 이다. 인증은 Authorization 헤더의 Bearer 토큰이다. 이 모델 안내문이 보여주는 JSON은 모델 아이디와 base64 wav다. 아래 블록은 필드 모양만 옮긴 것이고, 이번 확인에서는 유료 호출을 하지 않았다.
{
  "model": "nvidia/nemotron-3.5-transcribe",
  "input_audio": {
    "data": "<base64 wav>",
    "format": "wav"
  }
}
기본 응답은 text와 usage다. 안내문 예시에는 seconds 9.2, total_tokens 113, cost 0.000508이 들어 있다. 문장도 "Hello, this is a transcription." 같은 샘플이다. 이 모델의 9.2초 녹음 실측으로 읽지 않는다. 공통 OpenAPI 예시의 문장은 Whisper 데모 문장이라, 샘플끼리도 모델이 섞여 있다.
response_format을 verbose_json으로 두면, 안내문은 라우팅된 제공자가 지원할 때 language, duration, segments, 단어 시각이 더 올 수 있다고 적는다. 공통 스키마의 diarize는 verbose_json일 때만 단어에 화자 라벨을 붙이며, 모델이 화자 분리를 못하면 400이다. 이 아이디의 두 엔드포인트는 supports_diarization이 false이고 supported_parameters가 비어 있다. 그래서 OpenRouter에서 화자 이름과 단어 시각이 돌아온다고 단정하지 않는다. 그 기능은 로컬 가중치와 CTC 미들웨어 쪽에 문서가 있다.
오류 코드로 안내문이 적은 것은 400, 401, 402, 403, 404, 429, 502다. 400은 깨진 오디오나 그 제공자가 받지 않는 옵션, 401은 키, 402는 크레딧, 404는 모델을 서빙할 곳이 없음, 429는 속도 제한이다. 502는 상류 실패이고, 실패 생성은 청구하지 않는다고 적혀 있다. temperature는 공통 스키마에 0에서 1이다. 카드의 전사, 번역, 언어 판별 권장값은 temperature 0과 추론 끄기이고, 오디오 이해는 temperature 0.6, top_p 0.95, 추론 켜기이다. OpenRouter STT 본문에 그 추론 스위치를 넣는 필드는 이 모델 안내문에 없다.
language를 빼면 스키마는 자동 감지로 적는다. 그래도 한국어 품질 보장은 언어 표의 Leading 등급과 FLEURS CER에서 읽고, API가 감지를 맞췄는지는 호출 결과로만 알 수 있다. 이 글은 그 호출을 하지 않았다.
로컬 가중치와 API
로컬에서 켜는 이유는 지시문, 화자 표시, 단어 시각, 오디오가 제3자 API로 나가지 않는 점이다. 카드의 서빙 예시는 H100 80GB 한 장, vLLM 0.32.0, NeMo Speech main, BF16이다. 환경 변수로 오디오 디코드 상한 3600초와 클립 파일 180MB를 적는다. 서버 예시는 127.0.0.1:8000이다. 단어 시각은 미들웨어 이름 nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware와 trust-request-mm-kwargs, 그리고 V1 러너가 문서에 있다. 이 플래그를 OpenRouter JSON에 그대로 넣으면 그 API의 필드가 아니다.
처리량 표는 단일 요청 지연이 아니다. H100 80GB 한 장에서 영어 Open ASR과 Monsoon을 배치로 돌리고, 추론을 끄고, 서버 기동을 뺀 대략의 BF16 RTFx다. RTFx는 오디오 길이를 처리 시간으로 나눈 값이다. MTP를 끄면 측정하지 않았고, MTP2는 410, MTP8은 270, DFlash2 K=7은 340, DFlash2 K=15는 260이다. K=7이 시작점으로 적혀 있다. 배치와 녹음 길이, 출력 길이, GPU 메모리에 따라 달라진다.
NIM 문장은 따로 읽어야 한다. 카드와 연구 페이지는 RTX PRO 6000 Blackwell Server Edition 한 장에서 NVFP4와 DFlash2로 초당 2238초의 오디오를 처리하고, 30초 녹음 전사를 0.13초에 돌려준다고 적는다. 이 최적화는 아직 오픈 소스 릴리스가 아니고, 출시 당일 NeMo Speech의 vLLM 경로는 개발용이며 대략 두 배 느리다고 카드가 적는다. OpenRouter 단가 표에는 이 속도가 없다.
학습 데이터는 고유 오디오 예시 약 3억 7200만 개, 약 172만 시간, 고유 텍스트 토큰 약 56억이다. 반복 노출까지 넣으면 약 653만 시간이라고 카드가 구분한다. 가장 큰 몫은 영어이고, 합성 PII가 포함된다. 프라이버시 절은 학습 데이터에 개인정보가 들어 있었고, 필터와 최소화로 개인정보가 그대로 나오는 일을 줄이려 했으며, NVIDIA 프라이버시 정책을 보라고 적는다. 오디오를 저장하지 않는다는 문장이나 별도 DPA는 이 카드에서 확인하지 못했다. 로컬 가중치는 호출 오디오를 Prime Intellect나 DeepInfra로 보내지 않는다. OpenRouter 경로는 그 두 제공자로 오디오가 간다. 제로 데이터 보존을 강제하는 zdr 필드는 공통 STT 스키마에 있으나, 이 두 엔드포인트가 그 조건을 만족하는지는 빈 파라미터 목록만으로 확인되지 않았다.
설명 가능성 절이 적는 오류는 바꿔 쓰기, 빠뜨림, 반복, 없는 말의 환각, 언어를 잘못 고름, 화자 귀속 오류다. 텍스트만 넣었을 때의 성능은 베이스 언어 모델보다 못하다고 카드가 적는다. 텍스트 추론이 주 목표가 아니었기 때문이다. 받아쓰기 모델로 긴 글을 쓰게 하는 용도와는 거리가 있다.
라이선스는 OpenMDW-1.1이다. 카드는 이용자가 그 라이선스와, 배포물에 포함된 제3자 고지를 지킬 책임이 있다고 적는다. vLLM의 DFlash2 수정과 반복 억제 보조 코드는 Apache-2.0이라고 카드가 분리해 적는다. 가중치 라이선스와 그 보조 코드의 라이선스를 한 이름으로 합치지 않는다.
같은 표 안의 다른 모델
비교는 카드가 같은 칸에 적어 둔 것만 한다.
| 비교 | 조건 | 이 모델 | 카드가 그 칸에 적은 다음 결과 |
|---|---|---|---|
| 영어 9개 공개셋 평균 WER | 동일 가중, 캡처 2026-10-12 | 4.71 | Qwen3-ASR-1.7B 4.94 |
| 다국어 7개 언어 평균 WER | Multilingual Open ASR | 4.62 | Qwen3-ASR-1.7B 6.49 |
| 장문 평균 WER | 55분 청크, 5초 겹침 | 10.98 | Parakeet-TDT-0.6B-v3 13.37 |
| Preference-ASR WER | 기본 / 지시 | 7.56 / 6.16 | Canary-Qwen 8.16 / 8.36 |
| 다화자 전체 세션 cpWER | AMI, CALLHOME, Mixer 6, NOTSOFAR-1 | 15.80 | DiCoW v3.3 + DiariZen 16.83 |
Parakeet 숫자는 장문 평균에만 있다. Canary-Qwen은 Preference-ASR에만 있다. Qwen3-ASR-1.7B는 영어 9개 평균과 다국어 평균에 있고, 장문 칸의 다음 모델은 아니다. DiCoW와 DiariZen은 오픈 웨이트 전용 순위가 아니라 카드가 "다음으로 좋은 공개 결과"라고 적은 결합 시스템이다. Whisper를 이 표에 빈칸으로 넣어 순위를 만들지 않는다.
출시 글은 의료 녹음에 대한 미세조정 사례를 따로 적는다. 그 상대 감소는 기본 체크포인트를 OpenRouter에 올린 결과가 아니다. 호스팅 아이디 nvidia/nemotron-3.5-transcribe의 점수로 옮기지 않는다. Granary v2 공개 매니페스트의 시간도 학습 혼합물 전체인 172만 시간과 다르다고 출시 글이 구분한다.
고를 때 보는 조건
선택이 갈리는 지점은 다섯이다. 비용은 초 단위이고 제공자가 둘이다. 언어는 한국어 받아쓰기와 영어 번역이 Leading이지만, 음성 질문 답은 영어 평가다. 정확도 근거는 위 표의 조건 안에만 있다. 배포는 로컬 가중치와 OpenRouter API가 기능이 다르다. 라이선스는 OpenMDW-1.1이고, 프라이버시는 학습 데이터에 개인정보가 있었다는 문장과, 호출 오디오가 어디로 가는지로 가른다.
OpenRouter가 맞는 경우는 GPU 없이 끝난 녹음을 글로 바꾸고, 초 단위 요금을 받아들이며, 화자 라벨과 단어 시각과 지시문 스타일을 이번 호출의 요건으로 두지 않을 때다. 로컬 가중치가 맞는 경우는 그 세 가지가 필요하거나, 오디오를 Prime Intellect와 DeepInfra에 보내고 싶지 않을 때다. 예시 장비는 H100 80GB 한 장이다. 더 작은 GPU에서 같은 속도가 난다고 카드는 말하지 않는다.
다른 모델을 보는 경우는 실시간 스트리밍이 필요할 때다. 그때의 후보는 0.6B 스트리밍 ASR이고, 이 Transcribe가 아니다. 카드가 Whisper와 같은 줄에 놓지 않은 비교로 순위를 정할 때도 이 글을 근거로 삼지 않는다. 1시간을 넘기거나, 노르웨이어 행렬의 빈 칸을 지원 체크로 읽거나, NIM의 0.13초를 API 지연으로 읽을 때도 문서와 어긋난다.
공개되지 않은 것은 그대로 둔다. OpenRouter가 1시간을 실제로 받는지, verbose_json 단어 시각이 이 두 제공자에서 돌아오는지, 한국어 음성 질문 답이 되는지, 엔드포인트 status 0의 운영 의미, 단일 요청 지연은 이번 확인에서 확정하지 않았다. 유료 음성 호출도 하지 않았다.
마무리
앞에서 다룬 Nemotron 3.5 Transcribe의 핵심만 짧게 정리한다.
- 녹음 파일을 넣으면 글이 나오는 오프라인 모델이고, 스트리밍 ASR이 아니다.
- OpenRouter는 초 단위로 청구하며 2026-11-06 기준 제공자는 Prime Intellect와 DeepInfra다.
- 한국어 받아쓰기, 영어 번역, 여러 화자, 코드 스위칭은 Leading이고, 음성 질문 답은 영어 평가다.
- 영어 공개 9개 셋의 동일 가중 평균 WER은 4.71이고, 출시 글의 5.33은 다른 평균이다.
- 화자 표시와 단어 시각은 로컬 가중치 문서에 있고, OpenRouter 두 엔드포인트의 화자 분리 플래그는 false다.
- 학습 상한은 1시간과 65536 토큰이며, 그 밖과 NIM 속도는 이 API의 보장으로 옮기지 않는다.
「같은 표의 숫자만 나란히 놓는다」
호출 전에 엔드포인트 초당 단가와 화자 분리 플래그를 다시 읽고, 단어 시각이 필요하면 로컬 CTC 경로를 본다.
출처와 링크
조사 기준은 2026년 11월 6일이다. 숫자는 아래 문서에서 읽었고, 그래프를 눈대중하지 않았다.
FAQ
자주 묻는 질문
한국어 음성을 영어로 옮기면 점수는 얼마인가?
FLEURS 한국어를 영어로 옮긴 BLEU는 24.23이고, 영어를 FLEURS 한국어로 옮긴 점수는 27.68이다. CoVoST2 한국어의 양쪽 칸은 모델 카드에 비어 있다. 번역 점수라서 영어 단어 오류율 평균과 한 줄에 세우지 않는다.
한국어인지 가려내는 정확도는 어디에 있나?
언어 식별 표에서 FLEURS 한국어 정확도는 100.00이다. VoxLingua107 한국어 칸은 비어 있어 그 셋의 점수는 없다. 100.00은 그 FLEURS 분할의 결과이고, 모든 한국어 녹음을 항상 맞춘다는 뜻은 아니다.
2026년 기술보고서 말고 카드가 인용한 논문은 무엇인가?
카드가 아키텍처 계보로 인용한 SALM 논문은 arXiv 2310.09424다. 2026년 Transcribe 기술보고서는 NVIDIA 기술보고서로 연도만 2026이다. 그 PDF와 별도로 열린 학회 논문 페이지는 이번 확인에서 찾지 못했다.
숫자나 이메일 같은 값은 얼마나 맞나?
Numb3rs 숫자 전사 WER은 3.55다. VoiceCodeBench의 구조적 값 WER은 8.38이고, 목표 값 복원 CTEM은 88.53, 모든 목표 값이 맞은 비율 TSR은 59.33이다. 단어 오류율이 낮아도 값이 전부 맞는 비율은 다른 지표다.
의료 녹음 오류가 줄었다는 수치는 이 API의 점수인가?
출시 글의 의료 사례는 미세조정 뒤 held-out WER이 22.44에서 12.17로 줄었고, 상대 감소를 45.8퍼센트로 적는다. 그 수치는 기본 가중치를 OpenRouter에 올린 실측이 아니다. 호스팅 아이디의 의료 성능으로 옮기지 않는다.
Granary v2 공개분이 학습 데이터 전체인가?
출시 글은 Granary v2 공개 매니페스트를 463062시간, 48개 언어로 적고, 그 숫자가 학습 혼합물 전체가 아니라고 구분한다. 카드의 학습 규모는 고유 오디오 약 172만 시간이다. 공개 매니페스트만 받아 학습량으로 세면 문서와 어긋난다.
OpenRouter에서 단어별 시각이 보장되나?
공통 스키마에서 diarize를 켜면 verbose_json이 필요하고, 모델이 화자 분리를 못하면 400이다. 이 아이디의 엔드포인트는 그 기능을 지원하지 않는다고 표시되어 있다. 단어 시각이 필요하면 로컬 CTC 미들웨어 문서를 기준으로 본다.
Whisper large-v3보다 낫다고 카드가 적었나?
카드의 영어 9개 공개셋 표와 장문 표, 다국어 표에는 Whisper large-v3 행이 없다. 그래서 둘의 점수 차이를 계산하지 않는다. 비교가 필요하면 같은 셋과 같은 정규화, 같은 날짜의 리더보드 행을 따로 열어야 한다.
용어
관련 용어
Microsoft AI 팀이 만든 Azure Speech용 60개 언어 음성 전사 모델이다. 퍼블릭 프리뷰이며 워드·세그먼트 타임스탬프와 다이어리제이션을 제공한다.
AI 모델·프로바이더 토큰LLM이 텍스트를 처리하는 기본 단위로, AI 모델의 비용 산정과 성능을 이해하는 데 가장 기본이 되는 개념이다. 토크나이저(tokenizer)라는 알고리즘이 텍스트를 토큰으로 분할하며, 단어 하나가 반드시 토큰 하나가 되는 것은 아니다. 영어의 경우 대략 단어 1개 ≈ 1~1.5 토큰이지만, 한국어는 음절 단위로 분할되어 같은 의미의 텍스트가 영어보다 2~3배 많은 토큰을 소비한다(예: '안녕하세요' ≈ 3~5 토큰). 코드의 경우 'console.log("Hello World")' ≈ 약 6토큰이다. 토큰은 AI 코딩 도구의 사용량과 비용을 결정하는 핵심 단위로, API 과금은 입력 토큰과 출력 토큰을 각각 계산한다. 모델마다 다른 토크나이저를 사용하므로, 같은 텍스트도 모델에 따라 소비하는 토큰 수가 다를 수 있다. 바이브 코딩에서 예상보다 비용이 높아지는 주요 원인이 토큰 소비이므로, 컨텍스트 엔지니어링을 통해 불필요한 토큰 소비를 줄이는 것이 비용 관리의 핵심이다.
ai JevTypeSafe의 System One 플래그십. 문장 대신 Choice/Score/Noul typed 결정과 확률을 돌려 소프트웨어 if에 붙인다. 홈 https://typesafe.ai/ / OpenRouter https://openrouter.ai/typesafe/jev-1.13
링크
관련 링크
관련 글
관련 글
Recommended
AssemblyAI Universal-3.5 Pro | OpenRouter Sync STT와 120…
AssemblyAI Universal-3.5 Pro는 Sync Speech-to-Text의 플래그십이다. OpenRouter 출시 2026-09-22, 할인 $0.000063/초. 공식 $0.45/시간과 프리웜 P50 약 134ms, 언어 32 vs 18, /v1/transcribe…
Perplexity Decider V1.3 무료 | 27B 판정 본체 한도와 API 비교
Perplexity Decider V1.3 무료 변형은 OpenRouter에서 입력과 출력 0달러로 제공되는 27B 판정 본체다. 262,144토큰 문맥 한도와 호출 제한을 정리하고 4B Flash 모델과의 정확도 및 지연 차이를 비교했다.