바이브코딩
텐센트 Hy4 정식 API 출시 | 시각 이해와 컴퓨터 사용, 100만 창 50% 할인 단가
입력 $0.417 및 출력 $1.2505 프로모션 요금과 OpenRouter 엔드포인트 제약, Preview 차이점 분석
텐센트(Tencent)가 한국 시각 2026년 11월 4일 13시 20분 자사 대형 언어 모델 제품군의 최신 정식 버전인 Hy4를 상용 API로 전격 공개했다. 인공지능 모델 라우팅 플랫폼인 오픈라우터(OpenRouter)에는 tencent/hy4 식별자로 정규 엔드포인트가 등록되었으며, 텐센트 클라우드의 국제 인공지능 허브인 토큰허브(TokenHub)에서도 정식 서빙이 개시되었다.
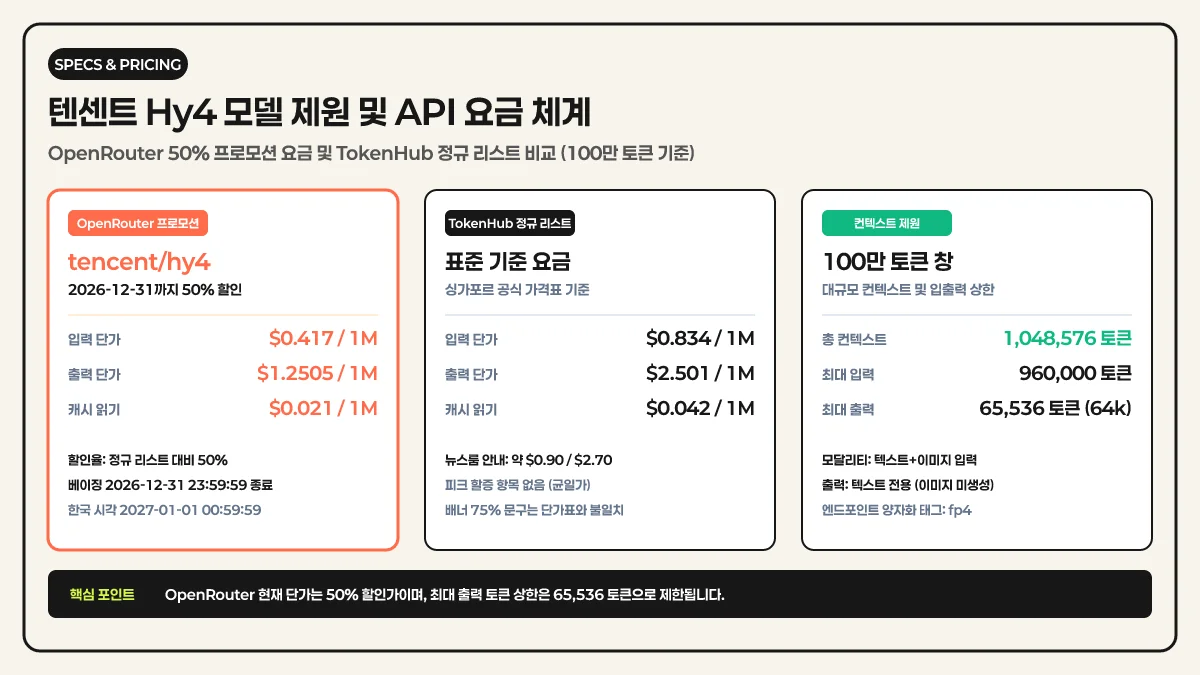
이번 정식 출시는 1,048,576 토큰(약 100만 토큰)에 달하는 대규모 컨텍스트 창을 유지하면서 텍스트와 고해상도 이미지를 아우르는 시각 이해 능력과 명령줄 및 그래픽 환경을 제어하는 컴퓨터 사용 기능을 새롭게 탑재한 점이 특징이다. 정규 리스트 기준 단가는 100만 토큰당 입력 0.834달러, 출력 2.501달러, 프롬프트 캐시 읽기 0.042달러로 책정되었다.
텐센트는 출시와 동시에 베이징 시각 2026년 12월 31일 23시 59분 59초(한국 시각 2027년 1월 1일 00시 59분 59초)까지 추론 비용을 50% 감면하는 프로모션을 적용했다. 이에 따라 현재 오픈라우터에서는 100만 토큰당 입력 0.417달러, 출력 1.2505달러, 캐시 읽기 0.021달러의 할인 단가로 호출할 수 있다. 같은 주 오픈라우터에 등록된 스텔스 모델 Crouton Alpha(stealth/crouton-alpha)가 익명 제작사의 무료 프리뷰 모델인 반면, Hy4는 텐센트 공식 명의와 정규 과금 체계를 갖춘 상용 제품군이다. 본 분석은 2026년 11월 5일 기준 공식 발표문과 토큰허브 과금 명세, 오픈라우터 엔드포인트 제원을 기반으로 작성되었다.
텐센트 Hy4의 제품 정체성과 주요 기능
Hy4는 텐센트의 혼원(Hunyuan) 계열 기반 기술을 집약한 정식 플래그십 인공지능 모델이다. 개발자 인터페이스에서는 복잡한 분기 없이 tencent/hy4 단일 식별자로 접근하며, 오픈라우터 내부 엔드포인트에는 tencent/hy4-20261104라는 체크포인트 명칭이 부여되어 있다.
이 모델이 수행하는 핵심 작업은 긴 호흡의 자율 에이전트 루프와 시각적 데이터 분석이다. 단순 질의응답을 넘어 수백 쪽에 달하는 문서 묶음과 도표, 이미지 자료를 한꺼번에 읽어 들이고 사용자의 복합 지시를 단계별로 완수하도록 설계되었다. 특히 세밀한 이미지 판독, 복합 도표 해석, 수학적 시각 추론을 아우르는 비전 역량이 텐센트 Hy 라인업 최초로 공식 탑재되었다.
작업 공간과의 연동 측면에서는 명령줄 인터페이스(CLI)와 그래픽 사용자 인터페이스(GUI) 환경을 모두 조작할 수 있는 컴퓨터 사용 능력을 도입했다. 텐센트는 발표 자료를 통해 3차원 모델링 소프트웨어인 블렌더(Blender)와 컴퓨터 지원 설계(CAD) 도구를 포함한 전문 작업 환경에 대해 특화 훈련을 진행했다고 밝혔다. 이는 모델이 3D 파일을 자체 생성하는 그래픽 엔진이라는 뜻이 아니며, 엔지니어링 프로그램의 인터페이스를 시각적으로 인식하고 조작 명령을 체계적으로 실행하는 에이전트 제어 기능이다.
출력 모달리티는 텍스트 전용으로 한정된다. 이미지 생성이나 영상 합성 출력은 지원하지 않으며, 코드 작성, 분석 보고서 생성, 도구 호출 매개변수 생성과 같은 논리적 텍스트 산출에 집중되어 있다.
토큰당 과금 체계와 연말 50% 프로모션 구조
텐센트 Hy4의 이용 요금은 표준 리스트 단가와 2026년 말까지 한시적으로 적용되는 프로모션 할인가의 두 단계로 구분된다. 토큰허브 싱가포르 리전 공식 문서에 명시된 정규 리스트 단가는 100만 토큰 기준 입력 0.834달러, 출력 2.501달러, 프롬프트 캐시 읽기 0.042달러다. 해당 가격표에는 주간 피크 시간대 할증이나 야간 오프피크 할인이 별도로 설정되어 있지 않아 24시간 단일 요율로 적용된다.
여기에 텐센트는 출시일부터 베이징 시각 2026년 12월 31일 23시 59분 59초까지 추론 요금을 정규 리스트 대비 50% 할인하여 정산한다는 운영 규정을 공지했다. 현재 오픈라우터 엔드포인트 JSON 역시 discount: 0.5 속성을 반영하고 있으며, 실제 청구되는 단가는 100만 토큰당 비캐시 입력 0.417달러, 출력 1.2505달러, 캐시 읽기 0.021달러로 설정되어 있다. 오픈라우터 웹 UI에서는 소수점 셋째 자리 반올림 기준에 따라 출력이 1.251달러로 표기된다.
| 제공 플랫폼 및 문서 | 적용 기준 | 입력 단가 ($/1M) | 캐시 읽기 ($/1M) | 출력 단가 ($/1M) | 비고 |
|---|---|---|---|---|---|
| OpenRouter (현재 실청구) | 50% 프로모션 요금 | $0.417 | $0.021 | $1.2505 | 2026-12-31 베이징 자정까지 |
| TokenHub 국제 정규 요금표 | 표준 리스트 기준가 | $0.834 | $0.042 | $2.501 | 프로모션 종료 후 환원 요율 |
| 텐센트 영문 뉴스룸 발표 | 개략적 근사치 표기 | 약 $0.90 | 약 $0.045 | 약 $2.70 | 보도용 어림값 서술 |
| 토큰허브 마케팅 랜딩 | 이벤트 배너 문구 | $0.834 기준 | 미기재 | $2.501 기준 | 75% 배너는 단가표와 불일치 |
| Hy4 Preview (2026-08 국내) | 중국 내수 위안화 기준 | 6 RMB | 0.3 RMB | 18 RMB | 이전 프리뷰 발표 당시 단가 |
가격 정보를 확인할 때 몇 가지 수치 표기 방식에 주의해야 한다. 텐센트 영문 뉴스룸 보도자료에는 단가가 약 0.90달러, 2.70달러, 0.045달러 수준이라고 둥글려 설명되어 있으나 이는 개략적인 환산치이며 실제 시스템 과금의 기준선은 0.834달러와 2.501달러다. 또한 토큰허브 영문 프로모션 페이지의 상단 배너에 75% 할인 문구가 노출되기도 하지만 동일 페이지의 모델 카드와 과금 규정 본문은 명확히 50% 할인과 0.834달러 리스트를 명시하고 있다. 따라서 시스템 운영 예산을 편성할 때는 50% 할인가인 0.417달러와 1.2505달러를 기준으로 삼아야 한다.
프롬프트 캐싱 메커니즘은 장기 에이전트 작업에서 비용 절감의 핵심 역할을 담당한다. 캐시 적중 시 적용되는 0.021달러는 비캐시 입력 단가의 약 20분의 1 수준이다. 이전 턴의 작업 로그와 방대한 코드베이스를 반복 전달해야 하는 바이브 코딩 환경에서 캐시 재사용 비율을 높이면 실질적인 토큰 지출을 대폭 줄일 수 있다.
핵심 포인트: 텐센트 Hy4의 50% 추론료 할인은 베이징 시각 2026년 12월 31일 23시 59분 59초(한국 시각 2027년 1월 1일 00시 59분 59초)까지 적용되며, 이후 정규 리스트 가격으로 환원됩니다.
Hy4 Preview와의 기능 차이점과 공개 상태 대조
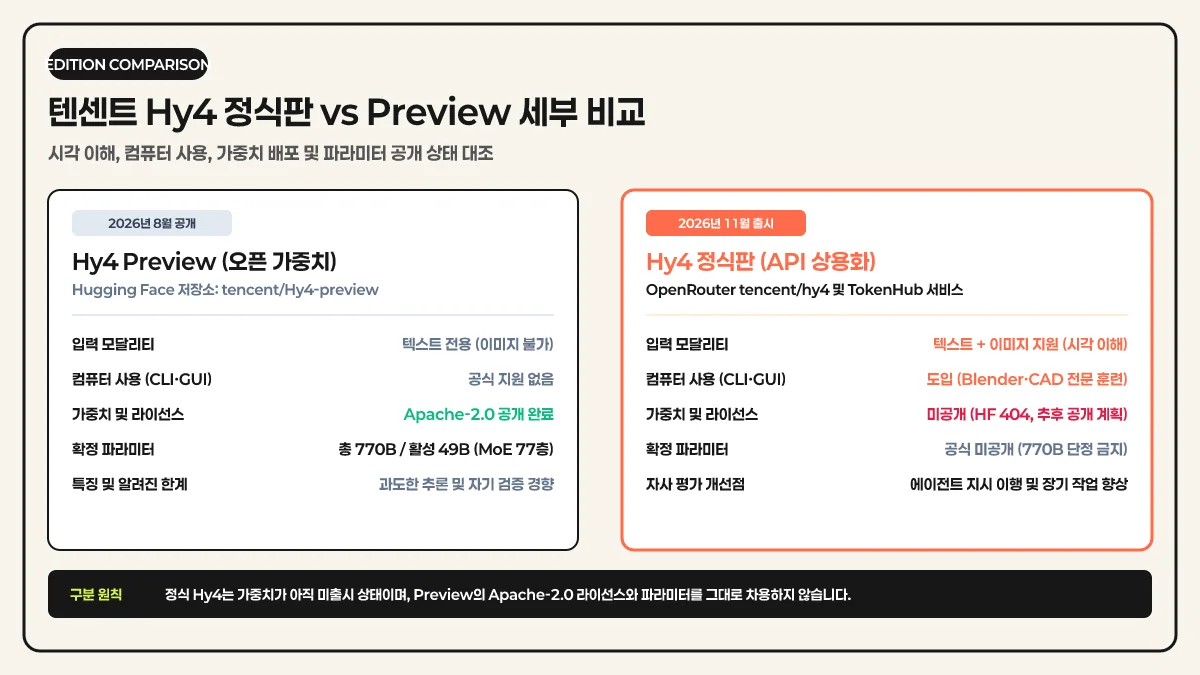
정식판 Hy4와 지난 2026년 8월 28일 공개되었던 Hy4 Preview는 이름이 유사하지만 제품 성격과 기능, 배포 단계에서 뚜렷하게 구별된다. 기술 커뮤니티에서 두 모델의 스펙을 혼용하는 사례가 빈번하므로 정확한 비교가 필수적이다.
가장 두드러진 기능적 변화는 멀티모달 입력과 환경 제어 능력의 추가다. 8월에 나온 Preview 버전은 오직 텍스트 입력만을 처리할 수 있었으며 컴퓨터 인터페이스 조작 기능이 포함되지 않았다. 반면 11월 출시된 정식 Hy4는 고해상도 이미지를 직접 수용하는 시각 이해 체계를 내장했고, CLI 명령어 실행과 GUI 버튼 좌표 인식 등 컴퓨터 사용 기능이 전면 배치되었다.
| 비교 항목 | Hy4 정식판 (tencent/hy4) | Hy4 Preview (tencent/Hy4-preview) |
|---|---|---|
| 출시 일자 | 2026년 11월 4일 (상용 API 출시) | 2026년 8월 28일 (연구 공개) |
| 모델 가중치 배포 | 미출시 (2026-11-05 기준 HF 404, 추후 공개 예정) | Apache-2.0 오픈소스 배포 완료 |
| 확정 총 파라미터 | 공식 발표 자료에 미기재 (미공개 상태) | 770B 총 파라미터 (토큰당 49B 활성) |
| 네트워크 아키텍처 | 세부 구조 문서 미발행 (추후 공개 예정) | 78층 MoE (1층 Dense FFN + 77층 MoE 256 전문가) |
| 입력 모달리티 | 텍스트 및 고해상도 이미지 (시각 이해 도입) | 텍스트 전용 (이미지 입력 불가) |
| 컴퓨터 사용 기능 | 공식 지원 (CLI 및 GUI 상호작용, CAD·Blender) | 공식 미지원 |
| 전체 컨텍스트 창 | 1,048,576 토큰 (입력 960k / 출력 64k) | 1,048,576 토큰 (입력 960k / 출력 64k) |
| 최대 완성 토큰 | 65,536 토큰 | 65,536 토큰 (64k) |
| 표준 리스트 요금 | 입력 $0.834 / 출력 $2.501 (100만 토큰) | 입력 $0.834 / 출력 $2.501 (100만 토큰) |
배포 상태에서도 결정적인 차이가 존재한다. Preview 모델은 공개 당시 허깅페이스(Hugging Face)에 백본 가중치가 아파치 2.0 라이선스로 업로드되어 vLLM이나 SGLang 환경에서 직접 자체 호스팅할 수 있었다. 총 770B 파라미터 중 토큰당 49B가 활성화되는 78층 전문가 혼합(MoE) 구조라는 사실도 이때 확인된 규격이다.
반면 정식판 Hy4는 현재 클라우드 API 형태로만 서비스되고 있다. 2026년 11월 5일 기준 허깅페이스의 공식 저장소 주소는 404 미발견 상태이며 로컬 다운로드가 불가능하다. 텐센트 뉴스룸은 향후 며칠 내에 가중치와 시스템 카드를 책임 있는 오픈소스 원칙에 따라 순차 배포하겠다고 예고한 상태다. 따라서 정식판의 총 파라미터나 활성 파라미터 규모, 최종 배포 라이선스 형태는 아직 확정되지 않았으며, Preview의 770B 규격을 정식판의 제원으로 단정해서는 안 된다.
또한 Preview 모델 카드가 명시했던 알려진 한계점, 즉 복잡한 과제에서 지나치게 오랜 시간 추론을 수행하거나 과도한 자기 검증을 반복하던 특성이 정식판에서 얼마나 해소되었는지는 독립적인 측정 보고서가 아직 발간되지 않았다.
시각 이해와 전문 소프트웨어 컴퓨터 사용 역량
정식 Hy4 모델의 기술적 도약은 시각적 분석과 데스크톱 애플리케이션 제어의 유기적 결합에서 나타난다. 텐센트는 자사 연구 보고를 통해 복합 차트 판독과 다단계 시각 추론 분야에서 이전 세대 대비 상당한 품질 개선을 이뤘다고 설명했다.
시각 이해 모듈은 단순 사물 식별 수준을 넘어선다. 다이어그램의 선 연결 관계, 복잡한 통계 그래프의 범례 대조, 수학 문제에 포함된 기하학적 도형 해석 등 논리적 추론이 수반되는 시각 데이터를 다룰 수 있다. 이는 프로그래밍 작업에서 아키텍처 다이어그램이나 데이터베이스 ERD 구조도를 모델에 입력하고 즉시 관련 데이터 모델 코드를 추출하는 워크플로를 가능하게 만든다.
컴퓨터 사용 기능은 사용자의 운영체제 화면을 프레임 단위로 읽고 필요한 마우스 클릭 및 키보드 입력을 생성하는 방식으로 구동된다. 텐센트는 개발 과정에서 블렌더와 같은 3D 그래픽 도구 및 CAD 엔지니어링 프로그램에 대한 집중 학습을 진행했다고 밝혔다. 복잡한 도면 뷰포트를 회전하거나 부품 레이어의 속성을 검사하고, 터미널 명령을 병행 입력하여 렌더링 파이프라인을 자동화하는 작업이 대표적인 활용 시나리오다.
실무 개발자는 이러한 컴퓨터 조작 능력이 모델 단독으로 완성되는 마법이 아니라는 점을 분명히 이해해야 한다. 에이전트 호스트 환경이 화면 캡처를 모델의 이미지 입력으로 전달하고, 모델이 산출한 좌표와 키보드 액션을 운영체제에 안전하게 전달하는 브리지 인프라가 갖추어져야 한다.
OpenRouter API 호출 환경과 도구 제약 사항
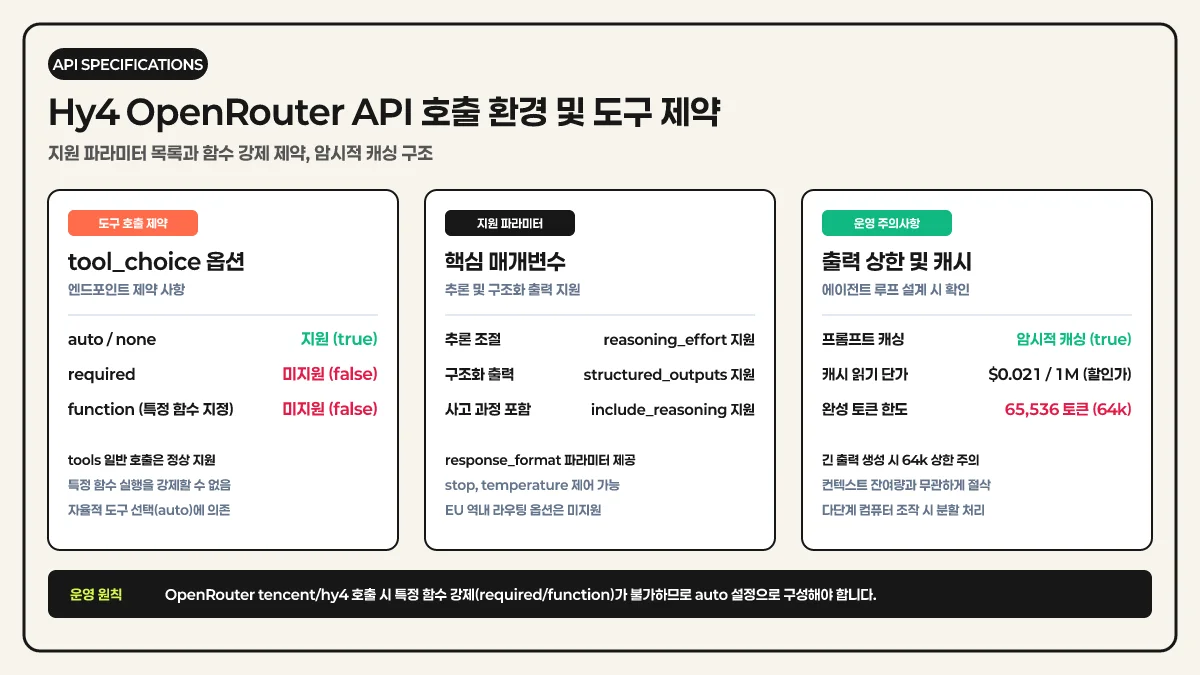
오픈라우터를 통해 Hy4를 호출할 때는 엔드포인트가 제공하는 고유한 매개변수 규격과 기술적 한계를 정확히 파악해야 한다. 공식 엔드포인트 JSON 명세에 따르면 지원되는 파라미터는 tools, tool_choice, reasoning, include_reasoning, reasoning_effort, response_format, structured_outputs, temperature, stop, max_tokens, max_completion_tokens 등이다.
여기서 가장 중요한 기술적 제약은 도구 선택(tool_choice) 제어 방식이다. 오픈라우터 Hy4 엔드포인트는 tool_choice 값으로 auto와 none만 지원하며(true), 특정 함수 실행을 강제하는 function이나 도구 호출을 무조건 요구하는 required 옵션은 지원하지 않는다(false). 즉 프롬프트 지시를 통해 모델이 자율적으로 도구 호출 여부를 결정하도록 유도해야 하며, API 호출 단에서 특정 함수 실행을 기계적으로 강제할 수 없다.
컨텍스트 길이와 출력 한도의 불일치도 반드시 염두에 두어야 한다. 전체 컨텍스트 길이는 1,048,576 토큰에 달하지만, 단일 호출에서 모델이 생성할 수 있는 최대 완성 토큰(max_completion_tokens)은 65,536 토큰(64k)으로 엄격히 제한된다. 토큰허브 콘솔 역시 최대 입력을 960k, 최대 출력을 64k로 나누어 전체 1,024k 창을 관리한다. 따라서 장시간 컴퓨터 조작 로그를 단일 응답으로 수집하려 할 경우 컨텍스트가 충분히 남아 있더라도 64k 출력 상한선에서 응답이 잘릴 위험이 있다.
OpenAI 호환 라이브러리를 활용해 오픈라우터의 Hy4 엔드포인트를 호출하고 시각 추론을 요청하는 기본 파이썬 코드는 다음과 같이 작성할 수 있다.
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="YOUR_OPENROUTER_API_KEY",
)

response = client.chat.completions.create(
    model="tencent/hy4",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "제공된 시스템 아키텍처 다이어그램을 분석하고 서비스 간 데이터 동기화 병목 지점을 진단해 주세요."
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/architecture-spec.png"
                    }
                }
            ]
        }
    ],
    temperature=0.6,
    max_tokens=4096,
)

print(response.choices[0].message.content)
앞의 코드처럼 표준 챗 컴플리션 규격을 따르며 이미지 URL 배열을 손쉽게 결합할 수 있다. 오픈라우터 호스팅 환경의 양자화 태그는 fp4로 지정되어 있으나, 이는 서빙 인프라의 양자화 상태를 가리키며 원본 모델 가중치의 학습 정밀도와는 무관하다. 유럽연합(EU) 역내 데이터 라우팅 옵션은 지원되지 않으므로 개인정보 보호 규정 준수 요건이 엄격한 환경에서는 데이터 전송 경로를 점검해야 한다.
텐센트 공식 평가 결과와 측정 지표 해석
텐센트 영문 뉴스룸은 정식 출시와 함께 다양한 내부 및 파트너십 평가 지표를 공개했다. 다만 이들 수치는 독립된 제3자 벤치마크 기관의 공인 기록이 아니라 자사 연구소 및 제휴 기관이 주관한 맞춤형 과제 결과라는 점을 감안하여 비판적으로 수용해야 한다.
사무 생산성 도구인 워크버디(WorkBuddy) 내부 평가에서 텐센트는 Hy4가 평균 점수 83.18점, 통과율 96.15%를 달성했다고 밝혔다. 중국 본토에서 수집된 12개 실무 시나리오 중 9개 항목에서 1위를 차지했다는 설명이 덧붙었다. 이는 글로벌 전체 모델을 망라한 순위가 아니라 중국 내 특정 업무 도구 테스트베드에서의 내부 성적표다.
금융 전문 과제를 대상으로 진행된 블라인드 테스트에서는 213명의 전문가(외부 전문가 153명 포함, 70% 이상이 경력 5년 초과)가 참여한 579개 과제를 평가했다. 평가 결과 Hy4가 종합 평점 3.04점을 획득해 DeepSeek-V4.1-Flash-1017(2.97점), Kimi K3.1 Pro(2.68점), GLM-5.3(2.68점)을 앞섰다고 발표했다. 라바이트(Rabyte) 내부 iRaB 평가 지수에서도 Preview 대비 12.03% 포인트 향상되었다고 전했다.
| 평가 분야 | 측정 과제 및 환경 | 비교 기준 | 공식 발표 수치 및 변화율 |
|---|---|---|---|
| 사무 생산성 평가 | WorkBuddy 내부 12개 시나리오 | 중국 본토 과제 | 평균 83.18점, 96.15% 통과 (9개 1위) |
| 금융 블라인드 평가 | 전문가 213명 참여 579개 과제 | 경쟁 모델 블라인드 | Hy4 3.04점 (DeepSeek Flash 2.97점 앞섬) |
| 환각 발생률 감소 | 검색 기반 질의응답 내부 평가 | Hy4 Preview 대비 | 환각률 12.95%에서 7.2%로 감소 |
| 전제 오류 감소 | 근거 없는 가정 오류 발생 비율 | Hy4 Preview 대비 | 23.1%에서 5.6%로 급감 |
| 게임 개발 에이전트 | GameDev 및 GameLogic 과제 | Hy4 Preview 대비 | GameDev +19.1%, GameLogic +9.8% 향상 |
검색 및 사실성 검증 지표에서는 정보 왜곡과 환각 현상이 크게 줄었다고 강조했다. 텐센트 자체 평가 기준 환각 발생률은 Preview의 12.95%에서 정식판 7.2%로 감소했으며, 근거 없는 전제에 기반한 오류율은 23.1%에서 5.6%로 하락했다. 게임 개발 역량 평가에서도 GameDev 과제 19.1%, GameLogic 과제 9.8%가 개선되었으며 언리얼 엔진(Unreal Engine), 유니티(Unity), 고도(Godot) 엔진과의 연동 사례를 함께 제시했다.
보안 및 안전성 측면에서는 방어 중심 데이터로 모델을 훈련하고 공격용 익스플로잇 자료를 사전 배제했다고 설명했다. 텐센트 산하 쉬안우 랩(Xuanwu Lab)과 킨 시큐리티 랩(Keen Security Lab)의 점검 결과 사이버 공격 능력에 대한 중대한 우려는 식별되지 않았다고 밝혔다. 생물학 위험 분야의 경우 기초 지식은 우수하지만 개방형 실험 설계 역량은 프런티어 모델보다 제한적이라는 자체 진단을 내렸다.
한편 뉴스룸 소제목에는 경량 버전인 'Hy4 Flash'가 최근 출시된 것처럼 기재되어 있으나, 본문 설명은 곧 출시될 예정(scheduled for release soon)이라고 명시하고 있으므로 아직 상용화되지 않은 후속 모델로 이해해야 한다.
마무리
앞에서 다룬 텐센트 Hy4 정식 모델의 핵심 제원과 API 운영 조건을 정리한다.
- 오픈라우터 tencent/hy4 엔드포인트를 통해 상용 API 서비스가 개시되었다.
- 1,048,576 토큰의 대규모 컨텍스트 창과 시각 이해, 컴퓨터 사용 기능이 탑재되었다.
- 100만 토큰당 입력 0.834달러, 출력 2.501달러 리스트 요금에 50% 프로모션이 적용 중이다.
- 프로모션 종료 시각은 베이징 기준 2026년 12월 31일 23시 59분 59초다.
- 정식판 가중치는 아직 허깅페이스에 미출시 상태이며 세부 파라미터 규모는 공식 미공개다.
- OpenRouter 엔드포인트에서 tool_choice는 auto와 none만 지원하며 함수 강제는 불가능하다.
- 단일 호출 기준 최대 출력 한도는 65,536 토큰으로 제한되므로 분할 처리가 요구된다.
「시각 이해와 100만 창 처리는 50% 할인가의 Hy4로 접근하고, 가중치 자가 호스팅은 향후 정식 릴리스 이후 검토한다.」 연말까지 제공되는 파격적인 추론료 감면 혜택을 활용해 대용량 문서와 도면을 처리하는 에이전트 파이프라인의 경제성을 점검하기에 적절한 시점이다.
출처와 링크
조사 기준 연월: 2026년 11월
FAQ
자주 묻는 질문
텐센트 Hy4 정식판의 모델 가중치를 로컬 서버에 다운로드할 수 있나요?
2026년 11월 5일 현재 시점에서는 정식판 가중치를 다운로드할 수 없습니다. 허깅페이스의 공식 저장소 경로는 404 상태이며 텐센트는 향후 며칠 내에 가중치와 시스템 카드를 순차적으로 공개하겠다고 밝혔습니다. 현재 로컬 설치가 가능한 버전은 지난 8월에 아파치 2.0 라이선스로 배포된 이전 세대인 Hy4 Preview 모델뿐입니다.
오픈라우터에서 tencent/hy4를 호출할 때 적용되는 실제 요금은 얼마인가요?
정규 리스트 요율은 100만 토큰당 입력 0.834달러, 출력 2.501달러, 프롬프트 캐시 읽기 0.042달러입니다. 그러나 2026년 12월 31일 베이징 자정까지 50% 프로모션이 적용되어 현재 오픈라우터에서는 입력 0.417달러, 출력 1.2505달러, 캐시 읽기 0.021달러로 청구됩니다. 프로모션 기한이 지나면 정규 리스트 단가로 환원됩니다.
Hy4 모델에 이미지 파일을 입력으로 전송하여 시각적 분석을 요청할 수 있나요?
정식판 Hy4는 텍스트뿐만 아니라 고해상도 이미지 입력을 완벽하게 지원합니다. 복합 통계 도표, 기하학적 도형, 시스템 아키텍처 다이어그램을 인식하고 시각적 추론을 수행할 수 있습니다. 단 출력 모달리티는 텍스트로만 한정되므로 이미지를 새롭게 생성하거나 편집하여 반환하는 작업은 불가능합니다.
도구 호출(Function Calling) 사용 시 특정 함수를 강제로 실행하도록 지정할 수 있나요?
오픈라우터 tencent/hy4 엔드포인트는 tool_choice 옵션으로 auto와 none만을 허용합니다. 특정 함수 실행을 강제하는 function이나 무조건 도구를 실행하도록 만드는 required 설정은 지원되지 않습니다. 따라서 모델이 문맥을 판단해 자율적으로 도구를 선택하도록 프롬프트를 구성해야 합니다.
정식 Hy4의 전체 파라미터가 Preview와 동일한 770B 규모인가요?
770B 총 파라미터와 토큰당 49B 활성 수치는 8월에 공개된 Hy4 Preview의 확정 제원입니다. 11월에 출시된 정식판 Hy4는 공식 영문 뉴스룸이나 오픈라우터 엔드포인트 명세에 파라미터 규모가 공개되어 있지 않습니다. 따라서 향후 공식 시스템 카드가 발간되기 전까지는 정식판의 파라미터를 770B로 단정하지 않아야 합니다.
100만 토큰 컨텍스트 환경에서 단일 응답으로 생성할 수 있는 최대 출력 길이는 얼마인가요?
전체 컨텍스트 창은 1,048,576 토큰이지만 단일 응답에서 생성 가능한 최대 완성 토큰 상한은 65,536 토큰(64k)입니다. 토큰허브 콘솔 역시 최대 입력을 960k, 최대 출력을 64k로 구분하여 관리합니다. 긴 컴퓨터 조작 로그나 초대형 문서를 출력할 때는 컨텍스트 잔여량과 무관하게 64k 한도에서 응답이 절삭되므로 분할 호출이 필요합니다.
용어
관련 용어
Anthropic이 개발한 AI 모델 시리즈로, 안전성(safety), 정직성(honesty), 유용성(helpfulness)을 핵심 원칙으로 설계되었다. 바이브 코딩에서 가장 널리 사용되는 모델 중 하나이며, 깊은 코드 이해, 상세한 설명 생성, 100만 토큰의 업계 최대급 컨텍스트 윈도우가 주요 강점이다. 현재 Claude 4 패밀리로 구성되어 있으며, Claude Opus 4.6(가장 강력한 최상위 모델), Claude Opus 4.5, Claude Opus 4.1, Claude Opus 4, Claude Sonnet 4의 다섯 가지 모델이 있다. Opus 계열은 복잡한 추론과 대규모 코드 분석에, Sonnet 계열은 빠른 응답과 비용 효율에 최적화되어 있다. Claude Code(CLI 도구)를 통해 터미널에서 직접 사용하거나, Cursor·Windsurf 등 제3자 IDE에서 모델로 선택할 수 있다. API 모델 문자열은 'claude-opus-4-6'이며, 웹·모바일·데스크톱 채팅 인터페이스를 통해서도 접근 가능하다. Constitutional AI라는 독자적인 안전 기술로 유해한 출력을 최소화하면서도 유용한 코드 생성을 유지하는 것이 특징이다.
AI 모델·프로바이더 제미나이Google DeepMind가 개발한 멀티모달 AI 모델 시리즈로, 텍스트·이미지·오디오·비디오·코드를 통합적으로 처리할 수 있는 것이 가장 큰 차별점이다. 다른 모델이 주로 텍스트 기반으로 동작하는 반면, Gemini는 스크린샷을 보고 UI 코드를 생성하거나, 다이어그램을 이해하고 관련 코드를 작성하는 등 시각적 입력을 코딩에 활용할 수 있다. Gemini 2.0 Flash(빠르고 저렴), Gemini Pro(고성능) 등 다양한 변형이 있으며, 용도에 따라 선택할 수 있다. Gemini Code Assist(IDE 기반 코딩 도구)와 Gemini CLI(터미널 에이전트)를 통해 코딩을 지원하며, Google Cloud 생태계(Cloud Functions, Firebase, BigQuery, Vertex AI 등)와 긴밀하게 통합되어 있어 Google Cloud 사용자에게 특히 유리하다. Google의 방대한 데이터와 인프라를 기반으로 하므로, 정보 검색 능력(Grounding with Google Search)이 뛰어나 최신 라이브러리나 API 정보를 반영한 코드 생성에 강점이 있다.
AI 모델·프로바이더 토큰LLM이 텍스트를 처리하는 기본 단위로, AI 모델의 비용 산정과 성능을 이해하는 데 가장 기본이 되는 개념이다. 토크나이저(tokenizer)라는 알고리즘이 텍스트를 토큰으로 분할하며, 단어 하나가 반드시 토큰 하나가 되는 것은 아니다. 영어의 경우 대략 단어 1개 ≈ 1~1.5 토큰이지만, 한국어는 음절 단위로 분할되어 같은 의미의 텍스트가 영어보다 2~3배 많은 토큰을 소비한다(예: '안녕하세요' ≈ 3~5 토큰). 코드의 경우 'console.log("Hello World")' ≈ 약 6토큰이다. 토큰은 AI 코딩 도구의 사용량과 비용을 결정하는 핵심 단위로, API 과금은 입력 토큰과 출력 토큰을 각각 계산한다. 모델마다 다른 토크나이저를 사용하므로, 같은 텍스트도 모델에 따라 소비하는 토큰 수가 다를 수 있다. 바이브 코딩에서 예상보다 비용이 높아지는 주요 원인이 토큰 소비이므로, 컨텍스트 엔지니어링을 통해 불필요한 토큰 소비를 줄이는 것이 비용 관리의 핵심이다.
링크
관련 링크
Google이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
VIBE 코딩 보안 테이텀 시큐리티 Threads쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
관련 글
관련 글
Recommended
LiquidAI LFM3-1.7B 무료 | OpenRouter에서 토큰 요금 없이 부르는 글 모델
OpenRouter의 liquid/lfm-3-1.7b:free는 글을 받아 글로 답하고 토큰 단가가 0이다. 분당과 하루 요청 상한, 학습 보관, 유료 식별자와의 차이를 2026년 11월 9일 기준으로 적는다.
Gemini Omni 1.2 Flash | 15초 영상과 720p 초당 약 7센트
Gemini Omni 1.2 Flash는 글과 사진으로 최대 15초 영상을 만든다. 720p는 초당 약 7센트, 무료 티어는 없다. 길이를 비우면 기본은 10초다. 카드의 9달러는 글이고 영상은 12달러다.