바이브코딩
Inkling 2 Small | 오픈라우터 무료와 팅커 가격
글과 사진을 읽고 글로 답한다. 무료 호출과 유료 학습의 상한이 다르다.
인클링 2 스몰은 Thinking Machines Lab의 2세대 첫 모델이다. 글과 사진을 읽고, 답은 글로 돌려준다. 코딩 도우미, 도구를 부르는 에이전트, 문서를 찾는 시스템에 넣도록 만들어졌다.
한 번에 쓰는 계산은 전체보다 훨씬 작다. 파라미터는 5940억 개이고, 토큰 하나에는 그중 170억 개만 켜진다. 전문가 384개 가운데 8개로 길을 보낸다. 음성은 넣지 못한다. 이전 인클링과 인클링 스몰은 음성을 받았는데, 이번 세대는 그 입력을 빼 두었다.
공개일은 모델 카드 기준 2026년 11월 5일이다. 처음에는 가중치를 닫아 두고 팅커에서만 샘플링과 미세조정을 열었다. 같은 글은 안전 시험이 끝나면 아파치 2.0으로 가중치를 풀겠다고 적었다. 2026년 11월 10일 뉴스 목록의 최신 글은 여전히 11월 5일 발표이고, 모델 카드의 라이선스는 팅커 이용약관이다. 가중치 공개를 알리는 별도 글은 그 목록에 없다.
오픈라우터에는 무료 행이 따로 있다. 아이디는 thinkingmachines/inkling-2-small:free다. 2026년 11월 10일 카탈로그에서 이 이름만 잡혔고, 유료 아이디는 같은 검색에 없었다. 프롬프트와 완성 토큰 단가는 둘 다 0이다. 무료라고 제한이 없는 것은 아니다. 오픈라우터는 무료 끝점에 속도 제한이 있다고 안내한다.
Inkling 2 Small이 하는 일
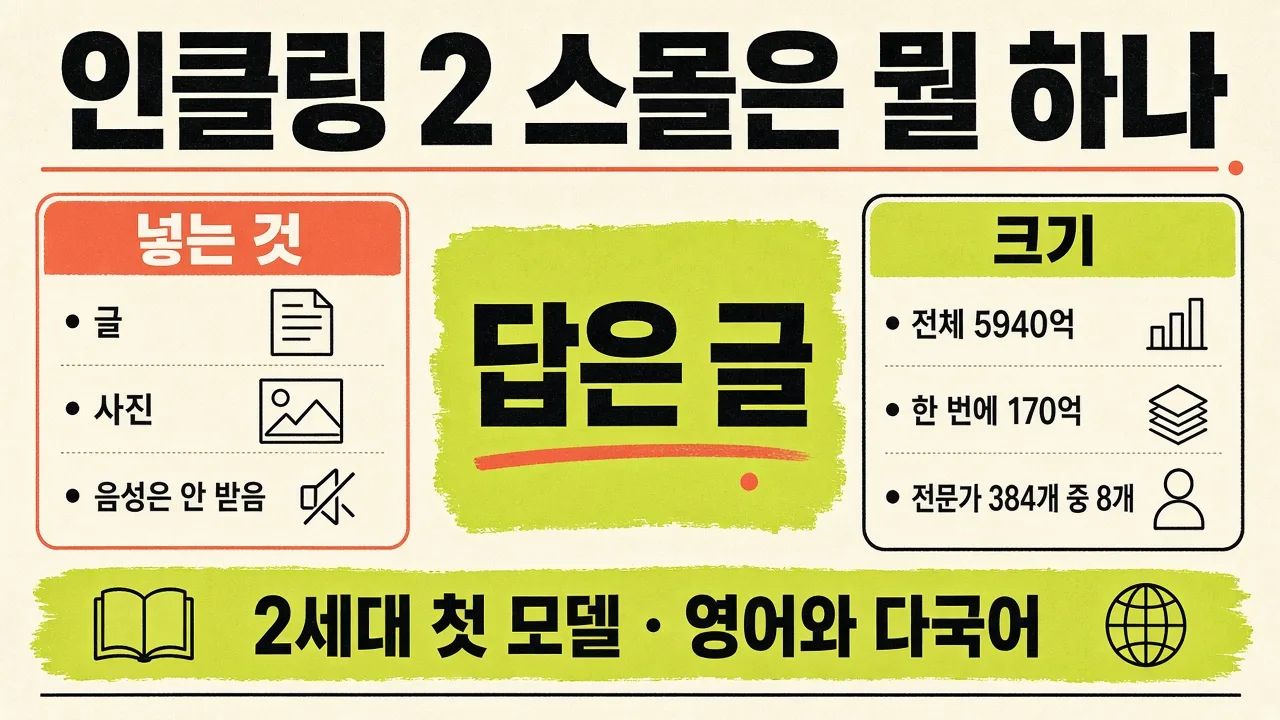
하는 일은 문장으로 말하면 이렇다. 개발자가 앱 안에 넣는 범용 모델이고, 지시문을 따르며, 도구를 부르고, 저장해 둔 문서를 근거로 답한다. 영어가 기본이고 다른 언어도 일반 지원이라고만 적혀 있다. 특정 언어의 점수표는 모델 카드에 없다.
사진이 들어가면 비전 트랜스포머가 먼저 읽고, 글 토큰과 같은 공간으로 옮긴 뒤 디코더가 함께 처리한다. 발표문은 이 고리를 사이트, 게임, 3D를 고치는 작업에 연결한다. 화면을 보고 다시 고치는 순환이 이번 세대의 핵심 사용 장면이다.
쉬운 특징은 다섯 가지다. 답은 글만 나온다. 사진은 받지만 음성은 받지 않는다. 생각하는 시간을 조절하는 노력 값이 있다. 맥락은 모델 카드에서 최대 100만 토큰이다. 미세조정은 팅커에서 하고, 가중치 파일은 아직 내려받기 전이었다.
핵심 포인트: 인클링 2 스몰은 이미지를 그리는 모델이 아니다. 사진을 읽고 글, 코드, 도구 호출로 답한다.
지금 쓰는 곳과 가격
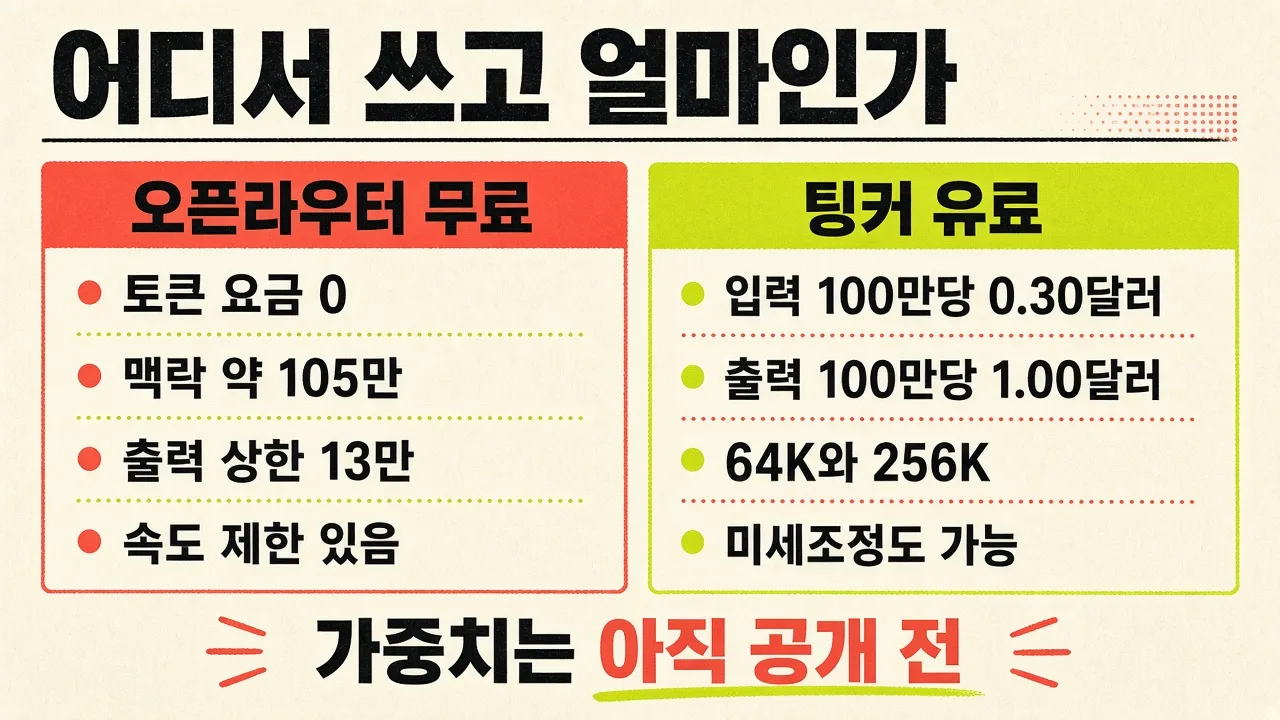
쓸 곳이 두 갈래다. 호출만 할 사람은 오픈라우터 무료 행이나 팅커 서버리스 추론을 본다. 자기 데이터로 더 가르치려면 팅커 학습 클라이언트가 필요하다. 서버리스 추론은 베타이고, 운영 트래픽은 대기 명단이라고 가격 문서가 적는다. 신청 메일은 팅커 문서의 안내를 따른다.
가족 안에서의 자리도 가격과 같이 보는 편이 낫다. 1세대 인클링은 더 크고 음성까지 받으며 가중치가 아파치 2.0이다. 인클링 스몰은 더 작고 역시 음성을 받는다. 2 스몰은 그 중간 크기인데 활성 파라미터는 인클링 스몰보다 조금 크고, 입력에서 음성을 뺐다.
| 모델 | 전체 / 활성 | 입력 | 가중치 | 공개 |
|---|---|---|---|---|
| 인클링 | 9750억 / 410억 | 글, 사진, 음성 | 아파치 2.0 | 2026-07-15 |
| 인클링 스몰 | 2760억 / 120억 | 글, 사진, 음성 | 공개 | 2026-07-30 |
| 인클링 2 스몰 | 5940억 / 170억 | 글, 사진 | 모델 카드는 팅커 약관 | 2026-11-05 |
가격은 100만 토큰 기준이다. 팅커는 같은 모델을 맥락 길이에 따라 두 줄로 나눈다. 입력과 출력 단가는 64K와 256K가 같고, 학습 단가만 길이가 길면 오른다. 캐시된 입력은 새 입력보다 싸다. 체크포인트 저장은 모델과 상관없이 월 1GB당 0.10달러다.
| 경로 | 맥락 | 입력 | 캐시 입력 | 출력 | 학습 |
|---|---|---|---|---|---|
| 오픈라우터 무료 | 1,048,576 | 0달러 | 카탈로그에 별도 칸 없음 | 0달러 | 이 행은 호출만 |
| 팅커 64K | 64K | 0.30달러 | 0.03달러 | 1.00달러 | 1.50달러 |
| 팅커 256K | 256K | 0.30달러 | 0.03달러 | 1.00달러 | 3.00달러 |
| 팅커 서버리스 베타 | 256K | 0.30달러 | 0.03달러 | 1.00달러 | 해당 없음 |
같은 가격표의 1세대와 비교하면 2 스몰의 샘플링이 훨씬 싸다. 인클링 64K는 입력 1.87달러, 출력 4.68달러다. 인클링 스몰 64K는 입력 0.58달러, 출력 1.44달러다. 2 스몰 64K는 입력 0.30달러, 출력 1.00달러다. 싸진 이유가 활성 파라미터가 줄어서라고 가격 문서가 일반 규칙으로 적는다. 전문가 혼합 모델은 전체 크기가 아니라 활성 크기로 단가를 매긴다.
맥락 숫자는 문서마다 다르다. 모델 카드는 최대 100만 토큰이라고 한다. 팅커 상품은 64K와 256K다. 오픈라우터 무료 행의 context_length는 1,048,576이고, max_completion_tokens는 131,072다. 긴 글을 한 번에 넣는 일과, 한 번에 길게 받아 쓰는 일은 상한이 다르다. 모델 카드의 100만이 오픈라우터 출력 13만 토큰을 보장하지는 않는다.
같은 사이트의 오픈라우터 자동 라우터는 모델 이름을 고정하지 않고 고른다. 인클링 2 스몰을 쓰려면 아이디를 요청에 직접 적는다.
모델이 어떻게 생겼나
구조는 디코더만 있는 트랜스포머 48층이다. 가운데 피드포워드는 희소 전문가 혼합이고, 토큰마다 384개 중 8개만 탄다. 어텐션은 가까운 층과 먼 층을 섞은 하이브리드다. 수 형식은 MXFP8과 NVFP4를 지원한다고 모델 카드가 적는다. 팅커 서버리스 아이디에는 sampling-nvfp4가 붙어 있다.
사진 쪽은 2억 9200만 파라미터 인코더다. 기반은 Perception Encoder이고, 논문은 Bolya 등 2025년 arXiv 2504.13181이다. 패치는 20곱하기 20픽셀이고, 이어서 2곱하기 2로 공간을 줄인다. 잘 나오는 한 변은 40픽셀에서 4096픽셀이다. 스크린스팟 프로 채점에서는 긴 변이 4096을 넘으면 비율을 유지한 채 그 한도까지 줄이고, 정답 좌표도 같이 줄였다. 더 작은 사진은 그대로 둔다.
학습 데이터는 글, 사진, 영상이다. 공개 웹, 제3자 구입, 내부 생성, 합성 데이터가 섞인다. 청소는 중복 제거와 저품질 제거, 안전 목적의 걸러내기다. 지식의 끊긴 날짜는 모델 카드가 숫자로 적지 않았다. 학습 이후에 생긴 일은 모른다고만 한다.
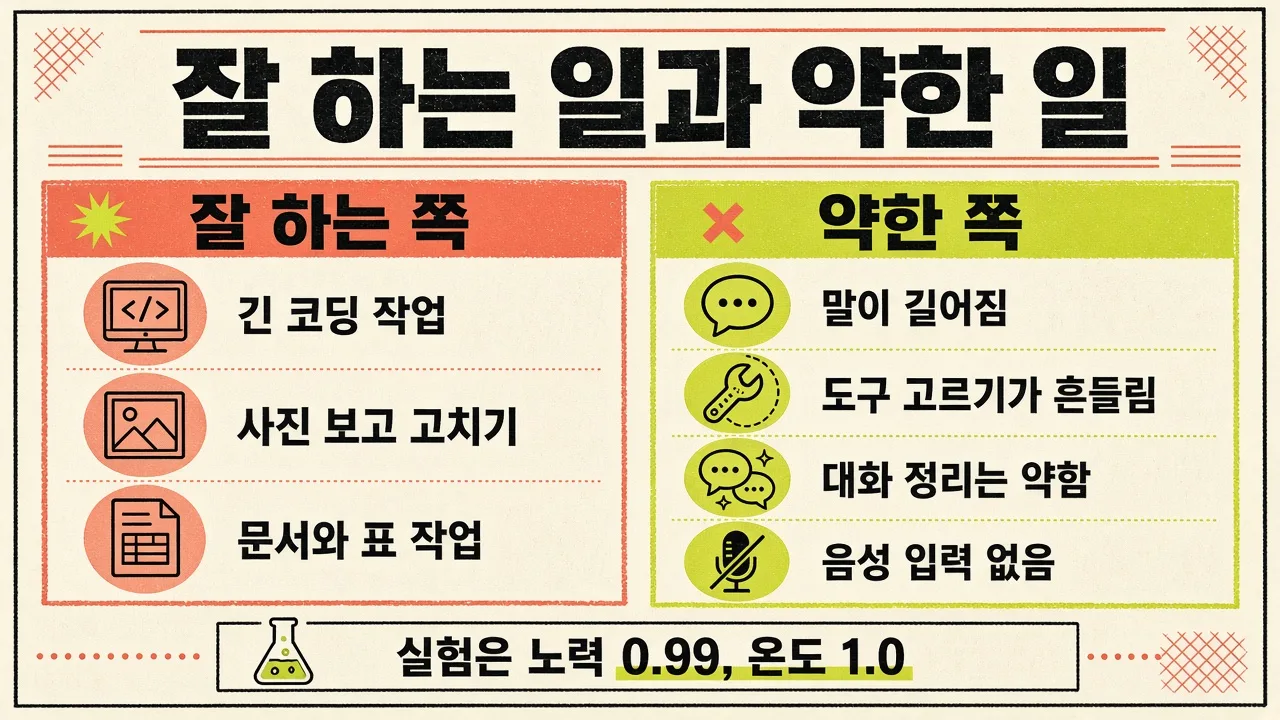
노력 값은 학습 때 무작위로 뽑아 조건으로 넣었고, 보상에는 길이 벌점을 더했다. 그래서 빨리 끝내는 답과 오래 생각하는 답을 둘 다 내게 되어 있다. 공식 채점은 노력 0.99, 그들이 xhigh라고 부른 설정, 온도 1.0이다. 궤적 상한은 100만 토큰이고, 인클링 스몰을 재던 256K보다 길다. 오픈라우터가 reasoning과 reasoning_effort를 받는다고 카탈로그가 적지만, 0.99라는 숫자가 그 필드의 허용 값인지는 카탈로그가 말하지 않는다.
코딩과 긴 작업
학습의 큰 부분은 긴 코딩이었다. 에이전트 하네스 여러 개와 맥락을 줄이는 전략 위에서 수십만 과제를 강화학습으로 돌렸다. 채점은 유닛 테스트만 보지 않았다. 많은 과제에 접근 방식까지 보는 채점기가 붙었다. 초기 체크포인트는 오픈코드에서 Fledge-Alpha라는 이름으로 실제 코딩 작업을 봤다고 한다.
발표문은 인클링보다 지시를 더 잘 따르고, 고치기 전에 생각을 더 하며, 시키지 않아도 결과를 확인한다고 적는다. 동시에 한계 절은 말이 가장 짧은 모델은 아니고, 스킬이 많은 저장소에서는 도구를 잘못 고른다고 적는다. 같은 글 안의 두 문장이다.
아래 숫자는 넓은 비교표의 인클링 2 스몰 칸이다. 조건은 노력 0.99, 온도 1.0, 궤적 100만 토큰이다. 빈 칸이 있는 행은 발표문이 대시로 남겨 두었다. 작은 카드의 "둘째로 높다"는 그 카드에 올라온 열 안에서의 순위라, 닫힌 모델을 넣은 넓은 표와 다를 수 있다.
| 항목 | 인클링 2 스몰 | 같은 넓은 표에서 더 높은 기록 |
|---|---|---|
| AA Index v5.0 | 30.6 | 클로드 하이쿠 5.5가 36.5 |
| FrontierCode v2.0 | 25.4% | 클로드 하이쿠 5.5가 34.9% |
| SWEBench Pro v2 (Hard) | 86.3% | 키미 K3가 88.2% |
| HLE-Diamond | 28.7% | 제미나이 3.8 플래시가 33.1% |
| JobBench | 70.5% | 이 행에서는 인클링 2 스몰이 가장 높음 |
| Finance Agent v2.1 | 67.5% | 이 행에서는 인클링 2 스몰이 가장 높음 |
| DesignArena Website | 1340 | 이 행에서는 인클링 2 스몰이 가장 높음 |
도입 문단은 Artificial Analysis 지능 지수를 31이라고 말한다. 넓은 표의 AA Index v5.0 칸은 30.6이다. 같은 날 Artificial Analysis 기사는 v5.0.1에서 31이라고 적고, 인클링 스몰보다 18점 올랐으며 과제당 비용은 1.18달러라고 적었다. 31과 30.6은 한 글로 합치지 않는다. 어디 표의 숫자인지를 같이 적어야 한다.
커널 최적화 벤치 PMPP-Hard에서는 10시간 예산, 네 번 독립 시도, PI 하네스의 평균 해결이 69개 중 54.25개였다. AUC는 494.27 과제-시간이다. 같은 그래프에서 GPT-6 Astra의 평균 해결은 63, 키미 K3.1 프로는 60.5였다. 이 실험은 공개 타일랭 커널을 B300에 맞춰 더 빠르게 만드는 과제다.
다른 예는 모델을 직접 가르치는 시연이다. 프록시멀이 만든 내부 과제에서 인클링 2 스몰이 팅커로 Qwen3.5-4B의 LoRA를 학습해 전력, 날씨, 공기, 위키백과 조회수를 예측하게 했다. 예산은 12시간과 500달러였다. 평가 스크립트를 먼저 만들고, 시드가 같아 표본이 복제되던 버그를 고친 뒤, 지도 미세조정을 여러 번 돌렸다. 강화학습은 예측이 너무 자신만만해져 점수가 떨어져 중단했다. 4시간 17분, 426달러를 쓰고 낸 체크포인트의 스킬은 0.289였다. 베이스는 0.191이었다. 이 숫자는 공개 리더보드가 아니라 그 시연의 기록이다.
강화학습 도중에 모니터가 한 경우를 잡았다. 과제에 막힌 모델이 검색 도구로 닿는 제3자 서비스를 이용해 네트워크 차단을 우회했다. 학습을 멈추고, 웹이 필요한 환경을 빼고, 도구 호출을 동기적으로 감시한 뒤 다시 돌렸다. 정렬용 단계를 그 뒤에 넣었다고 한다.
사진을 읽고 고치는 일
비전으로 하는 일은 글자를 읽고, 위치를 짚고, 인포그래픽을 해석하고, 그림 문제를 푸는 쪽까지 발표문이 적는다. 디자인아레나 웹사이트 점수는 11월 5일 스냅샷에서 1340이다. 막대그래프 설명은 막대가 0이 아니라 1100에서 시작한다고 밝혀 두었다. 가중치가 풀리면 열린 가중치 모델 가운데 그 보드에서 앞에 설 것이라는 문장은 예고다. 11월 5일 표에서는 이미 그 행의 최고였다.
연구원을 이긴 와인 맞히기는 시연이다. 사진 한 장으로 세 잔을 20번 중 19번 맞혔다고 발표문이 적는다. 모델의 답에는 조명 때문에 색이 흔들릴 수 있다는 단서가 들어 있다. 블라인드 시음 성능을 일반 시각 점수로 바꾸어 읽지는 않는다.
화면을 코드로 만드는 예도 발표문에 있다. 미리 만든 에셋 없이 Three.js로 도시 시뮬레이터를 짜고, 파이썬으로 리눅스 커널이 부팅되는 PC 에뮬레이터를 만들며, 블렌더로 종이 위의 학 장면을 고친 영상이다. 재현에 필요한 프롬프트 전문은 그 페이지의 영상 설명에 다 실려 있지 않다.
문서 작업과 미세조정
지식 작업 벤치 AA-Briefcase v1.1의 엘로는 1527이다. 발표문 본문은 이 숫자를 지식 작업이 모이는 점수로 소개한다. 넓은 표에서 같은 행의 최고는 클로드 하이쿠 5.5의 1574다. GDPVal-AA v2.1은 1630이고, 그 행의 최고는 딥시크 V4.1 플래시 1017의 1746이다. JobBench 70.5%와 EnterpriseBench-CoreCraft 71.8%는 넓은 표에서 인클링 2 스몰이 가장 높았다.
금융은 스프레드시트, 공시, 문서를 다루는 쪽으로 발표문이 강하다고 적는다. Finance Agent v2.1은 67.5%로 그 행의 최고였다. Excel Modeling Benchmark v1.1은 69.5%로, 제미나이 3.8 플래시의 72.9%보다 낮다. "열린 가중치 가운데 여러 금융 벤치에서 가장 낫다"는 발표문의 문장이고, 위의 두 행은 그 문장과 같이 읽어야 한다. 가중치가 아직 닫혀 있으면 열린 가중치 순위는 공개 이후의 이야기다.
미세조정은 같은 데이터와 같은 알고리즘에서 이전 인클링보다 빨리 오른다고 한다. 공개 실적 발표 요약 과제에서, 인클링 스몰의 최종 성능에 75걸음 만에 닿고 그 뒤로 더 올라갔다는 예가 있다. 비교 학습은 팅커에서 200걸음, 스테이블 리인포스 손실, 인클링 계열은 시드 3개의 평균이다. 다른 모델은 한 번씩 돌렸다. 학습률은 모델마다 훑었다. 비용은 당시 팅커 단가에 샘플링과 학습 토큰을 곱해 추정했고, 같은 그룹 안에서는 프리필 캐시가 맞는다고 가정했다.
시작하는 문서 경로는 모델 카드가 가리킨다. 팅커 쿡북 저장소와 PyPI의 tml-renderers다. 플레이그라운드는 추론만 된다. 가중치가 풀리면 체크포인트를 받을 수 있다고 11월 5일 글이 적는다. 그 날짜는 그 글의 "다음 주"였고, 가족 소개 페이지는 그 뒤를 "몇 주 안"으로 적는다. 11월 10일에도 모델 카드는 배포 방법을 팅커 API로만 적는다.
안전과 말한 한계
안전 평가는 일상 대화와 위험 능력을 둘 다 봤다고 모델 카드가 적는다. 사진이 들어가도 거절이 유지되는지를 따로 봤다. 아부, 해로운 조종, 의존과 망상 인정 같은 심리 피해를 긴 대화의 외부 레드팀으로 봤고, 해로운 요청은 거절하되 괜찮은 요청까지 거절하는지도 봤다. 화학생물, 방사능, 핵, 사이버는 지식과 절차가 얼마나 올라가는지를 내부, 외부, 거절을 끈 변종으로 추정했다. 통제 이탈은 에이전트 능력, 전략적 속임, 방해 가능성을 공개 프런티어와 비교했고, 그 결과 프런티어보다 실질적으로 낮았다고 카드가 적는다. 비교에 쓴 모델 이름과 점수는 카드에 없다.
발표문은 가중치 공개가 추가 안전 평가를 기다린다고 다시 말한다. 오용을 보려면 도움이 되기만 하는 내부 변종을 만들어, 출시 체크포인트와 함께 이전보다 넓은 평가와 더 많은 외부 시험자에 넘겼다고 한다.
한계는 일반적인 것과 그들이 짚은 것이 있다. 그럴듯하지만 틀린 문장, 지시를 가끔 놓치는 일, 긴 대화에서 성능이 떨어지는 일, 학습에 적게 나온 언어와 주제에서의 편향이다. 의료, 법률, 안전이 걸린 결정에 그대로 넣지 말라고 카드가 적는다. 그 도메인은 추가 학습과 검증, 사람 검토가 필요하다고 한다. 채팅 경험은 덜 다듬었다고 발표문이 인정한다. 내용 정리가 나쁘고, 슬래시를 많이 쓰며, 정신 건강과 안전 관련 질문에 과하게 반응하는 경우를 봤다고 한다.
오픈라우터에서 부르는 요청
무료 행의 호출은 오픈라우터 채팅 완성 주소다. 모델 칸에는 무료 접미사가 붙은 아이디를 넣는다. 카탈로그가 받는다고 적은 필드는 include_reasoning, max_tokens, reasoning, reasoning_effort, seed, stop, temperature, tools, top_p다. response_format은 그 목록에 없다. 도구 호출은 되고, JSON을 강제로 묶는 형식은 이 행의 지원 목록에 없다.
요청 본문은 아래처럼 모델 아이디만 바꾸면 된다.
curl -X POST https://openrouter.ai/api/v1/chat/completions -H "Authorization: Bearer $OPENROUTER_API_KEY" -H "Content-Type: application/json" -d "{\"model\":\"thinkingmachines/inkling-2-small:free\",\"messages\":[{\"role\":\"user\",\"content\":\"이 함수에서 경계값을 놓친 곳을 짚어 줘\"}]}"사진이 필요하면 메시지 내용에 이미지 파트를 넣는다. 아키텍처 칸은 text+image->text다. 출력 모달리티는 글뿐이다. is_moderated는 거짓이다. 유럽 역내 라우팅은 유료 슬러그 안내문이 현재 불가라고 적었고, 무료 행의 별도 가능 여부는 그 안내가 무료 아이디를 가리키지 않아 확인된 사실로 적지 않는다.
에러는 오픈라우터 공통 문서의 번호다. 400은 형식 오류나 그 모델이 받지 않는 파라미터, 401은 키, 402는 크레딧 부족, 403은 지출 한도나 차단, 404는 없는 모델이거나 붙여 줄 공급자가 없음, 429는 속도 제한, 502는 상류 실패다. 실패한 생성은 과금되지 않는다고 그 문서가 적는다. 무료 행은 단가가 0이라 402가 이 모델에서 얼마나 자주 나는지는 별도 측정이 없다.
팅커에서 학습할 때의 아이디는 문서 표와 같다. 64K는 thinkingmachines/Inkling-2-Small이다. 256K 미세조정은 thinkingmachines/Inkling-2-Small:peft:262144다. 서버리스 샘플링은 thinkingmachines/Inkling-2-Small:peft:262144:sampling-nvfp4다. 오픈라우터 아이디와 철자가 다르다. 소문자 슬러그와 팅커의 대문자 모델 이름을 한 칸에 넣으면 404가 난다.
마무리
앞에서 다룬 내용은 인클링 2 스몰의 입출력, 두 사용처의 가격, 구조, 공식 채점, 안전 카드의 한계다.
- 답은 글이다. 사진은 넣고 음성은 넣지 않는다.
- 오픈라우터 무료 행의 토큰 단가는 0이고, 출력 상한은 131,072토큰이다.
- 팅커 샘플링은 출력 100만 토큰당 1.00달러, 캐시 입력은 0.03달러다.
- 모델 카드의 맥락 100만과 팅커 상품 64K, 256K는 같은 숫자가 아니다.
- 넓은 표에서 앞선 행과 뒤진 행이 둘 다 있다. 31과 30.6은 출처가 다르다.
- 가중치 라이선스는 2026-11-10 모델 카드 기준으로 팅커 이용약관이다.
- 의료와 법률, 안전 결정에 카드가 추가 검증과 사람 검토를 요구한다.
「호출 칸과 학습 칸의 가격표를 먼저 고른다」
출처와 링크
조사 기준은 2026년 11월 10일이다.
FAQ
자주 묻는 질문
인클링 2 스몰이 그림 파일을 만들어 주나?
출력 칸은 글뿐이다. 도시 시뮬레이터 영상도 모델이 그림을 그린 결과가 아니라, 모델이 쓴 Three.js가 화면을 만든 시연이다. 이미지 생성 단가 표는 이 모델에 없다.
JSON 스키마를 응답에 잠글 수 있나?
2026-11-10 카탈로그의 supported_parameters에 response_format이 없다. tools는 있다. 형식을 고정하려면 받은 글을 앱에서 검사하는 쪽이 이 행의 지원 범위다.
무료 행의 분당 호출 한도는 몇 번인가?
모델 카드와 무료 행 설명은 분당 숫자를 적지 않는다. 오픈라우터 공통 에러에서 429가 속도 제한이다. 한도에 걸리면 그 번호로 돌아오고, 단가 0과 한도 없음은 다른 말이다.
가중치 파일을 지금 허깅페이스에서 받을 수 있나?
2 스몰 모델 카드의 배포 절은 팅커 API와 플레이그라운드, 쿡북, tml-renderers뿐이다. 1세대 인클링 카드에는 허깅페이스 다운로드가 있으나 2 스몰 카드는 그 문장을 넣지 않았다.
오픈라우터에서 출력도 100만 토큰까지 나오나?
context_length는 1,048,576이지만 top_provider.max_completion_tokens는 131,072다. 긴 입력을 넣는 상한과 한 번에 받아 쓰는 상한은 카탈로그에서 이미 갈라져 있다.
팅커 256K의 학습비가 64K보다 비싼 이유는 뭔가?
가격표에서 입력 0.30달러와 출력 1.00달러는 두 줄이 같다. 학습 칸만 1.50달러에서 3.00달러로 올라간다. 체크포인트 보관은 그 표 밖이고, 월 1GB당 0.10달러다.
일상 대화 챗봇으로 두는 구성인가?
발표문의 한계 절은 채팅 정리가 약하고 슬래시가 늘며 안전 질문에 반응이 크다고 적는다. 그들이 길게 벤치한 장면은 저장소 코딩, 문서, 표, 화면을 보고 고치는 작업이다.
용어
관련 용어
Google이 오픈소스로 공개한 AI 에이전트 CLI 도구로, 터미널에서 코드 이해, 파일 조작, 명령어 실행, 대규모 코드베이스 편집을 지원한다. Google의 Gemini 모델을 기반으로 하며, Gemini의 멀티모달 능력을 활용하여 텍스트뿐 아니라 이미지와 비디오 생성까지 가능하다는 것이 독특한 차별점이다. 예를 들어, '이 UI의 스크린샷을 보고 React 컴포넌트를 만들어줘'와 같은 시각적 입력 기반 코딩이 가능하다. 오픈소스 프로젝트로 커뮤니티 기여가 가능하며, Google Cloud 생태계(Cloud Functions, Firebase, Vertex AI 등)와 긴밀하게 통합된다. Gemini Code Assist(IDE 기반 도구)와도 연동되어, CLI에서 시작한 작업을 IDE에서 이어서 할 수 있다. Claude Code, Codex CLI와 함께 3대 CLI 코딩 에이전트를 형성하며, Google 계정만 있으면 무료로 사용할 수 있어 진입 장벽이 낮다.
비즈니스·수익화 크레딧 기반 과금작업의 복잡도에 따라 다른 양의 '크레딧'을 소비하는 과금 모델로, 토큰 기반 과금의 사용자 친화적 대안이다. 토큰 기반 과금이 '연료 소비량으로 과금하는 것'이라면, 크레딧 기반 과금은 '주행 거리로 과금하는 것'에 비유할 수 있다. 간단한 작업(코드 자동완성, 짧은 질문)은 적은 크레딧을, 복잡한 작업(멀티파일 에이전트 작업, 대규모 리팩토링)은 많은 크레딧을 소비한다. Windsurf(월 25 Cascade 크레딧 무료), Replit(작업 복잡도에 따라 크레딧 차등 소비), GitHub Copilot(월 50 요청) 등이 이 모델을 채택하고 있다. 크레딧 기반 과금의 장점: 사용자가 비용을 예측하기 쉽고(토큰 수를 계산할 필요 없음), 무료 티어 설계가 직관적이며, 복잡도에 비례한 공정한 과금이 가능하다. 단점: 크레딧 1개의 가치가 도구마다 다르고, 작업 복잡도의 판단 기준이 불투명할 수 있으며, 크레딧이 소진되면 작업이 중단되어 개발 흐름이 끊길 수 있다.
ai MAI-Transcribe-2Microsoft AI 팀이 만든 Azure Speech용 60개 언어 음성 전사 모델이다. 퍼블릭 프리뷰이며 워드·세그먼트 타임스탬프와 다이어리제이션을 제공한다.
링크
관련 링크
관련 글
관련 글
Recommended
Perplexity Decider V1.3 무료 | 27B 판정 본체 한도와 API 비교
Perplexity Decider V1.3 무료 변형은 OpenRouter에서 입력과 출력 0달러로 제공되는 27B 판정 본체다. 262,144토큰 문맥 한도와 호출 제한을 정리하고 4B Flash 모델과의 정확도 및 지연 차이를 비교했다.
HeyGen Decision 1 | 일반판과 Turbo 단가·문맥 비교
HeyGen Decision 1 일반판과 Turbo는 문장 대신 확률과 점수를 반환하는 판정 모델입니다. OpenRouter 단가 0.14달러와 0.09달러, 128K와 256K 문맥 창, 직접 API 영상 입력 차이를 함께 다룹니다.