바이브코딩
Cloudflare AI Search | 사용법, 가격, 기존 RAG와 차이, 멀티모달
옛 AutoRAG가 2026년 10월 1일 정식 출시됐다. 대시보드와 Workers 코드로 시작하는 법, 11월 1일 과금 계산, 직접 만드는 RAG와의 차이, 이미지 검색과 OCR, 연결되는 Cloudflare 제품 정리
Cloudflare AI Search는 내 문서나 웹사이트를 넣으면 AI가 찾아 주고 답해 주는 검색 기능이다. 이 검색을 Cloudflare가 통째로 운영한다. 파일을 올리거나 사이트를 연결하고 질문을 하면, 관련 부분을 찾아 주거나 그 내용으로 답을 만든다.
매뉴얼을 검색하는 사이트, 사내 문서를 찾아 답하는 에이전트, 고객마다 자기 파일을 검색하게 하는 서비스에 쓰인다. Cloudflare도 자사 블로그와 개발자 문서 검색에 같은 기능을 쓴다.
2026년 10월 1일은 정식 출시된 날이다. 처음 나온 것은 2025년 4월 7일 AutoRAG 오픈 베타이고, 2025년 9월 25일에 이름이 AI Search로 바뀌었다. 사용량 과금은 2026년 11월 1일부터다.
매달 계정에 무료로 포함되는 양이 있다. 글 수백 편 정도의 개인 문서라면 수집과 저장은 그 안에 들어간다. 검색 횟수가 포함량을 넘으면 그때부터 질의 요금이 붙는다.
Cloudflare AI Search는 무엇인가
한 줄로 말하면, 넣은 자료를 알아서 색인하고 자연어로 찾게 해 주는 관리형 검색이다. 검색 대상은 올린 파일과 연결한 내 자료다.
공식 설명은 앱과 에이전트를 위한 검색의 기본 기능이라는 쪽에 가깝다. 인스턴스를 만들고 데이터를 주면 자연어로 검색한다. 구성은 Workers AI, Vectorize, R2, Browser Run을 하나로 묶은 색인과 검색 파이프라인이다.
하는 일은 다섯 가지로 모인다. 파일이나 사이트를 넣으면 문서를 잘게 나누고 벡터로 바꿔 자동으로 색인한다. 검색은 뜻이 비슷한 문장과, 단어가 그대로 있는 문장을 같이 본다. 찾은 내용으로 답을 만들 수 있다. 그림과 스캔한 문서의 글자도 검색에 넣는다. MCP로 에이전트가 이 검색을 도구처럼 부른다.
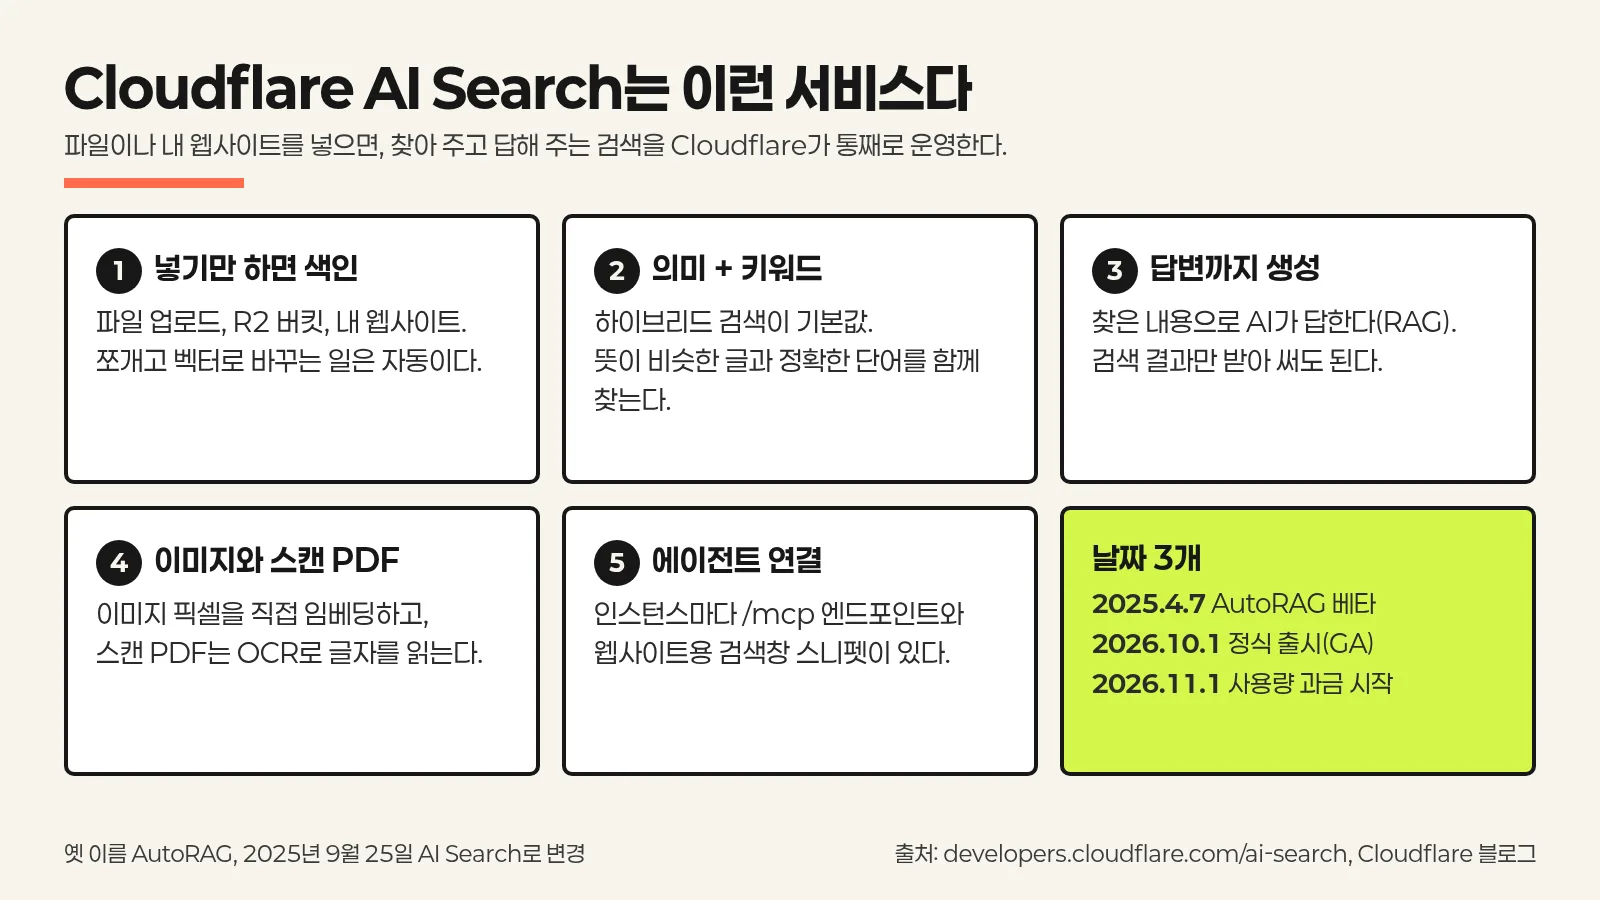
RAG는 질문과 관련된 문서를 먼저 찾고, 그 문장을 근거로 AI가 답을 만드는 방식이다. AI Search는 찾기만 하고 끝낼 수도 있고, 이어서 답까지 만들 수도 있다. 찾기만 하면 청크가 돌아오고, 답을 만들면 그 청크를 읽은 문장이 돌아온다.
AutoRAG는 이 제품의 옛 이름이다. AI Gateway는 다른 제품이다. Gateway는 LLM으로 가는 요청을 감시하고 제어한다. AI Search는 문서를 찾아 답하는 검색이다. 이름이 비슷해도 하는 일이 다르다.
옛 호출 방식은 한동안 같이 동작한다. env.AI.autorag("name") 형태의 레거시 바인딩도 남아 있다. 새 기능은 ai_search 바인딩과 ai_search_namespaces 쪽에 들어간다. 검색 결과는 chunks로 받는다.
지금 알아둘 것
매달 계정에 포함되는 무료분은 네 가지다. 수집 토큰 500만 개, 저장 10 GB-month, 시맨틱 질의 1,000회, 전문 질의 1,000회다. 이 양은 계정마다 매달 다시 주어진다. 글 수백 편을 넣는 수집과, 그 정도 크기의 저장은 이 안에 들어가는 규모다.
사용량 과금은 2026년 11월 1일에 시작된다. 그 날짜 이후에는 포함량을 넘는 수집, 저장, 질의가 청구된다. 답을 만드는 생성과, 질문을 검색어로 다시 쓰는 작업은 이 네 가지 포함량 밖이다.
임베딩, 리랭킹, 저장, 벡터 색인, 웹사이트 크롤에 쓰는 Browser Run은 AI Search 요금에 포함된다. 이 호출은 Workers AI 청구서나 AI Gateway 로그에 따로 나타나지 않는다. 답변 생성, 질의 재작성, OpenAI 같은 외부 모델 호출은 해당 서비스 쪽으로 청구된다.
핵심 포인트: 한국어, 일본어, 중국어 문서는 키워드 토크나이저를 trigram으로 둔다. 기본값 porter는 영어 어간용이라 한국어 키워드 검색이 0건이 될 수 있다. trigram에서는 3글자보다 짧은 단어가 단독으로 맞지 않고, 토크나이저를 나중에 바꾸면 전체를 다시 색인한다.
2026년 10월 16일부터 이 trigram이 한국어, 일본어, 중국어 질의 매칭을 지원한다. porter는 영어 어간 처리가 기본이고 공백과 구두점으로 자른다. 한국어는 단어 끝에 기능어가 붙어 그 경계와 어긋난다. trigram은 코드처럼 공백이 드문 문자열에도 맞다.
웹으로 가져오는 자료는 같은 Cloudflare 계정에 올라간 내 도메인만 가능하다. 다른 사람의 사이트를 크롤 대상으로 지정하는 기능은 없다. 제품 자체는 모든 플랜에서 만들 수 있다. Workers Free에서 먼저 닿는 상한은 하루 크롤 500페이지다. Workers Paid에는 그 하루 상한이 없다.
대시보드에서 시작하는 법
인스턴스는 대시보드에서 여섯 단계로 만든다. 한국어 문서와 스캔 PDF는 파일을 넣기 전에 설정을 맞춘다. 색인이 끝난 뒤에 토크나이저나 OCR을 바꾸면 문서 전체를 다시 색인한다.
- Cloudflare 대시보드의 AI Search로 들어간다. 경로는
dash.cloudflare.com/?to=/:account/ai/ai-search다. - Create Instance를 누른다.
- 인스턴스 이름을 입력한다.
- 필요할 때 데이터 소스를 연결한다. 대상은 내 웹사이트 또는 R2 버킷이다. 연결하지 않아도 모든 인스턴스에는 내장 스토리지가 있다.
- 설정을 검토한다. 한국어 문서라면 이 단계에서 키워드 토크나이저를 trigram으로 둔다. 만든 뒤에 바꾸면 전체 재색인이다.
- Create로 인스턴스를 만든다.
만든 뒤에는 인스턴스의 Items 탭에서 파일을 올린다. 올리면 자동으로 색인되고, 내장 스토리지는 별도의 동기화 작업을 기다리지 않는다. 스캔한 PDF를 넣을 거면 업로드 전에 OCR을 켠다. 설정은 indexing_options.use_ocr를 true로 두는 것이고 기본값은 꺼짐이다. OCR을 나중에 바꾸면 역시 전체를 다시 색인한다.
파일 크기 상한은 종류마다 다르다. 일반 텍스트와 코드는 10 MiB, OCR을 켠 PDF는 10 MiB, OCR 없는 PDF와 그 밖의 형식은 4 MiB다. 넘거나 지원하지 않는 파일은 색인하지 않고 오류 로그에 남는다. 시험은 Playground 탭의 Chat 또는 Search에 질문을 넣어 본다. 앱에 연결할 때는 Workers 바인딩이나 REST API를 쓴다.
Workers 바인딩 코드 예제
대시보드 대신 코드로 붙일 때는 Worker 프로젝트에 바인딩을 선언한다. AI Search는 개발 머신 안에서 뜨지 않는다. 그래서 로컬 서버는 이미 만들어 둔 인스턴스로 요청을 넘긴다.
터미널에서 튜토리얼용 Worker 프로젝트를 만드는 명령은 아래와 같다.
npm create cloudflare@latest -- ai-search-tutorial프롬프트에서는 Hello World 예제, Worker only, TypeScript를 차례로 고른다. 네임스페이스 바인딩을 넣는 파일은 프로젝트의 wrangler.jsonc다.
{
  "$schema": "./node_modules/wrangler/config-schema.json",
  "ai_search_namespaces": [
    {
      "binding": "AI_SEARCH",
      "namespace": "default",
      "remote": true
    }
  ]
}remote를 true로 두는 이유는 AI Search가 로컬에서 돌지 않기 때문이다. npx wrangler dev가 배포된 인스턴스로 요청을 넘긴다. 요청을 처리하는 코드는 src/index.ts에 둔다.
export interface Env {
	AI_SEARCH: AiSearchNamespace;
}

export default {
	async fetch(request, env): Promise<Response> {
		const url = new URL(request.url);

		// Visit /setup once to create an instance and index a sample document.
		if (url.pathname === "/setup") {
			const instance = await env.AI_SEARCH.create({ id: "my-instance" });
			const item = await instance.items.uploadAndPoll(
				"getting-started.md",
				"AI Search indexes uploaded content for retrieval.",
			);
			return Response.json({ created: "my-instance", status: item.status });
		}

		// Query the instance.
		const query = url.searchParams.get("q") ?? "What does AI Search do?";

		const results = await env.AI_SEARCH.get("my-instance").search({
			messages: [{ role: "user", content: query }],
			ai_search_options: {
				retrieval: { max_num_results: 3 },
			},
		});

		return Response.json(results.chunks);
	},
} satisfies ExportedHandler<Env>;/setup은 인스턴스 my-instance를 만들고 getting-started.md를 올린 뒤 status를 돌려준다. 그 다음 q 파라미터로 검색한다. 파라미터가 없으면 기본 질문은 What does AI Search do?다. messages 배열의 사용자 문장으로 찾고, 이 예제는 청크를 3개까지 받아 JSON으로 돌려준다.
로컬 확인은 터미널의 npx wrangler dev다. 보통 localhost:8787에 뜬다. /setup을 한 번 연 다음 /?q=검색어로 질의한다. 계정 연결은 npx wrangler login, 배포는 npx wrangler deploy다.
찾은 청크로 답을 만들 때는 같은 인스턴스의 chatCompletions를 호출한다.
const instance = env.AI_SEARCH.get("my-instance");
const response = await instance.chatCompletions({
	messages: [
		{ role: "system", content: "You are a helpful documentation assistant." },
		{ role: "user", content: "What is Cloudflare?" },
	],
});
시스템 메시지와 사용자 메시지를 함께 넘기면, 검색된 내용을 근거로 답을 만든다. 스트리밍은 stream: true를 넣고, 돌아온 스트림을 new Response(stream, { headers: { "content-type": "text/event-stream" } })로 감싼다. 이벤트는 청크가 먼저 오고, 답 조각이 이어진 뒤, 마지막에 [DONE]이 온다.
인스턴스 하나만 연결할 때의 wrangler.jsonc는 ai_search 바인딩을 쓴다.
{
  "ai_search": [
    { "binding": "MY_SEARCH", "instance_name": "my-instance" }
  ]
}
이 형태는 인스턴스 하나를 바인딩 이름에 고정해서, 코드에서는 env.MY_SEARCH.search()처럼 바로 부른다. 네임스페이스 방식은 env.AI_SEARCH.get("name")으로 인스턴스를 고르고, 런타임에 인스턴스를 만들거나 여러 인스턴스를 한 번에 검색할 때 쓴다. 옛 env.AI.autorag("name") 코드는 이 인스턴스 바인딩으로 옮기는 것이 가장 짧은 길이다.
2026년 3월 23일부터 OpenAI 호환 REST API, 공개 엔드포인트, UI 스니펫, MCP가 들어왔다. 옛 AutoRAG API도 계속 동작하지만 새 기능은 새 API에만 있다. 계정 REST API로 검색을 호출하는 curl은 터미널에서 실행한다.
curl -X POST "https://api.cloudflare.com/client/v4/accounts/<ACCOUNT_ID>/ai-search/namespaces/default/instances/<INSTANCE_NAME>/search"같은 경로의 끝이 /chat/completions이면 답변 생성이다. 본문은 OpenAI 호환 messages 형식이다. 웹사이트를 소스로 인스턴스를 만드는 Wrangler 명령도 터미널에서 실행한다.
npx wrangler ai-search create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
  --parse-type discover
이 명령은 2026년 4월 1일에 들어온 wrangler ai-search 계열이다. 그 전에는 인스턴스 생성과 관리가 대시보드에 있었다. --parse-type discover는 사이트맵과 링크를 따라가며 페이지를 모은다.
가격과 한 달 비용 계산
2026년 8월 6일에 공개된 미리보기 단가와 정식 출시 단가는 같다. 달라진 것은 무료 질의의 나누기다. 미리보기는 두 종류를 합쳐 2,000회 공용이었고, 정식 출시는 시맨틱 1,000회와 전문 1,000회가 따로다.
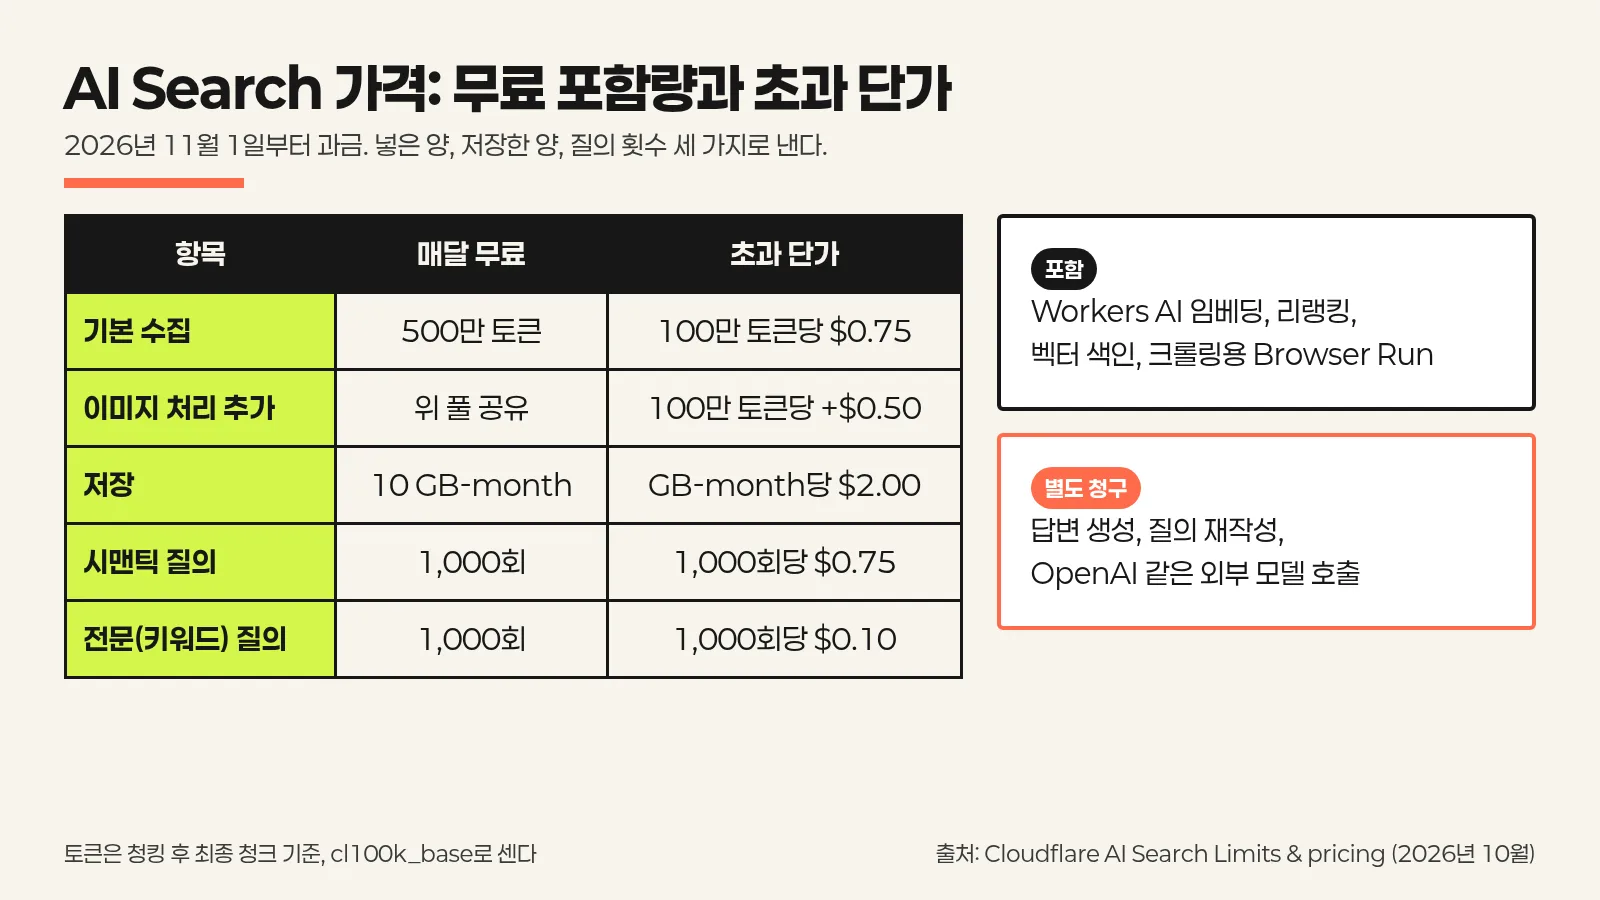
핵심 포인트: 청구되는 것은 넣은 콘텐츠, 저장한 데이터, 질의 세 가지다. 인스턴스 시간 요금, 용량 단위 요금, 월 최소 요금은 없다. 텍스트 임베딩을 멀티모달 임베딩으로 바꿔도 수집 단가는 같고, 이미지 처리 추가분만큼만 더해진다.
포함량을 넘는 단가는 아래와 같다. 계산에 빼는 무료분은 수집 500만 토큰, 저장 10 GB-month, 시맨틱 1,000회, 전문 1,000회다.
| 항목 | 초과 단가 |
|---|---|
| 기본 수집 | 100만 토큰당 $0.75 |
| 이미지 처리 추가 | 100만 토큰당 $0.50 |
| 저장 | GB-month당 $2.00 |
| 시맨틱, 벡터, 하이브리드 질의 | 1,000회당 $0.75 |
| 전문 키워드 질의 | 1,000회당 $0.10 |
토큰은 파싱과 청킹이 끝난 최종 청크를 센다. 겹친 구간은 그 구간이 들어 있는 청크마다 다시 센다. 세는 도구는 cl100k_base라서 tiktoken으로 미리 가늠할 수 있다. 임베딩 모델을 무엇으로 골라도 세는 법은 같다. 이미지와 OCR에서 뽑은 텍스트는 기본 수집 토큰과 이미지 처리 토큰에 둘 다 잡힌다. 이미지 처리 토큰도 500만 수집 무료 풀을 함께 쓴다. OCR은 모든 계정에서 쓸 수 있고, 청구 항목은 이미지 처리 수집 토큰이다.
포함과 별도 청구는 단가표와 다른 축이다. 검색 파이프라인 안의 임베딩과 리랭킹은 질의 단가에 이미 들어 있고, 문장을 생성하는 호출만 밖으로 나간다.
| 구분 | 무엇 | 어디로 청구되나 |
|---|---|---|
| 포함 | Workers AI 임베딩과 리랭킹, 저장, 벡터 색인, 웹 크롤용 Browser Run | AI Search 포함. Workers AI 청구서와 AI Gateway 로그에 안 나타남 |
| 별도 | 답변 생성, 질의 재작성, 외부 모델 제공자 호출 | Workers AI, 또는 AI Gateway와 외부 제공자 |
2026년 8월 6일 블로그의 공식 예시는 Workers Paid 계정이다. 문서 20,000개로 텍스트 약 2,000만 토큰, 이미지 1,000장으로 장당 약 1,000토큰, 월 시맨틱 질의 30,000회, 기본 임베딩과 리랭킹, 겹침 약 10%라서 수집량에 1.1을 곱한다. 저장 추정은 문서당 약 10 KB, 이미지당 1 MB로 약 1.2 GB이고, 10 GB 무료분 안이라 저장 요금은 $0이다.
기본 수집은 (20M + 1M) × 1.1 - 5M = 18.1M 토큰 × $0.75 = $13.58이다. 이미지 추가는 1M × 1.1 = 1.1M 토큰 × $0.50 = $0.55다. 당시 무료 질의가 2,000회 공용이었으므로 질의는 30,000 - 2,000 = 28,000 × $0.75/1k = $21.00이다. 첫 달 합계는 약 $35다. 색인은 대체로 한 번 드는 비용이라 블로그는 다음 달부터 질의 위주로 약 $21이라고 적었다.
같은 예시를 정식 출시의 시맨틱 무료 1,000회로 필자가 공식 단가만 다시 계산하면 질의가 달라진다. 30,000 - 1,000 = 29,000 × $0.75/1k = $21.75다. 첫 달은 $13.58 + $0.55 + $21.75 = $35.88이고, 다음 달부터는 약 $21.75다. 생성 모델 비용은 이 합계에 들어 있지 않다.
필자 예시 A는 개인 블로그와 문서 사이트다. 글 300편, 편당 약 1,500토큰이면 45만 토큰이고, 겹침 10%면 약 49.5만 토큰이라 500만 무료분 안이다. 저장도 수십 MB 수준이라 10 GB-month 안이다. 월 시맨틱 질의 3,000회면 (3,000 - 1,000) × $0.75/1k = $1.50/월이다.
필자 예시 C는 질의만 많은 서비스다. 월 시맨틱 질의 10만 회면 (100,000 - 1,000) × $0.75/1k = $74.25/월이다. 같은 횟수를 전문 질의로만 하면 (100,000 - 1,000) × $0.10/1k = $9.90/월이다. 시맨틱과 전문의 단가 차이가 이 규모의 월 비용을 가른다.
예시 B는 스캔 PDF를 OCR로 넣는 경우다. 추출 텍스트 400만 토큰이면 기본 수집 400만과 이미지 처리 400만이 같이 잡히고, 둘은 500만 무료 풀을 공유한다. 합계 800만 가운데 500만을 무료로 보면 300만이 남는데, 그 300만을 기본 수집과 이미지 처리 중 어디에 먼저 적용하는지는 공식 문서에 설명이 없다. 무료분을 빼기 전 식은 4M × $0.75 + 4M × $0.50 = $5.00이다. 실제 청구는 여기서 무료분을 뺀 금액이라 최대 약 $5 이하다.
답을 Workers AI로 만들면 질의 단가와 별도로 Neurons 요금이 난다. 1,000 Neurons당 $0.011이고, 하루 10,000 Neurons는 무료다. 하루 10,000 Neurons를 넘기려면 Workers Paid 플랜이 필요하다. @cf/meta/llama-3.1-8b-instruct-fp8-fast는 입력 100만 토큰당 $0.045, 출력 100만 토큰당 $0.384다.
R2를 데이터 소스로 연결하면 원본 파일은 사용자 R2 버킷에 있다. R2 Standard 저장은 GB-month당 $0.015, 월 10 GB-month 무료, 인터넷 전송은 무료다. AI Search 쪽 저장 요금과 이 버킷 요금이 둘 다 붙는지는 공식 문서에 설명이 없다. 문서는 저장, 벡터 색인, 웹 크롤용 Browser Run이 AI Search에 포함된다고만 적는다. 예전에 웹사이트를 크롤한 인스턴스는 계정에 R2 버킷을 따로 만들었고 지금은 그 방식을 쓰지 않는다. 남은 객체는 R2 저장 요금에 잡힐 수 있으니 필요 없으면 지워도 된다.
Workers Free 계정이 무료 포함량을 넘겼을 때 과금되는지, 사용이 막히는지에 대한 문장은 공식 문서에 없다. 한도 표는 Free와 Paid를 나누고, 포함량은 모든 계정이라고 적는다.
작동 원리
색인은 비동기로 여섯 단계를 지난다. 1) 연결된 소스에서 읽거나 Items API 업로드를 받는다. 2) Workers AI의 Markdown 변환(toMarkdown)으로 지원 형식을 Markdown으로 바꾼다. 텍스트 전용 모델이면 이 단계에서 이미지를 캡션으로 만든다. 3) 재귀 청킹으로 자른다. 문단에서 문장 경계로 내리고, 여전히 크면 다시 자른다. 청크 크기는 토큰 수이고 모델마다 범위가 다르며, 겹침은 0~30%다. 4) 청크를 벡터로 임베딩한다. 멀티모달 모델은 이미지 픽셀을 직접 넣는다. 5) 키워드 검색을 켜 두면 BM25용 역색인을 만든다. 6) 벡터, 키워드 색인, 콘텐츠를 저장한다.
질의는 동기로 아홉 단계다. 1) Search 또는 Chat Completions 요청을 받는다. 2) 선택인 질의 재작성에서 LLM이 검색어를 다듬는다. 3) 질의를 임베딩한다. 4) 벡터를 검색한다. 5) 키워드를 BM25로 검색한다. 하이브리드면 벡터 검색과 같이 돈다. 6) 융합한다. 기본은 RRF이고 max도 있다. 7) 선택인 리랭킹에서 크로스 인코더가 질의와 청크를 함께 보고 점수를 다시 매긴다. 기본은 꺼져 있고, 기본 모델은 @cf/baai/bge-reranker-base(512토큰)다. 8) 청크를 반환한다. Search 엔드포인트는 여기서 끝난다. 9) Chat Completions일 때만 답을 생성한다.
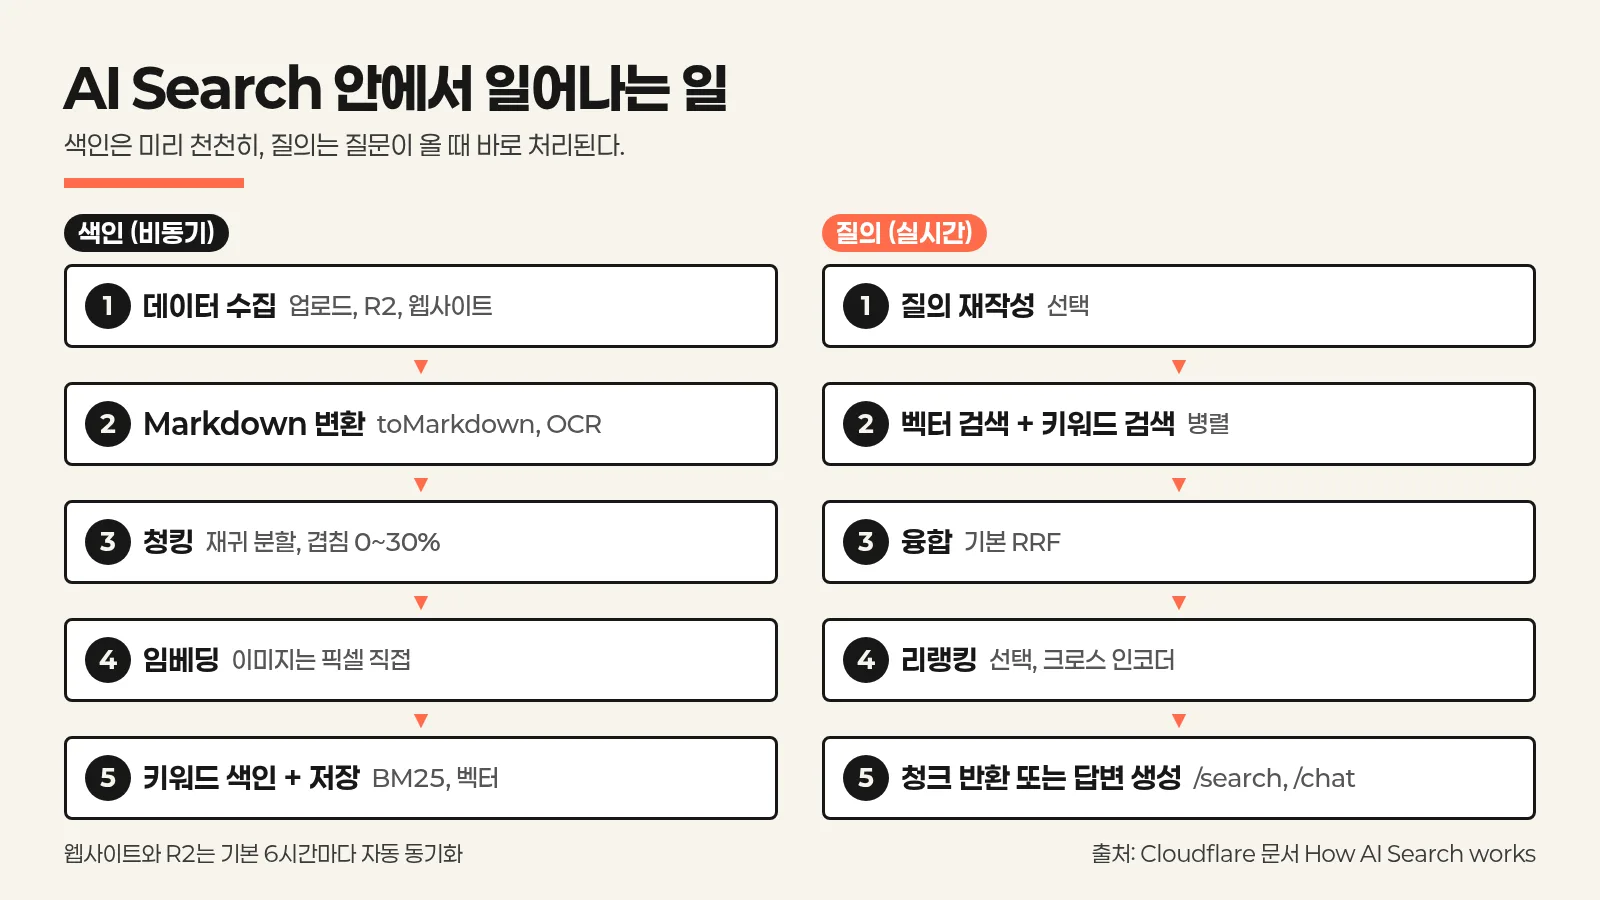
새 인스턴스의 기본 검색은 하이브리드다. 모드는 vector, keyword, hybrid 세 가지다. ERR_CONNECTION_REFUSED timeout처럼 글자가 그대로 있는 오류 문자열은 키워드가 잘 잡는다. 배포 가이드와 앱 출시 방법처럼 말이 다르고 뜻이 같은 질의는 벡터가 잘 잡는다. 하이브리드는 둘을 같이 한 뒤 순위를 합친다.
기본 융합은 RRF(Reciprocal Rank Fusion)다. 벡터가 매긴 순위와 키워드가 매긴 순위를 하나의 순서로 합친다. 다른 선택인 max는 두 점수 중 큰 쪽을 쓴다. 리랭킹을 켜면 그 합쳐진 후보를 크로스 인코더가 다시 줄 세운다. 리랭킹 호출 비용은 AI Search 포함 항목이다.
질의 재작성은 기본으로 꺼져 있고 messages 형식에서만 동작한다. 첫 메시지는 그대로 쓰고, 이어진 질문을 대화 맥락으로 다시 쓴다. How do I deploy one?이 deploy Cloudflare Worker getting started로 바뀌는 식이다. 이 단계는 생성 모델 요금이 따로 난다.
비슷한 질문의 답은 유사도 캐시가 재사용한다. 방식은 MinHash와 LSH다. 유지 시간 cache_ttl은 10분에서 6일이고 기본은 48시간이다. 청크가 바뀌면 캐시를 비운다. 관련도 부스팅은 타임스탬프나 우선순위 같은 메타데이터로 결과에 가중을 주며, 필드는 최대 3개다.
이 기본값의 많은 부분이 2026년 4월 16일에 들어왔다. 그날 하이브리드 검색, 관련도 부스팅, 다중 인스턴스 검색, 내장 스토리지, 내장 벡터 인덱스, 새 Workers 바인딩이 추가됐다. 4월 16일 이전에 만든 인스턴스는 2026년 6월 3일부터 6월 18일까지 관리형 인프라로 옮겨졌다.
웹사이트와 R2는 예약 동기화로 새 파일, 수정, 삭제를 반영한다. 기본 주기는 6시간이고, 15분, 30분, 1시간, 2시간, 4시간, 6시간, 12시간, 24시간 중에서 고른다. Wrangler나 REST API로 CMS 웹훅과 CI에서 수동 동기화도 된다. 내장 스토리지에 직접 올린 파일은 이 주기를 기다리지 않고 바로 색인된다.
직접 만드는 RAG와 무엇이 다른가
직접 만드는 RAG는 파서, 청킹, 임베딩 API, 벡터 데이터베이스, 키워드 색인, 크롤러, 삭제 처리, 에이전트용 서버를 각각 붙인다. AI Search는 그 연쇄를 인스턴스 하나로 묶고, 조절 가능한 범위를 청크 크기, 겹침, 모델 목록 안으로 제한한다. AI Search는 Vectorize 위에 만들어져 있다. Vectorize는 직접 만든 벡터를 넣는 벡터 데이터베이스다. 파이프라인 전체를 제어하려면 Vectorize이고, 검색과 RAG를 빨리 붙이려면 AI Search다.
| 단계 | 직접 구축 | AI Search |
|---|---|---|
| 파일 파싱 | PDF와 Office 파서를 직접 붙임 | toMarkdown 자동, OCR은 옵션 |
| 청킹 | 직접 구현 | 재귀 청킹, 크기와 겹침만 조절 |
| 임베딩 | 모델 API를 호출하고 비용을 냄 | Workers AI 모델 비용이 포함 |
| 벡터 DB | Pinecone, pgvector 등을 직접 운영 | 내장 Vectorize |
| 키워드와 하이브리드 | BM25와 융합 코드를 따로 둠 | 기본 하이브리드, RRF |
| 리랭킹 | 리랭커를 직접 호출 | 옵션 한 줄, 비용 포함 |
| 질의 재작성 | 프롬프트를 직접 만듦 | 옵션, 생성 요금은 별도 |
| 지속 색인 | 크론, 웹훅, 삭제를 직접 처리 | 기본 6시간 자동 동기화, 새 파일과 수정과 삭제 반영 |
| 크롤링 | 크롤러를 직접 운영 | 웹사이트 소스, Browser Run 포함 |
| 에이전트 노출 | MCP 서버를 직접 만듦 | /mcp 엔드포인트 내장 |
| 제어권 | 전부 직접 | 청크 전략과 모델 범위는 제한 |
청크 전략을 문서에 없는 방식으로 바꾸거나, 임베딩 차원을 목록 밖으로 가져가야 하면 표의 왼쪽이 맞다. 파일만 넣고 하이브리드 검색과 답변, MCP까지 한 세트로 쓰려면 오른쪽이 맞다. 왼쪽을 골라도 Vectorize를 벡터 저장으로 쓸 수 있고, 그때는 청킹과 임베딩 호출을 직접 돌린다.
멀티모달: 이미지와 스캔 PDF
정식 출시에서 이미지 픽셀을 직접 임베딩하는 경로가 추가됐다. 예전에는 객체 감지 다음 캡션 생성, 그 다음 텍스트 임베딩이었다. 캡션에 적힌 내용만 찾을 수 있었다. 지금은 픽셀 임베딩과 캡션 이해를 같이 한다. 작은 벡터에도 정보를 남기려고 MRL(Matryoshka Representation Learning)로 저장량과 속도를 관리한다.
인스턴스의 임베딩 모델이 이미지를 지원하면, 질의 이미지도 같은 벡터 공간에 넣어 찾는다. 텍스트 전용 모델이면 ToMarkdown이 이미지를 캡션으로 바꾼 뒤 검색한다. 그래서 텍스트 전용 모델을 골라도 기본적인 그림 검색은 된다. 찾을 수 있는 방식은 원하는 장면을 글로 설명하기, 비슷한 그림을 넣어 찾기, 둘을 섞기다. 상품, 스크린샷, 차트, 다이어그램, 스캔 문서에 맞다.
| 모델 | 차원 | 입력 한도 | 이미지 |
|---|---|---|---|
| @cf/qwen/qwen3-embedding-0.6b | 1,024 | 8,192토큰 | 텍스트 기본 모델 |
| @cf/qwen/qwen3-vl-embedding-2b | 1,024 | 32,768토큰 | 지원 |
| @cf/baai/bge-m3 | 1,024 | 512토큰 | 텍스트 |
| google-ai-studio/gemini-embedding-2 | 1,536 | 8,192토큰 | 지원 |
기본 텍스트 임베딩은 @cf/qwen/qwen3-embedding-0.6b다. 그 밖에 @cf/baai/bge-large-en-v1.5, @cf/google/embeddinggemma-300m(768차원), openai/text-embedding-3-small, openai/text-embedding-3-large(1,536차원), google-ai-studio/gemini-embedding-001이 있다. 거리 계산은 모두 cosine이다. Smart Default를 고르면 Cloudflare 추천 모델을 자동으로 고르고 자동으로 갱신한다. 임베딩 모델은 인스턴스를 만들 때만 바꿀 수 있다. 다른 임베딩으로 바꾸려면 새 인스턴스다. 생성 모델은 나중에 설정에서 바꿀 수 있고 요청마다 덮어쓸 수도 있다.
지원 형식은 세 묶음이다. 리치 포맷의 그림 변환은 Workers AI 모델 두 개, 객체 감지와 요약을 쓴다. 이미지 섹션의 형식은 멀티모달 임베딩 대상이다.
| 묶음 | 형식 |
|---|---|
| 일반 텍스트 | txt, md, mdx, json, yaml, 소스 코드, 설정 파일 등. 목록에 rst, log, ini, toml, tex, sql, css도 있다 |
| 리치 포맷 | PDF, HTML, XML, docx, xlsx 등 Office, ODF, CSV, numbers, 그리고 jpeg, png, webp, svg, gif, bmp |
| 이미지 임베딩 | jpg, jpeg, png, webp, gif, bmp, tif, tiff, heic, heif |
.pptx와 .hwp는 지원 목록에 없다. 동영상과 오디오도 목록에 없다. 동영상과 오디오 처리 파이프라인은 만드는 중이고, 출시일은 공개되지 않았다.
이미지 질의는 REST API와 공개 엔드포인트에서 보낼 수 있다. Workers 바인딩의 messages content는 문자열만 받는다. 이미지와 파일 파트는 REST API나 공개 엔드포인트로 보낸다.
무엇과 연결되나
데이터 소스는 세 가지다. 내장 스토리지는 모든 인스턴스에 기본으로 있고 R2와 Vectorize 위에 있다. 웹사이트는 같은 계정에 온보딩된 도메인만 크롤한다. R2는 내 버킷을 소스로 연결한다. 내장 스토리지와 외부 소스 하나를 함께 쓸 수 있다.
웹사이트의 파싱 기본은 Sitemap이다. Discover는 사이트맵과 링크를 따라간다. 경로 필터는 전체 URL 기준이고 /blog/ 형태다. 특정 사이트맵은 최대 5개, 인증 헤더는 최대 5개다. 렌더링은 원본 HTML 또는 헤드리스 브라우저다. CSS 선택자로 본문만 뽑을 수 있고, HTML meta 태그로 커스텀 메타데이터를 붙일 수 있다. 크롤된 페이지는 내장 스토리지에 저장된다. Browser Run이 이 크롤을 맡으며, discover는 /crawl 기반이다. 예전 제품 이름은 Browser Rendering이다.
R2를 대시보드나 Wrangler로 연결하면 서비스 API 토큰이 자동으로 만들어져 등록된다. 지원하지 않거나 너무 큰 객체는 건너뛰고 오류 로그에 남는다.
| 연결 | 하는 일 |
|---|---|
| R2 | 내장 스토리지의 바탕, 또는 내 버킷을 데이터 소스로 연결 |
| Vectorize | 내장 벡터 인덱스의 바탕 |
| Workers AI | Markdown 변환, 임베딩, 리랭킹, 답변 생성, 질의 재작성 |
| Browser Run | 웹사이트 크롤 |
| AI Gateway | 생성, 재작성, 외부 모델 호출의 통로. 로그와 가드레일 |
| MCP | 공개 엔드포인트 /mcp, search 도구 |
| NLWeb | 웹사이트 소스와 Worker 자동 배포. /ask와 /mcp. 공개 미리보기 |
| UI 스니펫 | 검색창, 검색 모달, 채팅 버블, 채팅 페이지 |
| 프레임워크 | Agents SDK, Vercel AI SDK, LangChain, Python SDK |
| Access, 커스텀 도메인 | 공개 주소를 내 도메인으로 열고 로그인을 요구 |
| EmDash | Cloudflare 오픈소스 CMS용 플러그인 |
모든 인스턴스는 AI Gateway에 연결된다. 질의 재작성, 답변 생성, 외부 제공자의 임베딩과 리랭킹이 게이트웨이를 지나고, 요청 수, 토큰, 비용, 지연, 오류가 남는다. 로그에는 실제 시스템 프롬프트, 재작성된 질의, 생성된 답도 있다. Guardrails로 유해 콘텐츠를 막고, DLP로 개인정보와 금융정보를 다루며, 재시도와 모델 폴백을 쓸 수 있다.
핵심 포인트: 연결된 AI Gateway의 캐시가 켜져 있으면 캐시된 임베딩이 잘못된 벡터를 저장하거나 반환해 정확도가 조용히 떨어진다. 게이트웨이 레이트 리밋도 AI Search 자신의 호출에 걸린다. 비슷한 질의의 재사용은 AI Search 쪽 유사도 캐시가 담당한다.
외부 모델은 2025년 9월 25일부터 AI Gateway를 통해 붙일 수 있다. 제공자 키를 게이트웨이에 BYOK로 등록하고, 그 게이트웨이를 AI Search에 연결한 뒤 모델을 고른다. chat completions 호환 제공자면 OpenAI와 Anthropic 밖에도 쓸 수 있다. Workers AI 프로덕션 생성 모델의 일부와 컨텍스트 토큰은 아래와 같다.
| 모델 | 컨텍스트 토큰 |
|---|---|
| @cf/meta/llama-3.3-70b-instruct-fp8-fast | 24,000 |
| @cf/meta/llama-3.1-8b-instruct-fast | 60,000 |
| @cf/meta/llama-4-scout-17b-16e-instruct | 131,000 |
| @cf/openai/gpt-oss-120b | 128,000 |
| @cf/openai/gpt-oss-20b | 128,000 |
| @cf/qwen/qwen3.8-27b | 262,144 |
| @cf/moonshotai/kimi-k2.7-code | 262,144 |
| @cf/deepseek-ai/deepseek-v4-flash-0731 | 1,048,576 |
| @cf/deepseek-ai/deepseek-v4-pro-0813 | 1,048,576 |
| @cf/zai-org/glm-5.3 | 1,310,720 |
목록은 일부다. 생성 모델은 설정에서 언제든 바꿀 수 있다.
공개 엔드포인트는 세 개다. /search는 청크를 돌려주고, /chat/completions는 OpenAI 호환 답변이고, /mcp는 에이전트용이다. 주소는 https://<PUBLIC_ENDPOINT_ID>.search.ai.cloudflare.com/search 형태다. 네임스페이스는 ns- 접두사가 붙는다. ID는 처음 켤 때 만들어지고 그 뒤로는 바뀌지 않는다. 인증 없이 열린다. 레이트 리밋 기본은 1분당 120회이고 방식은 fixed다. CORS 기본은 웹사이트 소스일 때 그 도메인만, 다른 소스일 때 모든 출처다. 출처를 제한하는 설정 이름은 Authorized hosts다.
MCP를 붙이는 경로는 인스턴스 Settings에서 Public Endpoint를 켜고 URL을 복사한 뒤, MCP 클라이언트에 https://<ID>.search.ai.cloudflare.com/mcp를 등록하는 것이다. 테스트 요청에는 Accept 헤더로 application/json과 text/event-stream이 둘 다 필요하다. Access를 걸 때는 default_domain_enabled를 false로 해야 기본 호스트가 인증 없이 응답하지 않는다. 커스텀 도메인을 쓰면 search.example.com 같은 주소로 바꿀 수 있다.
UI를 붙일 때는 공개 엔드포인트가 제공하는 스크립트를 HTML에 넣는다.
<script
	type="module"
	src="https://<PUBLIC_ENDPOINT_ID>.search.ai.cloudflare.com/assets/v0.0.25/search-snippet.es.js"
></script>
그 다음에 <search-bar-snippet>, <search-modal-snippet>, <chat-bubble-snippet>, <chat-page-snippet>를 둔다. 검색 모달은 Cmd 또는 Ctrl+K로 연다. 각 컴포넌트에는 공개 엔드포인트 URL을 api-url로 준다. 스니펫 구현은 오픈소스 github.com/cloudflare/ai-search-snippet에 있다.
코드에서 부를 때는 Cloudflare Agents SDK, Vercel AI SDK의 ai-search-provider, LangChain의 langchain-cloudflare 안에 있는 CloudflareAISearchRetriever, Python SDK가 있다. NLWeb은 웹사이트 소스와 함께 NLWeb Worker를 자동 배포하고 /ask와 /mcp를 연다. 상태는 공개 미리보기다. EmDash는 Cloudflare 오픈소스 CMS에 AI Search를 붙이는 플러그인이다.
네임스페이스는 인스턴스 묶음이다. 한 번에 최대 10개 인스턴스를 가로질러 검색할 수 있고, 결과에는 어느 인스턴스에서 나왔는지가 붙는다.
왜 알아야 하고 언제 쓰나
알아 둘 이유는 RAG를 붙이는 데 드는 일의 양이 크게 줄기 때문이다. 직접 만들면 파서, 청킹 코드, 임베딩 API, 벡터 DB, 키워드 색인, 리랭커, 크롤러, 동기화 크론, MCP 서버를 따로 붙이고 각각 요금과 장애를 관리한다. AI Search는 이 묶음을 인스턴스 하나로 대신하고, 임베딩과 리랭킹과 크롤 브라우저 비용을 요금 안에 넣었다. 작은 사이트는 매달 무료 포함량 안에서 끝나고, 2026년 11월 1일 과금이 시작된 뒤에도 질의 1,000회까지는 시맨틱 검색 요금이 나오지 않는다.
바이브 코더에게 특히 맞는 이유는 결과물을 에이전트가 바로 쓸 수 있다는 점이다. 인스턴스마다 /mcp 엔드포인트가 있어 커서 같은 코딩 도구에 내 문서를 검색 도구로 물릴 수 있고, Wrangler 명령은 --json 출력을 지원해 AI 에이전트가 인스턴스를 만들고 결과를 읽기 쉽다. 한국어 문서도 trigram 토크나이저로 키워드 검색이 맞는다.
블로그와 문서 사이트에는 웹사이트 소스를 연결하고 검색창이나 채팅 버블을 붙이는 경로가 있다. 색인과 동기화는 AI Search가 맡고, 페이지에는 스니펫 컴포넌트만 둔다. 코딩 에이전트에는 공개 /mcp를 등록해 내 문서를 search 도구로 물린다. 열린 주소에는 Cloudflare Access로 로그인을 요구할 수 있다.
고객마다 파일이 다른 서비스는 두 가지로 가른다. 테넌트마다 인스턴스를 만들거나, 인스턴스 하나를 공유하고 메타데이터 필터로 고객을 나눈다. 검색은 AI Search에 두고 답변만 OpenAI 같은 외부 모델로 만드는 구성도 공식 how-to에 있다. 음성 에이전트의 지식베이스로 쓰는 절차, 사람이 승인한 변경만 지식베이스에 반영하는 절차도 how-to로 나와 있다.
Cloudflare 자신의 Dev Stack MCP는 Docs, Blog, API Docs, Community, Astro, Vite, Vitest, Hono, Replicate, OpenNext를 네임스페이스 하나로 묶어 검색한다. 문서 묶음이 여러 사이트에 흩어져 있을 때의 형태다.
청크를 문서에 없는 규칙으로 자르거나, 목록에 없는 임베딩을 고정해야 하면 Vectorize에 벡터를 직접 넣는다. 파일과 사이트를 넣고 하이브리드 검색, 재색인, MCP까지 한 세트로 가져가면 AI Search를 쓴다.
한계와 주의할 점
범위, 플랜 한도, 공개 주소, 설정을 바꾼 뒤의 재색인이 서로 다른 종류의 제약이다. 크롤 대상은 같은 계정의 도메인이다. Bot Management, WAF, Turnstile 규칙은 AI Search 크롤러에도 적용되므로 예외가 필요하다. User-Agent는 Cloudflare-AI-Search다.
| 항목 | Free | Paid |
|---|---|---|
| 계정당 인스턴스 | 100 | 5,000 |
| 계정당 네임스페이스 | 100 | 100 |
| 인스턴스당 파일 | 100,000 | 100만 (하이브리드면 50만) |
| discover 크롤 1회 페이지 | 100,000 | 100,000 |
| 하루 최대 크롤 페이지 | 500 | 무제한 |
| 한 번의 다중 인스턴스 검색 | 10개 | 10개 |
| 커스텀 메타데이터 필드 | 인스턴스당 5개 | 5개 |
| 벡터당 메타데이터 | 10 KiB | 10 KiB |
| 필터 가능한 문자열 | 앞 64 UTF-8 바이트 | 같음 |
하이브리드를 켜면 Paid의 파일 상한이 100만에서 50만으로 줄어든다. discover 한 번의 페이지 상한 10만은 Free와 Paid가 같다. 커스텀 메타데이터는 R2 커스텀 헤더나 HTML meta 태그로 붙인다. 필터에 쓰는 문자열은 앞 64 UTF-8 바이트만 본다.
토크나이저, index_method, OCR을 바꾸면 전체를 다시 색인하고 수집 토큰이 다시 나간다.
31일 동안 검색 요청이 없으면 예약 동기화가 일시정지된다. 이미 색인된 자료의 검색은 계속되고, 트래픽이 다시 오면 동기화가 자동으로 재개된다. 개발 머신에서는 AI Search 프로세스가 뜨지 않아서, 로컬 시험은 배포된 인스턴스로 요청을 넘긴다. 공개 엔드포인트를 인증 없이 켜 두면 주소만 알면 검색을 호출할 수 있다.
다른 서비스와 비교
같은 일을 하는 관리형 검색도 돈을 매기는 단위가 다르다. 토큰, 질의 횟수, 도구 호출, GB-일이 섞여 있어 사용 패턴이 바뀌면 총액도 바뀐다. 아래 표는 각 가격 페이지의 단가 단위를 모은 것이다. Google 쪽 페이지 제목은 Agent Search pricing이다. 일본어 SEO 글은 Agent Search를 옛 Vertex AI Search라고 부른다. 그 이름 변경의 공식 날짜는 공개되지 않았다.
| 서비스 | 과금의 중심 | 포함되는 양 |
|---|---|---|
| AI Search | 수집 100만 토큰 $0.75, 이미지 추가 100만 토큰 $0.50, 저장 GB-month $2.00, 시맨틱 1,000회 $0.75, 전문 1,000회 $0.10 | 수집 500만 토큰, 저장 10 GB-month, 시맨틱 1,000회, 전문 1,000회 |
| OpenAI file search | 저장 1 GB 초과분 GB당 하루 $0.10, 도구 호출 1,000회당 $2.50, 검색 결과는 모델 입력 토큰으로 별도 | 저장 1 GB |
| Google Agent Search | Standard 1,000질의당 $1.50, Enterprise 1,000질의당 $4.00, 고급 생성 답변 +$4.00, 색인 저장 GiB당 시간당 $0.006849315 (월 약 $5/GiB 수준) | 월 10,000질의, 저장 10 GiB |
| Pinecone Assistant | 저장 GB당 월 $3, 수집 단위(약 400토큰)당 $0.0005, 멀티모달 수집 $0.001, 컨텍스트 100만 토큰당 $5, 채팅 입력 100만당 $8, 출력 100만당 $15 | Starter는 월 입력 50만, 출력 30만, 컨텍스트 50만 토큰, 수집 1,000단위, 저장 1 GB |
| 직접 구축 | 벡터 DB, 임베딩, 크롤러 등 구성 요금에 개발과 운영 시간이 더해짐 | 구성마다 다름 |
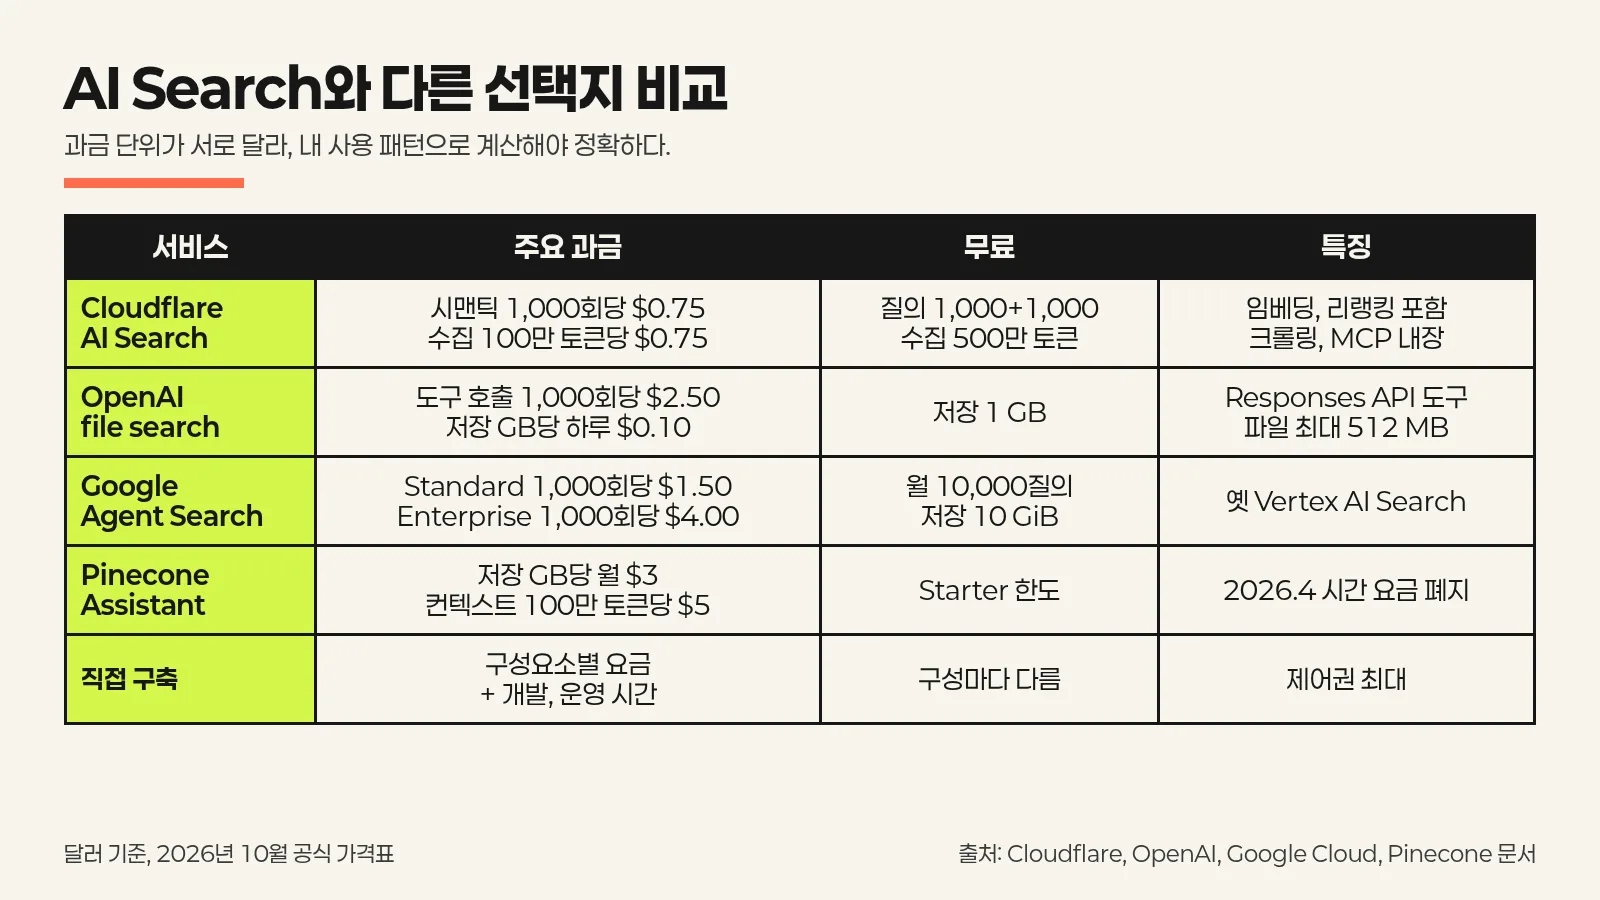
OpenAI file search의 파일 한도는 최대 512 MB, 파일당 500만 토큰이다. Pinecone Assistant는 2026년 4월 1일에 어시스턴트당 시간 요금 $0.05를 없앴다. AI Search에는 인스턴스 시간 요금이 없다.
직접 구축은 각 부품의 무료 구간을 따로 맞춘다. AI Search는 수집, 저장, 질의를 한 청구로 보고, 임베딩과 리랭킹과 크롤 브라우저를 그 안에 넣는다. 총액은 질의 횟수, 파일 크기, 답을 만드는 모델에 따라 달라진다.
X 반응
출시 전후의 글은 붙였다는 기록과, 설정에서 돈이 다시 든다는 지적이 같이 있다. 2026년 9월 30일 @i_kushagra는 자기 서비스에 AI Search를 연결했다고 적으면서, 아직 베타라 몇 가지 문제가 있지만 비슷한 SaaS를 많이 대체할 것이라고 보았다. 2026년 10월 5일 @superframeworks는 인프라를 따로 두지 않는 하이브리드 검색, Workers AI 임베딩이 포함되는 점, 공개 /search와 /mcp를 짚었다. 2026년 10월 1일 @PeymanCyber는 시각 검색과 스캔 PDF OCR을 정식 출시의 멀티모달로 보았다. 2026년 8월 8일 @alexasomba는 직접 만들던 임베딩과 리랭크 스택을 걷어냈다고 적었다.
설정 쪽 글은 색인 전에 정할 값을 반복해서 짚는다. 2026년 10월 4일 @itsmeasadali는 OCR이 기본으로 꺼져 있고, 나중에 켜면 전체 재색인과 추가 비용이 들며, 큰 파일은 색인되지 않아 오류 로그를 봐야 한다고 적었다. 2026년 10월 16일 @Hans7b는 한중일 문서라면 keyword_tokenizer를 trigram으로 두고 재색인을 예상해야 한다고 적었다. 2026년 10월 2일 @SupersocksIntel는 11월 1일부터 미리보기 사용량이 청구서로 바뀐다고 알렸다. 같은 날 @jakemcgraw는 사진 OCR을 Tesseract.js, Cloudflare AI Search, Apple Vision에 나란히 시험했다고 적었다.
회의와 이름 혼동도 있다. 2026년 10월 18일 @noisegm는 AWS S3 Vectors, Cloudflare AI Search, 로컬 postgres가 이미 있다며 새 RAG 스타트업에 회의적이었다. 2026년 9월 7일 @makodama는 일본어로, AI Search와 AI Gateway의 이름이 비슷해 역할이 헷갈린다고 적었다. 2026년 4월 1일 @ashleypeacock는 생성과 관리가 Wrangler로도 가능해졌다고 적었다. 그 전에는 대시보드뿐이었다.
마무리
앞에서 다룬 Cloudflare AI Search의 핵심만 짧게 정리한다.
- 2026년 10월 1일이 정식 출시이고, 사용량 과금은 2026년 11월 1일에 시작된다.
- 매달 수집 500만 토큰, 저장 10 GB-month, 시맨틱 1,000회, 전문 1,000회가 포함된다.
- 새 인스턴스의 기본 검색은 의미와 키워드를 같이 보는 하이브리드다.
- 한국어 키워드 검색은 trigram 토크나이저가 맞고, 나중에 바꾸면 전체 재색인이다.
- 이미지 픽셀 임베딩과 스캔 PDF OCR은 정식 출시에 들어왔다.
- 공개 엔드포인트는 인증이 없고, 답변 생성은 포함량 밖에서 청구된다.
「색인과 검색의 운영은 AI Search에 두고, 답변 모델과 공개 범위는 따로 고른다.」
질의가 매달 1,000회를 넘지 않는 문서 사이트는 검색 요금이 포함량 안에 머무른다. 색인 비용은 문서를 처음 넣을 때와, 토크나이저나 OCR을 바꿔 다시 색인할 때 주로 생긴다.
출처와 링크
가격, 한도, 동작, 모델, 연동은 아래 공식 문서를 따른다. 비교 대상의 가격은 각 사 가격 페이지를 따른다. 문서는 2026년 10월 21일까지 공개된 것이다.
- AI Search 개요
- 가격과 한도
- 정식 출시 블로그 (2026-10-01)
- 변경 기록
- 릴리스 노트
- 미리보기 가격 블로그 (2026-08-06)
- 이름 변경과 외부 모델 (2025-09-25)
- 작동 원리
- 키워드 검색과 토크나이저
- 지원 모델
- 대시보드로 시작
- Workers로 시작
- Workers 바인딩
- Workers 바인딩 이전
- REST API
- MCP
- 공개 엔드포인트
- 데이터 소스
- Workers AI 가격
- R2 가격
- OpenAI file search
- OpenAI API 가격
- Google Agent Search 가격
- Pinecone Assistant 가격
- Pinecone 2026 릴리스 노트
- how-to 목록
FAQ
자주 묻는 질문
AutoRAG와 Cloudflare AI Search는 같은 제품인가요?
같은 제품이다. 2025년 4월 7일 AutoRAG라는 이름으로 오픈 베타가 열렸고, 2025년 9월 25일 Cloudflare가 "AutoRAG is now AI Search"라며 이름을 바꿨다. 옛 REST API와 env.AI.autorag() 바인딩은 계속 동작하지만 새 기능은 새 API와 새 바인딩에만 들어간다.
새 Workers 바인딩을 쓰려면 패키지 버전이 어디까지 올라가야 하는가?
새 바인딩의 최소 버전은 @cloudflare/workers-types 4.20260304.0과 wrangler 4.68.1이다. 옛 응답 필드는 data 배열이었고, 새 응답은 chunks 배열이다. 그 버전보다 낮으면 새 바인딩 타입과 새 기능이 빠진다.
크롤러 User-Agent가 바뀐 뒤 robots.txt는 어떻게 되나?
2026년 2월 9일에 User-Agent가 Cloudflare-AutoRAG에서 Cloudflare-AI-Search로 바뀌었다. robots.txt는 옛 이름도 계속 인식한다. Bot Detection ID는 122933950으로 유지된다.
유사도 캐시에 걸렸는지는 응답 어디에서 구분하는가?
캐시 적중은 응답 헤더 cf-aig-cache-status로 구분한다. 값은 HIT 또는 MISS다. 이 유지 시간은 예전에 30일로 고정되어 있었다.
한 번의 검색이 돌려주는 결과 수 상한은 얼마인가?
한 번 검색의 최대 결과 수는 50이고 기본값은 10이다. 2025년 8월 20일에 상한이 20에서 50으로 늘었다. 호출에서는 max_num_results로 1에서 50 사이를 지정한다.
이미지와 파일을 질의 본문에 넣으려면 어떤 파트를 쓰는가?
REST와 공개 엔드포인트의 content 배열은 text, image_url, file 파트를 가질 수 있다. image_url은 https 주소이거나 data:image base64다. file은 data URI이고, 디코딩한 뒤의 크기는 10 MiB를 넘지 않는다.
동기화 주기를 API로 줄 때 허용되는 초 범위는 얼마인가?
API의 동기화 간격은 초 단위이며 900초에서 86400초까지다. 900초는 15분이고 86400초는 24시간이다. 웹훅이나 CI에서 수동으로 돌릴 때는 최대 30초에 한 번이다.
확장자가 없는 R2 객체는 왜 색인에서 빠질 수 있는가?
확장자가 없는 R2 객체는 Content-Type 메타데이터가 있어야 형식을 판별한다. REST API나 Workers 바인딩으로 버킷을 연결할 때는 토큰을 직접 만들어 token_id를 넘긴다.
검색 점수의 기본 임계값과 주변 청크는 어떻게 설정되어 있는가?
match_threshold의 기본값은 0.4이고 범위는 0에서 1이다. context_expansion은 주변 청크를 0개에서 3개까지 붙인다. keyword_match_mode의 기본은 and이고, or를 고르면 질의 단어 중 하나만 맞아도 된다.
청크 크기의 공통 기본값과 한국어 임베딩 점수는 공개되어 있는가?
모든 모델에 공통인 기본 청크 크기 숫자는 공식 문서에 없다. 기본 임베딩 모델의 한국어 검색 품질을 수치로 밝힌 공식 벤치마크도 공개되지 않았다.
용어
관련 용어
Google DeepMind가 개발한 멀티모달 AI 모델 시리즈로, 텍스트·이미지·오디오·비디오·코드를 통합적으로 처리할 수 있는 것이 가장 큰 차별점이다. 다른 모델이 주로 텍스트 기반으로 동작하는 반면, Gemini는 스크린샷을 보고 UI 코드를 생성하거나, 다이어그램을 이해하고 관련 코드를 작성하는 등 시각적 입력을 코딩에 활용할 수 있다. Gemini 2.0 Flash(빠르고 저렴), Gemini Pro(고성능) 등 다양한 변형이 있으며, 용도에 따라 선택할 수 있다. Gemini Code Assist(IDE 기반 코딩 도구)와 Gemini CLI(터미널 에이전트)를 통해 코딩을 지원하며, Google Cloud 생태계(Cloud Functions, Firebase, BigQuery, Vertex AI 등)와 긴밀하게 통합되어 있어 Google Cloud 사용자에게 특히 유리하다. Google의 방대한 데이터와 인프라를 기반으로 하므로, 정보 검색 능력(Grounding with Google Search)이 뛰어나 최신 라이브러리나 API 정보를 반영한 코드 생성에 강점이 있다.
컨텍스트 엔지니어링 근거 기반 생성LLM의 출력을 실제 사실에 기반한 신뢰할 수 있는 정보 소스에 연결(anchor)하여 환각(Hallucination)을 줄이는 기법의 총칭이다. '그라운딩(Grounding)'은 비행기가 '착륙(ground)'하듯, AI의 답변을 현실의 '근거(ground)'에 밀착시킨다는 의미이다. 코딩 맥락에서의 Grounding은 AI가 코드를 생성할 때 공식 라이브러리 문서, 실제 API 스키마, 검증된 코드 예시 등 신뢰할 수 있는 출처를 참조하여 실제로 존재하는 API와 메서드만 사용하도록 보장하는 것을 말한다. RAG(검색 증강 생성)가 Grounding을 구현하는 가장 대표적인 기술이며, 그 외에도 공식 문서를 컨텍스트에 직접 포함시키기, AI에게 '공식 문서를 확인하고 나서 코드를 작성해줘'라고 명시적으로 지시하기, 생성된 코드에서 사용한 API가 실제로 존재하는지 자동 검증하기 등의 방법이 있다. Google의 Gemini는 'Grounding with Google Search' 기능으로 웹 검색 결과를 자동으로 참조하는 내장 Grounding 메커니즘을 제공한다.
컨텍스트 엔지니어링 코드베이스 인덱싱AI 도구가 프로젝트의 전체 소스 코드를 분석·색인(index)하여, 특정 질문이나 작업 시 관련 코드를 빠르게 찾을 수 있도록 하는 사전 처리 과정이다. 도서관의 색인 카드가 원하는 책을 빠르게 찾게 해주는 것처럼, 코드베이스 인덱싱은 AI가 수만~수백만 줄의 코드에서 필요한 부분을 즉시 특정할 수 있게 한다. Windsurf는 프로젝트를 처음 열 때 전체 파일을 인덱싱하고, Augment Code는 심층 인덱싱(Deep Indexing)으로 코드 간 의존성과 아키텍처 패턴까지 분석한다. 인덱싱 깊이에 따라 AI 에이전트의 정확도가 크게 달라지며, 단순 텍스트 검색 수준의 인덱싱과 코드 의미론(semantics)까지 파악하는 심층 인덱싱은 결과물의 차이가 상당하다. Greptile 같은 코드베이스 인덱싱 전문 도구도 존재하며, 이들은 코드의 의미적 관계를 파악하여 '이 함수를 호출하는 모든 곳'이나 '이 데이터 구조를 사용하는 모든 패턴'을 찾아낸다. RAG의 코드 버전으로 이해할 수 있다.
링크
관련 링크
AI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
VIBE 코딩 보안 테이텀 시큐리티 Threads쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
관련 글
관련 글
Recommended
Cloudflare 커스텀 도메인 | 네임서버와 SSL Full Strict
도메인을 샀다고 바로 사이트가 열리지는 않는다. 도메인은 인터넷 주소록에 이름을 등록한 것이고, 그 이름으로 찾아온 방문자를 어느 서버로 보낼지는 DNS라는 안내 데스크가 정한다. 도메인을 판 회사(등록 기관, registrar)와 안내 데스크를 운영하는 곳(네임서버)은 서로 달라도 된다. Cloudflare에 커스텀 도메인을 붙인다는 말은 이 안내 데스크를 Cloudflare로 옮기거나, 하위 도메인 하나만 Cloudflare 쪽으로 연결한다는 뜻이다.
가장 흔한 방법은 풀 셋업(Full setup)이다. Cloudflare가 알려 주는 네임서버 두 개를 등록 기관 관리 화면에 넣고, 존이 Active가 되면 A, AAAA, CNAME, MX 같은 레코드를 Cloudflare DNS 화면에서 고친다. Free와 Pro 플랜의 기본 경로다.…
뮤즈 원더와 뮤즈 스파크 1.3 | 한국에서 커서, 오픈라우터로 쓰는 법, 가격, 벤치마크
Muse Spark 1.3과 Muse Wonder는 Meta가 만든 AI 언어 모델이다. 둘 다 질문과 자료를 받아 글로 답한다. 이미지를 그려 주거나 영상을 만들어 주는 모델이 아니다. 그림을 만드는 모델은 따로 있고, 이름은 Muse Image다.
쓰는 자리도 나뉜다. Spark 1.3은 코딩과 도구를 여러 단계로 쓰는 일을 낮은 비용으로 처리하는 중간급 모델이다. Wonder는 더 큰 프런티어 모델로, 긴 코딩과 컴퓨터 조작, 개인과 업무용 에이전트를 겨냥한다. Wonder Full은 같은 날 나온 더 강한 변형이며, Muse Code 구독 안에서만 고른다.
Spark 1.3은 2026년 9월 2일에 나왔다. Wonder와 Wonder Full은 2026년 10월 12일에 나왔다. 만든 곳은 Meta Superintellig…