바이브코딩
Hemingway-bench | Surge AI 전문가 작가 글쓰기 Elo와 2026-09-20 순위
표면 광택이 아니라 맛, 독창성, 일관성, 감정 지능으로 모델을 가르는 사람 심사 보드
Surge AI가 대규모 언어 모델의 작문 실력을 전문적으로 측정하는 리더보드인 Hemingway-bench를 운영하고 있다. 공식 페이지는 화려한 수식어나 겉보기에만 번지르르한 문장에 점수를 주는 기존 평가의 한계를 지적하며, 전문 작가들이 창작, 비즈니스, 일상 영역의 글을 맛(taste), 독창성, 일관성, 감정 지능 기준으로 비교한다고 설명한다. 조사 기준일은 2026년 9월 20일 Asia/Seoul이며, 본문에 인용된 순위와 95% 신뢰구간은 공식 리더보드 페이지의 실시간 표기를 따른다. 방법론의 배경과 문제의식은 2026년 2월 4일 Surge AI가 게재한 블로그 글을 기준으로 분석했다.
발표 당시 블로그와 소셜 미디어에서는 Gemini 3 Flash, Gemini 3 Pro, Claude Opus 4.5 등이 우수한 작성 사례로 소개되었다. 반면 2026년 9월 20일 기준 공식 리더보드 1위와 2위는 각각 Claude Fable 5(Adaptive/High reasoning, Elo 1110)와 Gemini 3.7 Flash(Medium reasoning, Elo 1105)가 차지하고 있다. 발표 초기 서술과 실시간 순위는 평가 풀과 모델 갱신에 따라 달라지므로 이를 명확히 구분하여 읽는 것이 필수적이다. 비공식 아카이브나 외부 미러 사이트의 스냅샷은 공식 점수와 시점 차이가 발생할 수 있어, 본 분석에서는 오직 Surge AI 공식 페이지만을 단일 출처로 채택했다. 상위 10위 모델만 본문에서 집중 분석하며, 11위 이하 전체 순위는 공식 리더보드를 통해 확인할 수 있다.
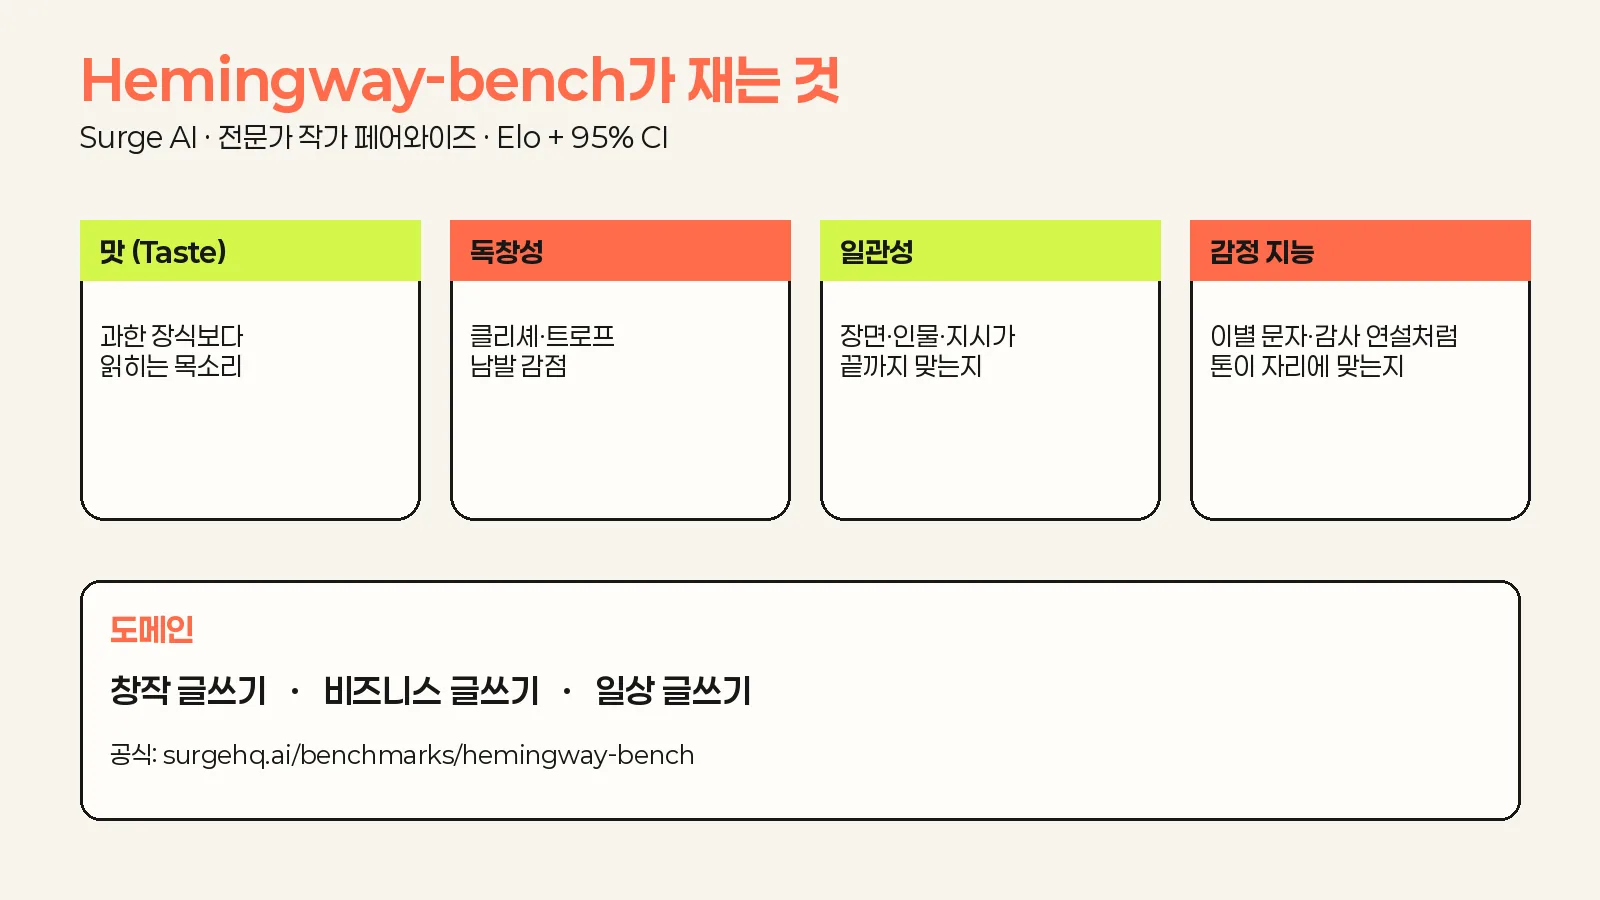
핵심 포인트: Hemingway-bench는 코딩이나 수학적 추론을 측정하는 벤치마크가 아니다. 고객 안내문, 투자 유치 연설문, 마케팅 카피, 제품 문서 등 사용자 대면 글쓰기에서 모델의 어조와 품격을 점검하는 톤 게이트로 활용해야 한다.
Hemingway-bench 개요와 글쓰기 평가의 필요성
Hemingway-bench를 설계하고 주관하는 기업은 고품질 인공지능 학습 데이터를 구축하는 Surge AI다. 언어 모델의 기술적 발전 속도에 비해 글쓰기 품질을 객관적으로 판별하는 체계가 부족하다는 문제의식에서 출발했다. 과제 영역은 상상력이 요구되는 창작, 명료성과 설득력이 핵심인 비즈니스, 자연스러운 소통이 중요한 일상 글쓰기로 나뉜다.
심사를 담당하는 평가단은 시나리오 작가, 시인, 전문 연설문 작성가, 카피에디터 등 실제 작가 직군으로 구성된다. Surge 플랫폼에서 수백 건 이상의 텍스트 평가 과제를 수행하며 최고 등급의 평가 점수를 유지한 전문가들만 선발된다. 평가 절차는 모델명을 철저히 가린 블라인드 1대 1 비교 방식을 취하며, 5,000건 이상의 누적 비교 데이터를 구축했다. 전체적인 품질 평점과 더불어 암시 의도, 창의성, 문장 품질, 진실성, 일관성, 지시 준수, 장황함, 유머 등 8개 세부 항목을 독립적으로 채점한다.
바이브 코딩(Vibe Coding) 실무 관점에서 이 벤치마크는 인공지능 에이전트가 그럴듯한 문장을 지어내는 수준을 넘어 현장의 분위기와 맥락에 걸맞은 목소리를 낼 수 있는지 판단하는 나침반이 된다. 시스템 릴리즈 노트, 장애 사과문, 투자사 보고서처럼 독자가 문장의 뉘앙스를 민감하게 받아들이는 환경에서 진가를 발휘한다. 반면 자동화된 유닛 테스트 성공률이나 복합 함수 호출 정확도는 이 벤치마크로 측정할 수 없으므로 개발 영역과 작문 영역의 벤치마크를 엄격히 분리해 운용해야 한다. 용어의 개념적 정의는 Hemingway-bench 사전 용어 정의에서도 상세히 확인할 수 있다.
좋은 글의 조건과 체크리스트 평가의 함정
Surge AI 블로그가 제시하는 핵심 화두는 체크리스트 방식의 평가가 지닌 치명적 맹점이다. 평가자에게 달에 관한 8줄 시를 작성하라는 지침을 주면, 일반적인 채점은 세 가지 조건만 확인한다. 글이 시의 형태인가, 정확히 8줄인가, 달이라는 소재가 들어갔는가이다. 세 가지 항목이 모두 충족되면 만점을 준다. 하지만 이러한 방식은 지시 사항의 기계적 준수 여부를 확인한 것일 뿐, 시적 상상력이나 문학적 완성도를 증명하지 못한다. 훌륭한 시는 달이라는 단어를 나열하는 것이 아니라 읽고 난 뒤 마음에 와닿는 정서적 울림을 남겨야 한다.
소프트웨어 개발과 프롬프트 엔지니어링에서도 동일한 문제가 반복된다. 개발자가 프롬프트에 감동적으로, 문학적 비유를 담아서, 정중하게 같은 형용사를 지시어로 넣으면, 모델은 표면적인 조건을 맞추기 위해 문장마다 현란한 은유와 접속사를 배치한다. 그 결과 형식적으로는 완벽해 보이지만 정작 문맥의 무게를 견디지 못하는 과장된 문장이 완성된다.
Surge AI는 어니스트 헤밍웨이가 남긴 격언을 인용하며 산문은 건축이지 실내 장식이 아니다라고 강조한다. 벽에 요란한 벽지를 바르고 조명을 달아 장식하는 것보다 기둥을 곧게 세우고 수평을 맞추는 골조 공사가 먼저여야 한다. Hemingway-bench는 인위적인 장식을 걷어내고 문장의 골조인 정확성, 일관성, 뉘앙스, 품격을 사람이 직접 확인하는 벤치마크다.
여덟 가지 평가 축과 Surger 심사위원단의 채점 원칙
블라인드 평가 과정에서 전문 심사위원(Surger)은 두 모델의 답안을 나란히 놓고 비교하며 종합적 우열을 가린다. 이때 단순한 선호도 투표에 그치지 않고 사전에 정의된 8개 차원의 분석 데이터를 기록한다. 블로그에 공개된 핵심 축은 암시 의도(Implicit Intent), 창의성, 문장 품질, 진실성, 일관성, 지시 준수, 장황함, 유머다.
| 평가 항목 | 의미와 채점 방향 | 감점 대상이 되는 패턴 |
|---|---|---|
| 암시 의도 | 명시되지 않은 화자의 정서와 상황적 배경 파악 | 직설적이고 폭력적인 표현을 여과 없이 옮김 |
| 창의성 | 뻔한 클리셰를 피하고 신선한 관점 제시 | 널리 알려진 비유나 인터넷 밈을 단순 나열 |
| 문장 품질 | 리듬감과 단어 선택, 건축적 안정성 | 문장마다 은유를 중복 배치하여 가독성 저하 |
| 진실성 | 억지 감정 유발을 배제한 진솔한 태도 | 지나치게 작위적이거나 과장된 감상주의 |
| 일관성 | 장편 서사 및 복잡한 맥락에서 인과관계 유지 | 등장인물 설정, 공간 배치, 시점의 혼선 |
| 지시 준수 | 제약 조건과 분량의 정확한 이행 | 분량을 채우기 위해 덧붙인 군더더기 사족 |
| 장황함 | 군더더기 없는 담백하고 압축적인 서술 | 불필요한 접속사와 중언부언식 설명문 |
| 유머 | 상황에 부합하는 자연스럽고 절제된 기지 | 억지스러운 농담이나 분위기를 깨는 슬랩스틱 |
암시 의도는 특히 감정이 민감하게 개입하는 과제에서 변별력을 발휘한다. 격앙된 어조로 작성된 이별 통보 프롬프트가 주어졌을 때, 하위권 모델은 화자의 분노를 문자 그대로 반영하여 상대방을 깎아내리는 모욕적인 FAQ 문서를 작성했다. 반면 전문 작가들이 만점을 부여한 모델은 분노의 이면에 담긴 단절의 의사를 읽어내고, 불필요한 상처를 주지 않으면서도 단호하고 명확한 짧은 메시지를 제안했다.
유머 항목 역시 단순한 웃음 유발을 목적으로 삼지 않는다. 잃어버린 고양이를 찾는 단편 소설 과제에서 선호된 결과물은 남들이 들을까 봐 부끄러워하며 작게 고양이를 부르는 주인공의 행동처럼, 일상의 결을 포착한 절제된 묘사였다.
리더보드 상위 10개 모델과 2026-09-20 순위 분석
공식 리더보드에 등재된 상위 10개 모델의 수치는 다음과 같다. 9위 항목은 공식 페이지 표기인 5.6 Sol (Medium reasoning)을 그대로 반영했다. 다른 벤치마크 표기에서는 GPT 5.6 Sol로 통칭되기도 한다.
| 순위 | 모델명 | Elo 레이팅 | 95% 신뢰구간 | 추론 모드 |
|---|---|---|---|---|
| 1 | Claude Fable 5 | 1110 | 1091-1130 | Adaptive / High reasoning |
| 2 | Gemini 3.7 Flash | 1105 | 1084-1126 | Medium reasoning |
| 3 | Claude Fable 5.1 | 1095 | 1071-1118 | Adaptive / High reasoning |
| 4 | Gemini 3.8 Flash | 1093 | 1069-1117 | Medium reasoning |
| 5 | Gemini 3.6 Flash | 1075 | 1055-1095 | Medium reasoning |
| 6 | Gemini 3.1 Pro | 1073 | 1057-1088 | High reasoning |
| 7 | Gemini 3.5 Flash | 1071 | 1054-1088 | Medium reasoning |
| 8 | Kimi K3 | 1069 | 1049-1089 | Max reasoning |
| 9 | 5.6 Sol (페이지 표기) | 1057 | 1037-1076 | Medium reasoning |
| 10 | Gemini 3 Pro | 1056 | 1031-1081 | High reasoning |
11위 이하 전체 모델의 점수와 세부 통계는 공식 리더보드 웹사이트에서 확인할 수 있다.
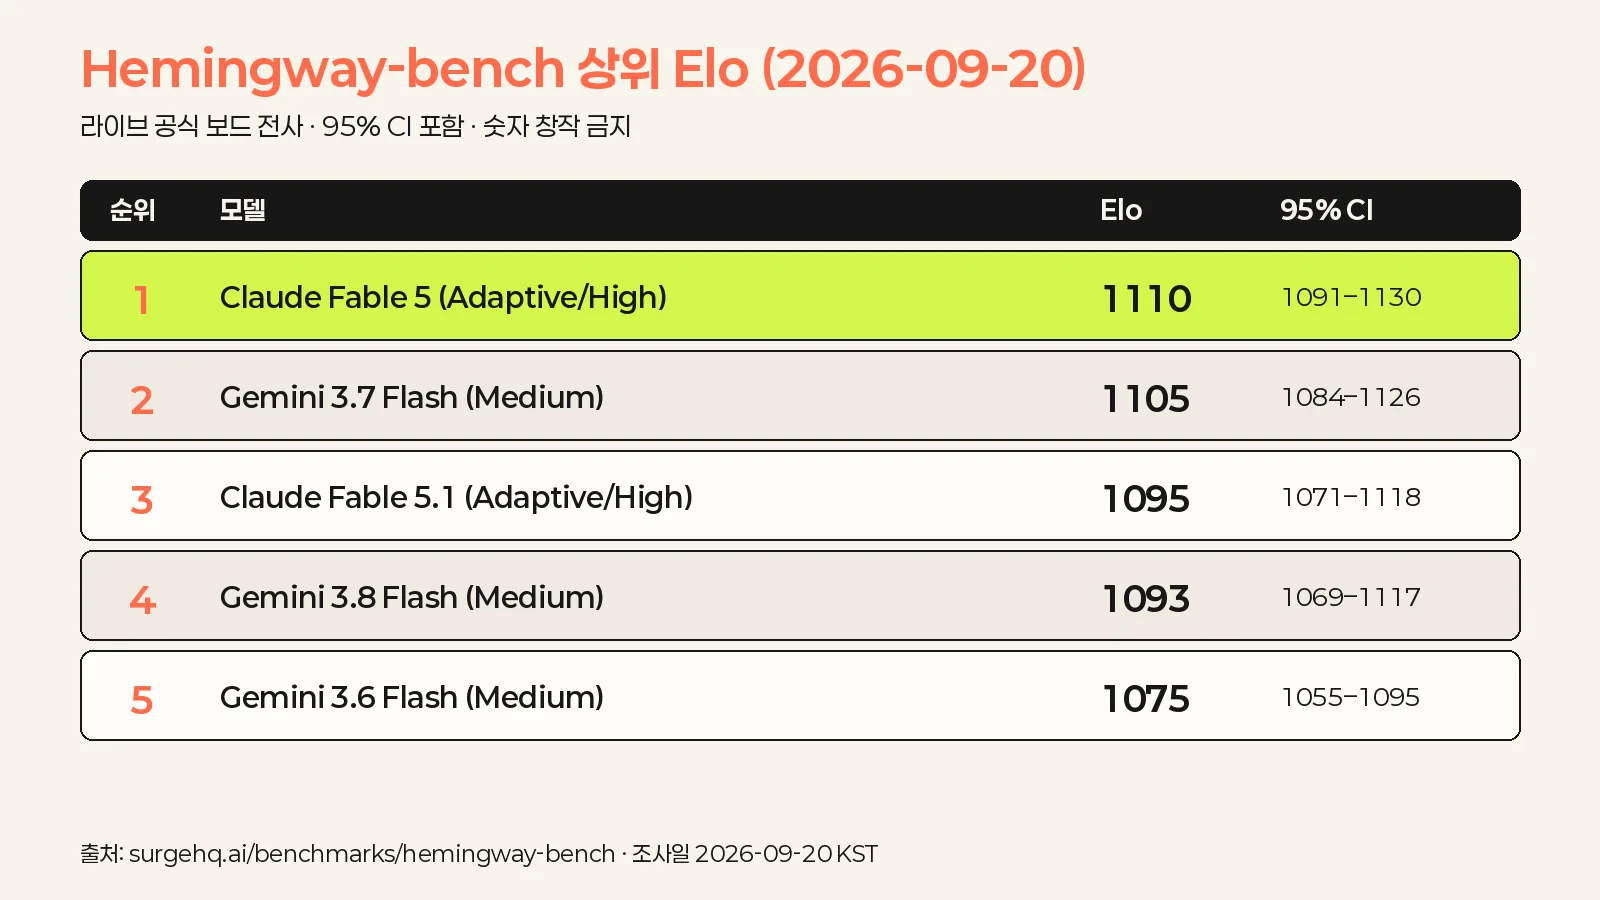
데이터를 분석할 때 주의할 점은 신뢰구간의 겹침이다. 1위인 Claude Fable 5(1110)와 2위인 Gemini 3.7 Flash(1105)는 불과 5점 차이이며, 두 모델의 95% 신뢰구간(1091-1130 vs 1084-1126)은 상당 부분 중첩된다. 이러한 경우 통계학적으로 두 모델 사이에 결정적인 성능 우열이 존재한다고 단정하기 어렵다. 순위 숫자에 매몰되기보다 두 모델이 보여주는 문체적 특성과 추론 모드의 특성을 이해하는 것이 합리적이다.
방법론 상세와 전문가 블라인드 페어와이즈 프로세스
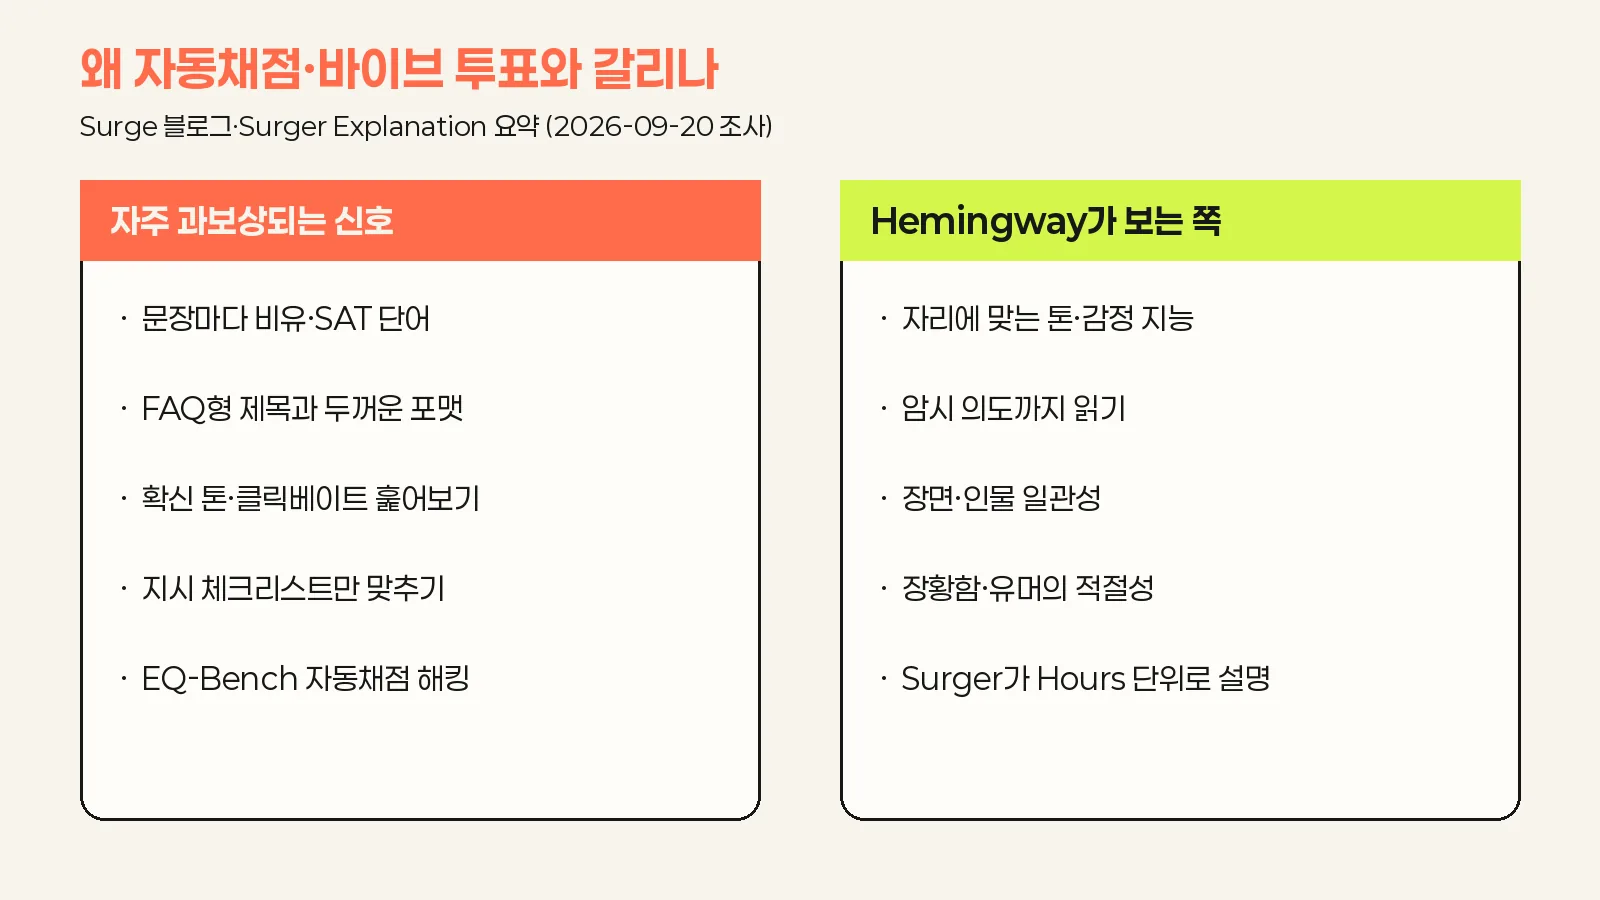
Surge AI가 내건 핵심 슬로건은 수 초가 아니라 수 시간(Hours, Not Seconds)이다. 일반적인 크라우드 워커 대상의 평가나 자원봉사자 투표는 한 쌍의 글을 읽고 판단하는 데 10초 내외의 시간만 소비한다. 이로 인해 첫 문단의 화려함이나 포맷의 단정함만 보고 투표하는 피상적 평가가 주를 이룬다.
반면 Hemingway-bench의 심사위원단은 최소 수백 시간 이상의 전문 작문 및 교정 경력을 가진 선별된 패널이다. 이들은 제출된 텍스트 전체를 정독하고 문맥의 인과관계와 서사의 내적 정합성을 꼼꼼하게 검토한다.
평가 프로세스는 두 모델의 식별 정보를 완전히 제거한 상태에서 진행된다. 평가자는 모델 A와 모델 B 중 어느 쪽이 우수한지 판정하고, 승패 판정의 구체적인 이유를 문장 단위로 해설한 Surger Explanation을 작성하여 제출한다. 이 해설 데이터는 공식 페이지에 모델별 승패 사례와 함께 투명하게 공개되어, 개발자와 연구자들이 탈락 원인을 명확하게 학습할 수 있는 가이드라인 역할을 한다.
EQ-Bench 자동 채점 및 LMArena와의 근본적 차이
Surge AI 블로그는 업계에서 널리 활용되는 기존 벤치마크들과의 차이점을 구체적인 실험 데이터로 비교 분석했다.
가장 대표적인 대조군은 언어 모델을 채점관으로 활용하는 EQ-Bench Creative Writing이다. Claude 3.7을 기반으로 자동 평가를 수행하는 이 벤치마크는 인간 전문가와의 일치율이 43%까지 떨어지는 심각한 불일치를 보였다. 프론티어 AI 연구소의 관찰에서도 자동 채점 점수와 인간 작가의 체감 품질 사이에 음의 상관관계가 나타나는 현상이 포착되었다.
리타 메이 브라운 문체 모사 과제에서 자동 평가기는 첫 두 문단에 4개의 비유를 연달아 배치한 모델의 결과물에 거의 모든 세부 항목에서 만점을 부여했다. 그러나 Hemingway-bench의 전문 심사위원들은 이 문장을 서사 구조를 해치는 우스꽝스러운 패러디로 평가절하했다. 고등학교에서 대학교로 진학하는 청춘의 방황을 다루어야 할 소설이 법학 학위, 미완성 소설, 이혼 이야기로 제멋대로 튀어버린 구조적 결함을 자동 채점기는 간파하지 못했다.
LMArena류의 빠른 대중 투표 역시 맹점을 드러낸다. 투표 시간이 극도로 짧다 보니 문장의 확신에 찬 어조나 깔끔한 글머리 기호 배치에 점수를 몰아주는 경향이 강하다. 식당 부스에 앉아 대화를 나누던 인물이 장면 말미에 뜬금없이 의자에서 굴러떨어지는 식의 치명적인 서사 오류도 빠른 훑어보기 환경에서는 그대로 통과되었다. Hemingway-bench는 인간이 시간을 들여 긴 호흡으로 읽을 때만 발견할 수 있는 문학적 골조의 붕괴를 잡아낸다.
모델별 초기 관찰 페르소나와 해석상의 주의점
Surge AI는 벤치마크 출범 당시 블로그를 통해 주요 모델들의 작문 특성을 비유적으로 묘사했다. 이 기록은 모델별 성향을 이해하는 정성적 참고 자료이며, 실시간 Elo 순위와 기계적으로 결부해서는 안 된다.
Gemini 3 Flash는 엄격한 글자 수나 형식 제약 속에서도 군더더기 없는 담백한 어휘로 문학적 감각을 살려내는 능숙한 문장가로 평가되었다. Gemini 3 Pro는 1950년대 필리핀 가정집의 늦은 오후 햇살과 전통 요리의 향기처럼, 감각적 디테일을 생생하게 구현하는 세계관 구축에 탁월한 면모를 보였다. Claude Opus 4.5는 잘 보이려고 과장하지 않으면서도 결혼식 축사처럼 청중의 마음에 자연스럽게 스며드는 사람다운 목소리를 들려주었다.
GPT-5.2 Chat은 복잡한 일정 조율 메일이나 구조화된 조언처럼 단정함이 필요한 일상 실무 문서에서 안정적인 필력을 보여주었다. API 버전은 마케팅 카피와 비즈니스 서신에 강점을 보였으나 창작 영역에서는 다소 경직되었다는 평가를 받았다. Qwen3는 번뜩이는 독창성을 발휘하지만 사실 왜곡이나 억지스러운 유머를 섞는 고위험 고보상 성향을 나타냈다. Grok은 캐주얼한 대화에 강한 반면 비즈니스 과제에서도 대중문화 패러디를 남발하는 경향을 보였다. Kimi K2는 실무 작성은 무난했으나 창작 과제에서 어색한 조어를 만들어내는 한계를 드러냈다.
이러한 초기 관찰 페르소나는 특정 모델의 고정불변한 낙인이 아니다. 각 연구소가 모델을 지속해서 미세 조정함에 따라 결함은 빠르게 보완되고 있다.
Surger Explanation 실제 평가 사례와 감점 패턴
Surge AI 공식 사이트와 방법론 블로그에 수록된 실제 평가 사례를 과제 유형별로 분석하면 공통적인 감점 요인이 명확히 드러난다.
첫째, 일상 속 조용한 단편 소설 과제다. 잃어버린 고양이를 찾는 이웃 이야기에서 한 모델은 주황색 줄무늬 고양이, 참치캔, 고양이 알레르기 핑계, 외로운 독거노인 같은 흔해 빠진 클리셰를 빽빽하게 채워 넣었다. 반면 승리한 모델은 고양이가 돌아오지 않았음을 암시하는 작은 단서들을 조용히 모으며, 상대방을 배려해 짐짓 계속 찾아 나서는 주인공들의 섬세한 관계 변화를 그려냈다.
둘째, 공식 감사 연설문 과제다. 수술 후 퇴원하여 학교에 복귀한 학생의 감사 연설 프롬프트에서, 패배한 모델은 커피 컵을 쥐고 선 일상적 장면에 과도한 시적 수사를 쏟아부었다. 김이 안경을 덮는 순간을 우주의 섭리에 비유하는 식의 과장이 전문 작가들에게 작위적인 어색함으로 지적되었다. 승리한 모델은 수술실 밖을 지키던 친구들의 소박한 표정과 온기를 진솔하게 표현하여 감동을 주었다.
| 과제 영역 | 전문 심사위원이 선호한 모범 서술 | 심사위원에게 감점당한 실패 패턴 |
|---|---|---|
| 서정적 단편 | 절제된 감정 표현, 여백의 미, 암시적 전개 | 흔한 클리셰 남발, 지나치게 직설적인 상황 설명 |
| 작가 문체 모사 | 원작자의 사회적 시선과 주제 의식 계승 | 매 문장마다 과도한 비유 배치, 이야기 탈선 |
| 감정 민감 서신 | 단호하면서도 상대의 존엄성을 배려한 절제 | 분노를 직역한 모욕적 언사, 기계적 FAQ 구성 |
| 대중 연설문 | 현장의 분위기에 어울리는 따뜻하고 담백한 감사 | 일상적인 장면에 어울리지 않는 거창한 우주적 은유 |
| 블랙 코미디 | 상황의 부조리함 속에서 피어나는 신선한 위트 | 억지스러운 말장난, 유머를 설명하려는 지문 |
바이브 코딩 파이프라인 적용법과 한계
소프트웨어 개발과 인공지능 에이전트 구축 실무에서 Hemingway-bench의 가치를 극대화하려면 모델의 역할 분담 체계를 정립해야 한다.
코드 작성, 복잡한 비즈니스 로직 설계, 데이터 파싱 같은 테크니컬 영역에서는 추론 특화 모델을 활용한다. 반면 최종 사용자에게 노출되는 시스템 알림 메시지, 에러 안내문, 릴리즈 노트, 고객 지원 답변을 생성할 때는 Hemingway-bench 상위권 모델을 톤 게이트로 배치하는 2단계 파이프라인이 효과적이다.
| 권장되는 활용 시나리오 | 부적합한 오용 시나리오 |
|---|---|
| 고객 대면 이메일 및 사과문의 톤앤매너 검증 | 코딩 및 유닛 테스트 통과율 평가 대체 |
| 과도한 비유와 수식어 억제 가드레일 설계 | 리더보드 전체 프롬프트 데이터셋 임의 복제 |
| Surger Explanation 기반 실패 프롬프트 개선 | 신뢰구간이 겹치는 근접 순위 간 절대적 우열 단정 |
| 최종 산출물의 감정 지능 및 어조 필터링 | 다단계 도구 호출 및 장문 코드베이스 분석 평가 |
실무 프롬프트 작성 시에는 Hemingway-bench의 감점 요인을 방지하기 위한 시스템 가드레일을 명시적으로 설정하는 것이 권장된다.
아래 프롬프트 템플릿은 과도한 비유 남발과 기계적 응답을 차단하고 담백한 문장 구조를 강제하는 실제 적용 예시다.
# 전문 작가 심사 기준을 반영한 시스템 가드레일 예시
당신은 회사의 공식 대외 커뮤니케이션을 총괄하는 수석 에디터입니다.
다음 원칙에 따라 문장을 정제하십시오:
1. 문장마다 은유나 직유를 억지로 덧붙이지 말고 사실과 핵심 상황을 담백하게 서술하십시오.
2. 기계적인 번호 매기기나 FAQ 나열을 지양하고 문맥의 자연스러운 흐름을 살리십시오.
3. 고객의 부정적 감정에는 형식적 사과 대신 상황에 대한 공감과 명확한 대책을 단호하게 제시하십시오.
4. 화려한 수식어로 문장을 꾸미기보다 주어와 서술어의 호응이 명확한 건축적 산문을 지향하십시오.
Hemingway-bench가 지닌 태생적 한계도 명확히 인지해야 한다. 공식 웹사이트는 대표적 예시 과제와 심사 총평만 공개할 뿐, 전체 벤치마크 프롬프트 세트와 샘플링 하이퍼파라미터는 외부에 공개하지 않는다. 따라서 제3자가 동일한 조건으로 실험을 완벽히 재현하기는 어렵다. 또한 이 벤치마크의 Elo 레이팅은 순수한 작문 역량에 국한되므로, 이를 범용 인공지능의 종합 지능 지수로 일반화해서는 안 된다.
마무리
앞에서 다룬 Hemingway-bench의 핵심 원칙과 실무 시사점을 정리한다.
- Surge AI가 운영하는 전문 작가 기반의 블라인드 1대 1 글쓰기 Elo 리더보드다.
- 단순한 조건 충족 여부만 따지는 체크리스트 평가의 한계를 극복하고자 출범했다.
- 창작, 비즈니스, 일상 영역의 글을 맛, 독창성, 일관성, 감정 지능 등 8개 차원으로 측정한다.
- 2026년 9월 20일 기준 리더보드 1위는 Claude Fable 5(Elo 1110), 2위는 Gemini 3.7 Flash(Elo 1105)다.
- 심사위원 해설인 Surger Explanation은 과도한 비유 남발과 상황에 맞지 않는 시적 수사를 대표적 감점 요인으로 꼽는다.
- 자동 채점 기반의 EQ-Bench나 초 단위로 훑어보는 LMArena 투표가 놓치는 구조적 서사 붕괴를 잡아낸다.
- 바이브 코딩 환경에서는 사용자 대면 산출물의 어조와 감정 지능을 점검하는 최종 검증 게이트로 활용한다.
「산문은 건축이지 실내 장식이 아니다」 에이전트에게 텍스트 작성을 맡길 때는 겉으로 드러나는 유려함에 현혹되지 말고, 문장의 골조가 상황의 무게를 올바르게 지탱하고 있는지부터 확인해야 한다.
출처와 링크
조사 기준: 2026년 9월 (2026-09-20 Asia/Seoul 공식 웹페이지 확인). 방법론 블로그 발행일: 2026년 2월 4일.
FAQ
자주 묻는 질문
Hemingway-bench는 누가 운영하며 어떤 방식으로 평가하나요?
인공지능 학습 데이터를 구축하는 전문 기업 Surge AI가 운영하는 글쓰기 리더보드입니다. 시나리오 작가, 시인, 연설문 작가, 교정 에디터 등 선별된 전문 작가 패널이 모델명을 가린 블라인드 1대 1 비교로 5,000건 이상의 텍스트를 정밀 심사합니다.
기존의 EQ-Bench Creative Writing과 비교할 때 가장 큰 차이점은 무엇인가요?
EQ-Bench는 언어 모델을 평가자로 쓰는 LLM-as-a-Judge 방식으로 문장마다 비유가 과도한 텍스트에 만점을 주는 보상 해킹에 취약합니다. Surge AI 연구에서 인간 전문가와의 일치율이 43%까지 떨어졌으며, Hemingway-bench는 인간 전문가가 시간을 들여 정독하는 방식을 취합니다.
달 시 8줄 체크리스트 평가의 한계는 왜 생기나요?
시의 형태, 8줄 분량, 달이라는 단어 포함 여부만 따지는 평가는 지시 사항 준수 여부만 기계적으로 확인할 뿐입니다. 문학적 상상력이나 읽은 뒤 남는 감정적 여운을 전혀 측정하지 못하므로 겉치레 문장만 양산하게 됩니다.
2026년 9월 20일 기준 상위권 모델 순위는 어떻게 되나요?
공식 리더보드 기준 1위는 Claude Fable 5(Elo 1110)이며, 2위는 Gemini 3.7 Flash(Elo 1105), 3위는 Claude Fable 5.1(Elo 1095)입니다. 1위와 2위의 95% 신뢰구간이 중첩되므로 통계적으로 절대적 우열을 가리기보다 문체 성향에 맞추어 선택하는 것이 합리적입니다.
Surger Explanation이란 무엇이며 실무에서 어떻게 활용하나요?
전문 심사위원이 두 모델의 답안을 비교한 뒤 구체적인 승패 이유를 문장 단위로 기록한 해설 데이터입니다. 과도한 비유 남발이나 무례한 직설 표현 등 실제 감점 요인을 확인하고 에이전트 시스템 프롬프트의 가드레일로 반영할 수 있습니다.
바이브 코딩 에이전트 워크플로에서 이 보드를 어떻게 연계해야 하나요?
코드 생성이나 복잡한 알고리즘 추론은 전용 모델에 맡기고, 고객 대면 릴리즈 노트나 에러 메시지, 이메일 등의 최종 어조를 검증하는 2단계 톤 게이트로 Hemingway-bench 상위권 모델을 배치하는 것이 효과적입니다. 이를 통해 기술적 정확성과 사용자가 체감하는 소통의 품격을 동시에 확보할 수 있습니다.
글쓰기 Elo 점수가 높은 모델이 코딩과 수학도 잘하나요?
그렇지 않습니다. Hemingway-bench는 순수한 작문 역량과 어조, 감정 지능을 측정하는 지표이므로 단위 테스트 통과율이나 복합 도구 호출 등 소프트웨어 엔지니어링 성능과는 직접적인 상관관계가 없습니다.
공개된 리더보드 데이터만으로 동일한 벤치마크를 직접 재현할 수 있나요?
전체 프롬프트 세트와 샘플링 하이퍼파라미터, 심사위원 배정 세부 내역은 외부에 공개되지 않았습니다. 공식 페이지는 대표 평가 사례와 종합 지표만 제공하므로 외부 연구자가 완벽하게 동일한 조건으로 재현하기는 어렵습니다.
용어
관련 용어
Surge AI가 운영하는 전문 작가 페어와이즈 글쓰기 평가 Elo 리더보드다. 표면적 체크리스트를 넘어 맛, 독창성, 일관성, 감정 지능으로 대규모 언어 모델의 글쓰기 품질을 비교한다.
핵심 개념 바이브 코딩 스펙트럼AI 참여도에 따른 코딩 방식의 연속적 범위를 나타내는 개념 모델. 한쪽 끝에는 개발자가 모든 코드를 직접 작성하는 '완전 수동 코딩(Manual Coding)'이 있고, 반대쪽 끝에는 AI가 독립적으로 소프트웨어를 구축하는 '완전 AI 자율 코딩(Autonomous Development)'이 있으며, 대부분의 실무는 그 사이 어딘가에 위치한다. 일반적으로 Manual Coding → AI-Assisted Coding(자동완성·제안 수준) → Vibe Coding(자연어 기반 코드 생성) → Agentic Engineering(AI 에이전트 자율 작업 + 인간 감독) 순으로 AI 참여도가 높아진다. 중요한 것은 이것이 '진화의 단계'가 아니라 '선택의 스펙트럼'이라는 점이다. 같은 개발자가 같은 프로젝트 내에서도 작업의 성격에 따라 다른 지점을 선택할 수 있다. 예를 들어, 단순 스크립트나 보일러플레이트는 바이브 코딩으로, 핵심 결제 로직이나 보안 관련 코드는 AI 어시스트 + 수동 코딩으로, 대규모 리팩토링은 에이전틱 엔지니어링으로 접근하는 식이다.
concept 대규모 언어 모델방대한 텍스트로 학습해 언어를 생성·변환하는 AI 모델. 맥락을 보고 다음 언어 조각을 예측하며, Transformer 계열 딥러닝이 흔하다. 바이브코딩 도구의 코드 생성 엔진이다.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
구글 애드센스 고시 SEO 점검 개선 후 승인 | fire-your-seo-agency 스킬
사이트를 만들어 두고 Google 애드센스에 신청했다가, 몇 달째 통과하지 못한 적이 있다. 거절 메일을 받을 때마다 무엇을 고쳐야 하는지가 한 줄로 떨어지지 않았고, AI에게 「SEO 점검하고 개선해 줘」라고만 말해 보기도 했다. 그때마다 뭔가 바뀌기는 했지만, 기준이 없어서 다음에 같은 점검을 다시 시킬 수가 없었다.
이거, 메일 받아 보신 분? 많으실 겁니다. 애드센스를 하다 보면 마주치는 그 팔짱 낀 아저씨 쪽에, 이런 사유가 적혀 있었다.
그림. 애드센스 안내에서 자주 보이는 팔짱 낀 아저씨
바이브 코딩 게임으로 돈 버는 과정 | 국내 유료 웹게임 정식 오픈까지
브라우저에서 돌아가게 만든 게임을, 자기 사이트에서 돈을 받고 한국에서 정식으로 여는 순서이다. 서버를 켜고 카드 결제만 붙이면 끝나는 일이 아니다.
웹에서 실행된다고 해서 그냥 웹서비스로만 보면 빠지는 법이 있다. 오락을 하게 만든 프로그램이면 게임 쪽 법을 본다. 이용자에게 돈을 받으면 전자상거래 쪽 법을 본다. 회원 정보를 받으면 개인정보 쪽 법을 본다. 영업으로 하면 세금이 붙는다. 이 글은 그 네 갈래를, 혼자 만드는 사람이 따라 할 수 있는 순서로 정리한 것이다. 특정 게임의 법률 자문이 아니고, 조문과 공식 안내를 읽은 뒤의 절차 설명이다. 신청 직전에는 국가법령정보센터의 현행 조문을 다시 연다.
조사 기준일은 2026년 10월 3일이다. 대상은 자기 사이트에서 국내 이용자에게 돈을 받고 여는 1인 웹게임이다. 오락실 허가나 앱 마…