바이브코딩
Inception Mercury 3 | 확산 LLM 속도, 가격, 한국 PC 실측
여러 토큰을 같이 다듬는 확산 언어 모델. 할인가와 한국 PC 실측을 한 문서에 적는다.
Inception은 2026년 10월 19일 Mercury 3를 공개했다. Mercury 3는 문장을 한 단어씩 이어 붙이는 모델이 아니라, 여러 토큰을 한 번에 놓고 다듬는 확산(diffusion) 언어 모델이다. 코딩 보조, 검색 에이전트, 실시간 튜터, 고객 응대처럼 답이 빨리 나와야 하는 자리에 넣으라고 소개됐다.
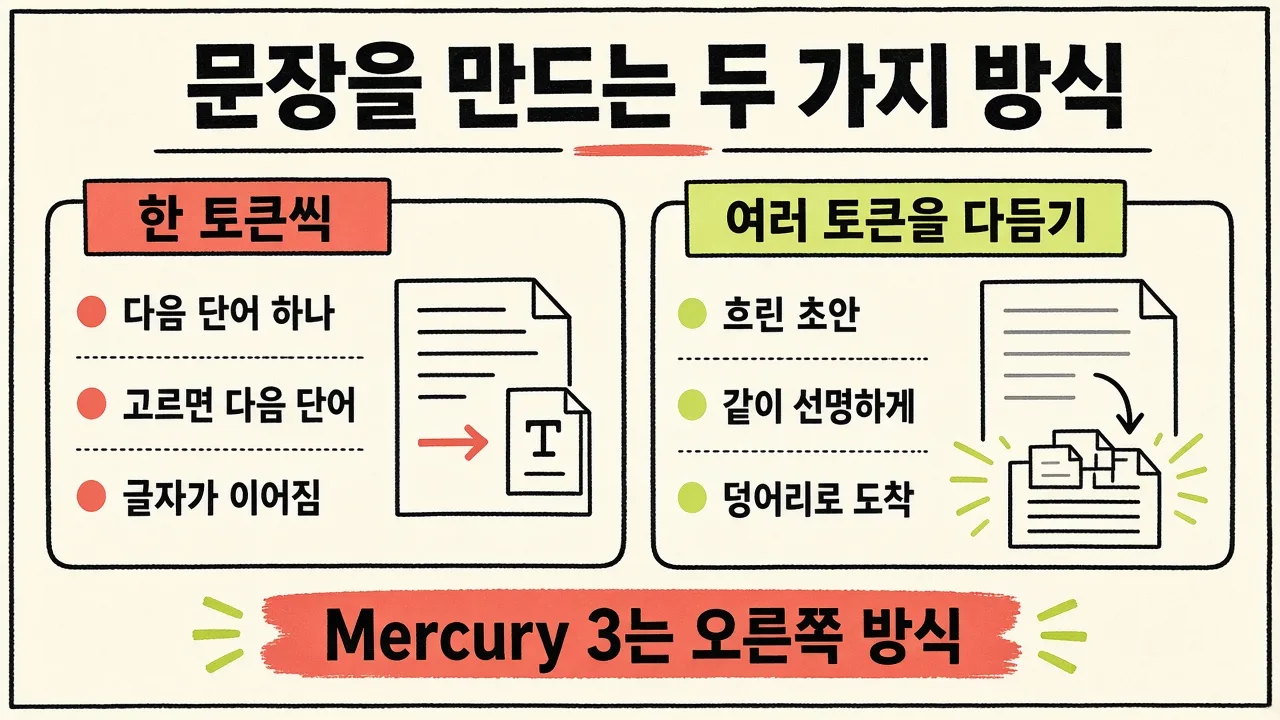
한 토큰씩 쓰는 모델은 다음 단어 하나를 고른 뒤 그 다음 단어를 고른다. 확산 모델은 흐린 초안의 여러 칸을 같이 선명하게 만든다. 그래서 화면에는 글자가 한 개씩 타자기처럼 나오기보다, 다듬어진 텍스트 덩어리가 도착하는 쪽이 많다.
공식 블로그는 출력 속도를 초당 1,068토큰, GPT-6 Luna와 Claude Haiku 5.5보다 4배에서 8배 빠르다고 적는다. 이 숫자는 Inception이 스스로 밝힌 공식 주장이다. 필자는 2026년 10월 23일 03:45-03:57(한국 시간) 에 한국 Windows PC에서 Inception 공식 API만 호출했다. Luna와 Haiku 5.5는 호출하지 않았고, OpenRouter를 거친 속도 측정도 하지 않았다.
적는 범위는 첫 글자까지 걸린 시간, 추론 토큰을 넣은 속도, 화면에 보이는 답만의 속도, 8,804토큰 입력의 요약, 형식 맞추기, 공개 단가 환산, OpenCode의 모델 id다. 조사 기준일은 2026년 10월 23일이다.
Mercury 3가 하는 일
Mercury 3는 글을 생성하는 언어 모델이다. 이미지 모델이 아니다. 입력은 텍스트이고, 출력도 텍스트다. 채팅 한 번으로 끝나기보다, 에이전트가 같은 모델을 여러 번 부르는 자리에서 한 번의 지연이 쌓이지 않게 하려는 용도가 앞에 나온다.
하는 일은 다섯 갈래다. 질문에 답을 쓴다. 긴 입력을 짧게 줄인다. 지정한 형식(줄 수, JSON, 도구 호출)에 맞춘다. 추론 강도를 instant, low, medium, high 중에서 고른다. 스트리밍으로는 다듬어진 텍스트 덩어리를 중간중간 보낸다.
이전 모델과 역할이 갈린다. Mercury 2에서 추론이 들어왔고, Mercury 2.5에서 추론 강도를 조절하면서 컨텍스트가 26만 토큰이 됐다. Mercury 3의 컨텍스트는 100만 토큰이다. 블로그는 Mercury 1보다 총 파라미터가 40배 넘게 커졌고, Mercury 1 mini에서 Mercury 3로 오면서 표준 벤치 지능이 3배가 됐다고 적는다. 이 배수는 공식 주장이고, 파라미터의 절대 개수는 공개되지 않았다.
초기 사용처로 블로그가 적은 자리는 브라우저를 누르는 에이전트, 실시간 교육, 실시간 검색, 고객 응대, 데이터 엔지니어링이다. 파트너가 말한 지연도 공식 주장이다. RevisionDojo는 힌트와 채점과 정의가 약 1초에 돌아온다고 했고, Octen AI는 생성 시간 중앙값 0.9초, 끝까지의 중앙값 2.2초라고 했다. TinyFish는 같은 웹 에이전트 하네스에서 Mind2Web 과제 50개 중 50%를 끝냈고, 그 비율이 GPT-6.1-Sol보다 많았다고 블로그에 적혀 있다. 필자는 이 파트너 과제를 다시 돌리지 않았다.
가격과 호출 위치
지금 바로 볼 숫자는 가격과 기본 설정이다. 정가는 입력 100만 토큰당 $0.20, 출력 $0.70이다. 출시 할인은 50%라서 입력 $0.10, 출력 $0.35다. 블로그 비교표의 $0.10 / $0.35는 이 할인가다. 할인 종료일은 블로그와 문서에 없다.
같은 표에서 GPT-6 Luna와 Claude Haiku 5.5의 표기 가격은 입력 $0.10, 출력 $0.50이다. 할인이 유지되는 동안 Mercury 3의 입력 단가는 둘과 같고, 출력 단가는 $0.15 낮다. 할인이 정가로 돌아가면 입력은 둘의 2배이고, 출력은 $0.70 대 $0.50이라 1.4배다. 이 배율은 공개된 100만 토큰 단가를 나란히 놓은 계산이다. Haiku 5.5는 10만 토큰을 넘는 구간, Luna는 27.2만 토큰을 넘는 구간에 다른 단가가 있다. 그 긴 구간은 이 배율에 넣지 않았다.
신규 API 키에는 1억 토큰이 무료로 붙는다고 블로그가 적는다. 필자가 단가를 곱한 계정은 그 무료 토큰을 쓰고 있었고, 응답 JSON에 청구 금액 필드는 없었다. 아래 작업 비용은 카드 청구액이 아니라 공개 단가 환산이다.
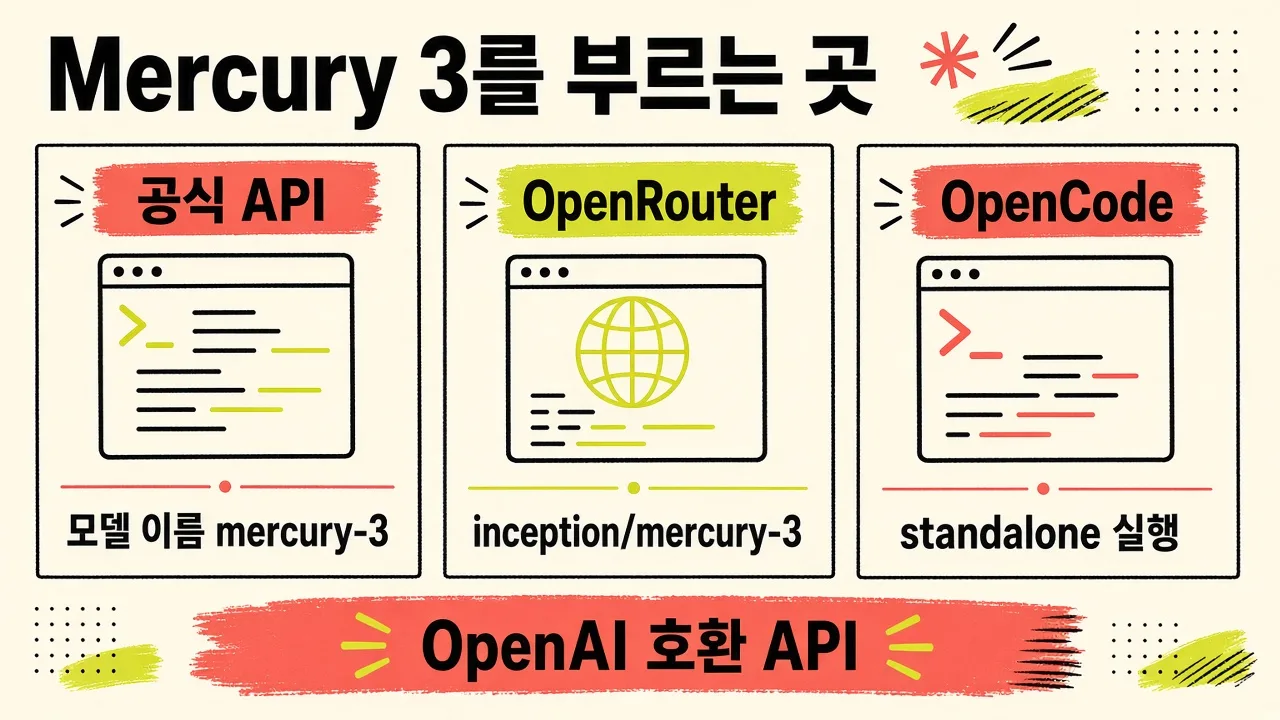
부르는 곳은 네 곳이다. Inception API의 모델 id는 mercury-3이고, 완성 엔드포인트는 https://api.inceptionlabs.ai/v1/chat/completions이다. OpenRouter id는 inception/mercury-3이다. 블로그는 Baseten과 Vercel AI Gateway에도 있다고 적는다. OpenAI 채팅 완성 형식과 맞아서, 주소와 모델 이름만 갈면 요청 본문은 그대로다.
문서상 reasoning_effort를 비우면 mercury-3의 기본값은 low다. 블로그 벤치마크 표의 머리글은 세 모델 모두 medium이다. 기본 호출과 표의 조건이 다르다.
핵심 포인트: 비교표의 $0.10 / $0.35는 출시 할인가다. 정가는 $0.20 / $0.70이고, 할인이 끝나는 날짜는 공개되지 않았다.
OpenRouter 페이지가 2026년 10월 23일에 보여 준 가중평균 결제가는 입력 $0.02352, 출력 $0.3622, 캐시 적중률 86.6%였다. 목록 단가와 결제 평균은 캐시 때문에 달라진다. 이 평균은 그날 페이지의 숫자라 이후에는 바뀐다.
한 토큰씩 쓰기와 여러 토큰을 다듬기
한 토큰씩 쓰는 모델의 한 스텝은 짧다. 이미 쓴 단어를 보고 다음 토큰 하나의 확률을 고른다. 긴 답은 그 스텝이 답의 길이만큼 이어진다. 확산 언어 모델은 순서를 다르게 잡는다. 비어 있거나 노이즈가 섞인 칸을 여러 개 두고, 그 칸을 반복해서 고친다. Inception 문서는 스트리밍 단위를 토큰이 아니라 block이라고 부른다. block은 디코딩 중에 나오는, 이미 어느 정도 다듬어진 텍스트 조각이다.
체감은 두 구간으로 나뉜다. 첫 글자까지 기다리는 시간이 있고, 그 다음에 조각이 붙어 오는 시간이 있다. 추론 강도를 올리면 본문이 나오기 전에 생각 토큰을 먼저 쓴다. 생각 토큰은 화면에 문장으로 보이지 않아도 출력 토큰 수와 시간에는 들어간다. 그래서 "초당 몇 토큰"이라는 말만으로는 보이는 답의 빠르기가 결정되지 않는다.
diffusing은 그 다듬기 과정을 응답 스트림에 보여 주려는 옵션이다. 문서 스트리밍과 확산은 stream을 켠 요청과 같이 쓰라고 한다. 필자가 스트림을 끈 요청에 diffusing: true를 넣었더니 HTTP 400이 왔고, 코드는 diffusing_not_supported였다. 스트림을 켠 같은 옵션은 HTTP 200이었고, 0.48초 동안 content 청크가 2개 왔다. 각 청크는 115자였다. 그 짧은 문장에서는 노이즈가 단계로 깔리는 열은 보이지 않았다.
핵심 포인트: diffusing은 스트리밍 요청에서만 동작했다. 스트림을 끄면 서버가 diffusing_not_supported를 반환했다.
공식 속도 주장과 비교표
블로그 본문은 Mercury 3가 NVIDIA GPU에서 1,068 tokens/s로 돌고, Luna와 Haiku 5.5보다 4배에서 8배 빠르다고 적는다. 보도자료의 GPU 표현은 "widely available NVIDIA GPUs"이다. 필자의 PC 측정은 이 배수를 확인하는 실험이 아니다. Luna와 Haiku 5.5를 같은 프롬프트로 부르지 않았다.
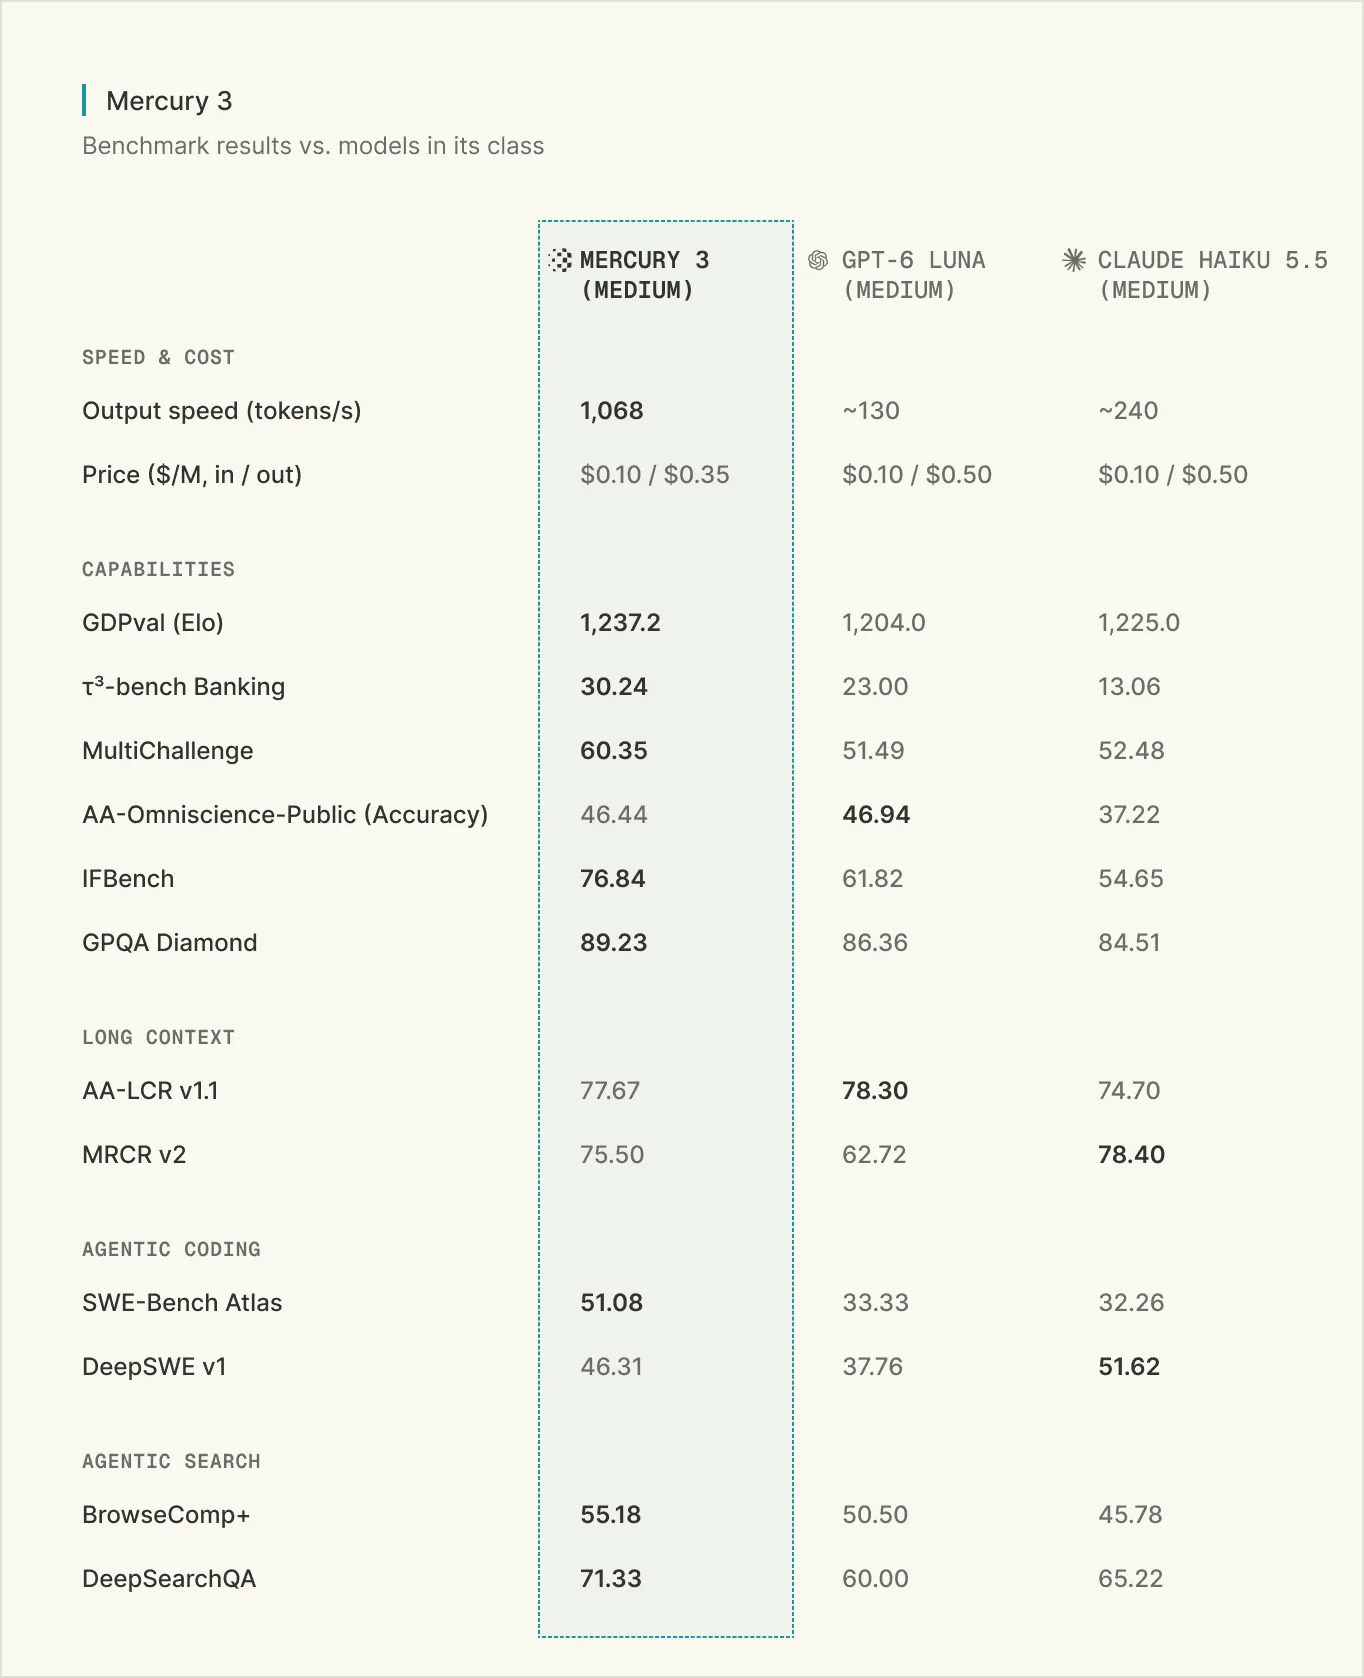
표의 속도와 가격만 옮기면 아래와 같다. 가격 열은 정가가 아니라 출시 할인가다.
| 항목 | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| 출력 속도 (tokens/s, 공식 주장) | 1,068 | ~130 | ~240 |
| 가격 ($/100만, 입력 / 출력, 할인가) | $0.10 / $0.35 | $0.10 / $0.50 | $0.10 / $0.50 |
품질 점수도 같은 이미지에 있고, 역시 Inception이 잰 공식 주장이다. 독립 리더보드 점수가 아니다. Mercury 3가 두 모델보다 숫자상 앞인 항목은 GDPval Elo 1,237.2, τ³-bench Banking 30.24, MultiChallenge 60.35, IFBench 76.84, GPQA Diamond 89.23, SWE-Bench Atlas 51.08, BrowseComp+ 55.18, DeepSearchQA 71.33이다. Luna가 앞인 항목은 AA-Omniscience 46.94 대 46.44, AA-LCR 78.30 대 77.67이다. Haiku 5.5가 앞인 항목은 MRCR v2 78.40 대 75.50, DeepSWE v1 51.62 대 46.31이다. 12개 품질 행 가운데 두 모델을 모두 넘긴 행은 8개다.
격차가 큰 공식 주장의 예는 IFBench 76.84 대 Haiku 5.5의 54.65, SWE-Bench Atlas 51.08 대 32.26, τ³ Banking 30.24 대 13.06이다. 이 표에 Gemini Flash 계열은 없다.
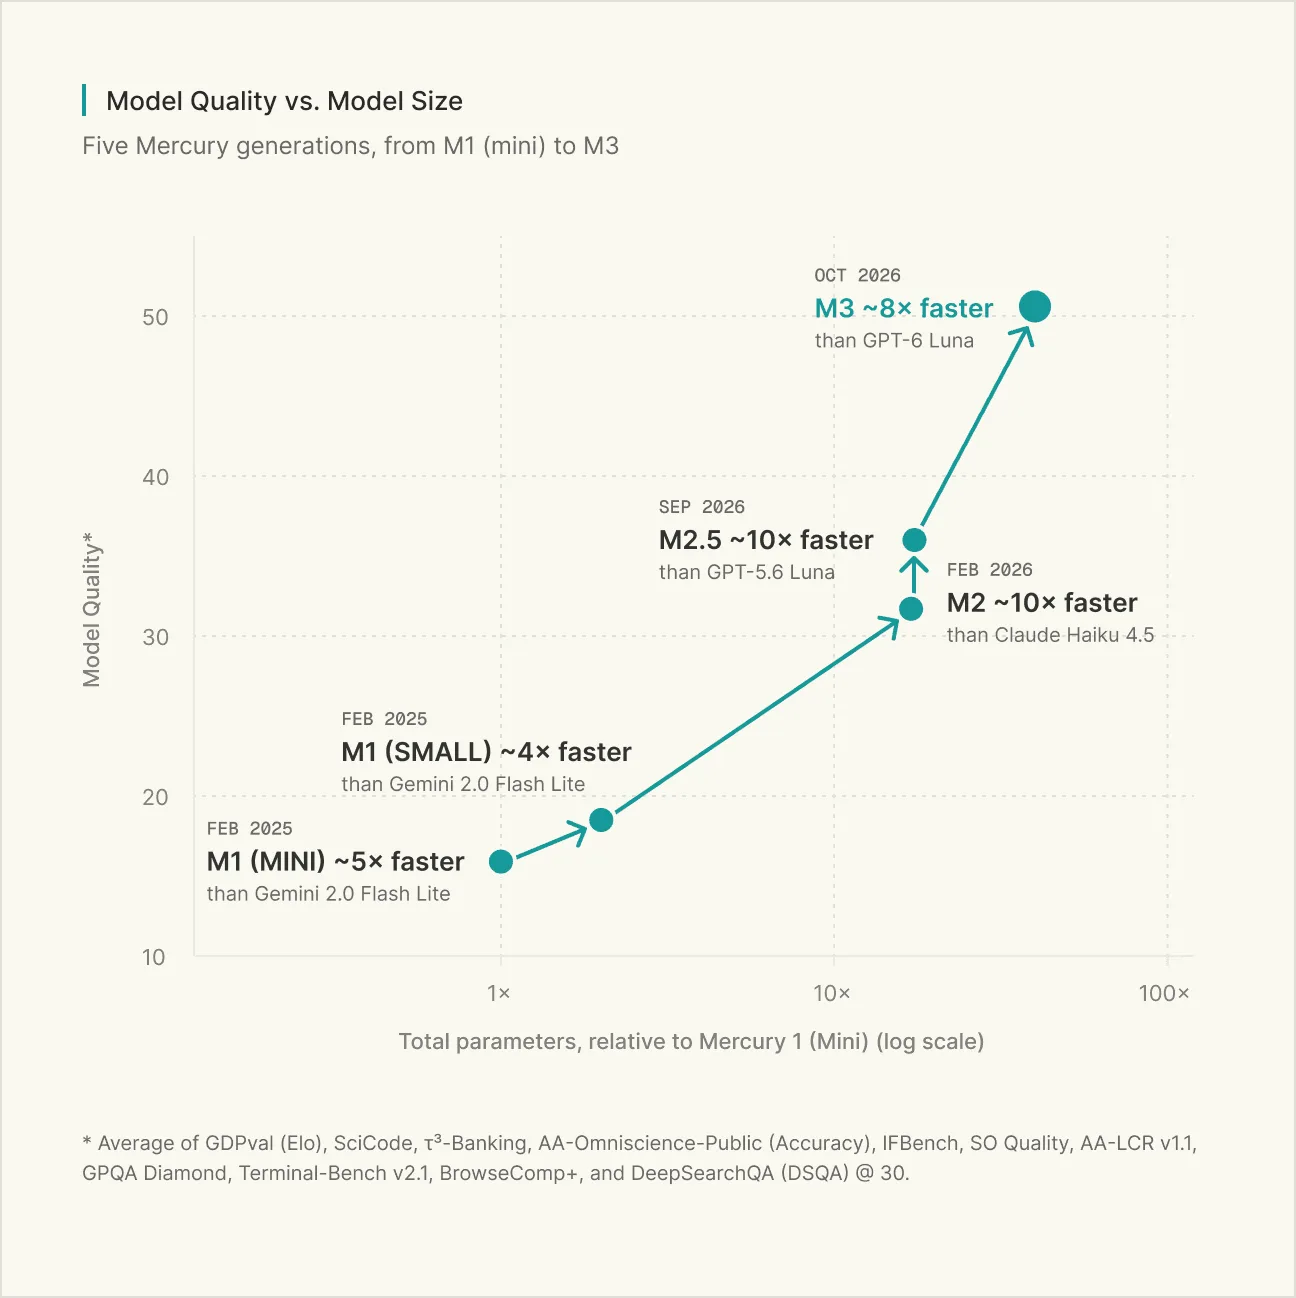
그래프는 M1 mini와 M1 small을 2025년 2월, M2를 2026년 2월, M2.5를 2026년 9월, M3를 2026년 10월로 찍는다. 세로축은 여러 벤치 점수의 평균이라고 각주에 적혀 있고, M3 옆 문구는 Luna 대비 약 8배다. 블로그 본문의 4배에서 8배와 같은 계열의 공식 주장이다. 절대 파라미터 수는 그래프에도 없다.
한국 PC에서 잰 속도
측정 조건은 이렇다. 2026년 10월 23일 03:45-03:57 한국 시간, 한국 Windows PC, Inception 공식 API, stream=true, 속도 프롬프트는 366자이고 실측 프롬프트 토큰은 81-83개, 출력은 영문 8단락을 유도했다. effort마다 3회다. instant의 max_completion_tokens는 1600이고, low와 medium과 high는 8000이다. 1600에서는 low 전부와 medium 일부, high 일부가 추론 토큰으로 한도를 채워 본문이 비었다. 그 회차는 아래 중앙값에서 뺐다. 각 칸은 그 열의 3회 가운데 값이다. 한 줄이 같은 한 번의 응답은 아니다. 본문 토큰을 전체 초로 나눈 값이 옆칸 tok/s와 어긋나는 이유가 그것이다.
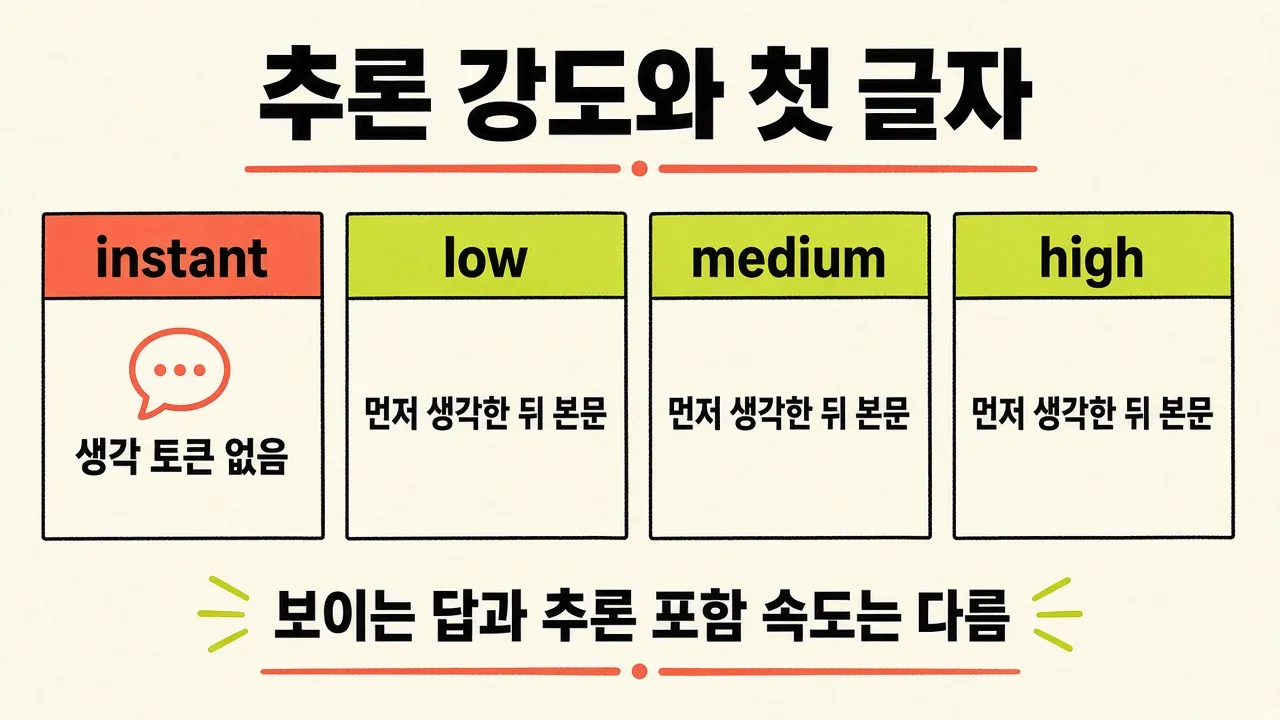
본문 토큰은 completion 토큰에서 reasoning 토큰을 뺀 값이다. tok/s (reasoning 포함)는 completion 토큰을 전체 초로 나눈 값이라, low 이상은 생각 토큰이 분자를 키운다. tok/s (본문만)은 화면에 해당하는 토큰만 전체 초로 나눈 값이다. 수신 본문 tok/s는 본문 토큰을, 첫 content 이후부터 스트림이 끝날 때까지의 시간으로 나눈 값이다. 첫 글자 전의 기다림은 이 세 번째 속도의 분모에 없다.
| effort | n | TTFT ms | 전체 s | completion | reasoning | 본문 | tok/s reasoning 포함 | tok/s 본문만 | 수신 본문 tok/s |
|---|---|---|---|---|---|---|---|---|---|
| instant | 3 | 557 | 1.79 | 629 | 0 | 629 | 277.1 | 277.1 | 418.4 |
| low | 3 | 4403 | 4.83 | 3752 | 3312 | 446 | 776.7 | 91.1 | 795.1 |
| medium | 3 | 3772 | 4.38 | 3271 | 2861 | 410 | 747.6 | 93.7 | 723.2 |
| high | 3 | 4080 | 4.66 | 3998 | 3537 | 461 | 717.9 | 98.9 | 721.5 |
instant는 추론 토큰이 0이다. reasoning 포함 속도와 본문만 속도가 같다. 중앙값 277.1토큰/초, 첫 글자까지 557ms, 전체 1.79초다. 공식 주장 1,068보다 낮다. 첫 글자 이후만 보면 수신 본문은 418.4토큰/초이고, 이것도 1,068보다 낮다.
low 이상은 분자에 생각 토큰이 많다. low 중앙값만 보면 completion 3752 가운데 reasoning이 3312이고, 화면에 해당하는 본문은 446이다. reasoning을 포함한 속도는 776.7토큰/초라 공식 주장에 가까워 보이지만, 보이는 답만 전체 시간으로 나누면 91.1토큰/초다. medium 본문만은 93.7, high 본문만은 98.9다. 수신 본문 tok/s가 다시 700대가 되는 이유는 생각하느라 첫 글자 전에 쓴 시간이 분모에서 빠지기 때문이다. 사람이 기다리는 전체 시간은 그 첫 글자 시간을 포함한다.
low의 첫 글자 중앙값은 4403ms, medium은 3772ms, high는 4080ms다. 개별 회차는 더 벌어진다. high 2회차는 첫 글자까지 7394ms, 전체 8.07초였다. effort를 올린다고 이 PC에서 보이는 답이 더 빨라지지는 않았다. 본문만 속도는 91에서 99 사이에 머물렀다.
긴 입력 요약과 기본 작업
긴 입력은 두 번 불렀다. 1차는 프롬프트 13,420토큰, max_completion_tokens 600, medium이었다. 추론이 한도를 채워 본문이 비었다. 같은 종류의 입력을 8,192 한도로 다시 부르니 HTTP 200, finish는 stop, 전체 4.02초였다. 프롬프트 8,804토큰, completion 2,047, reasoning 1,982, 본문 65토큰, 108자였다. 요약은 사실 세 줄을 유지했다. 창고 번호 4821, 파란 우산은 세 번째 선반, 회의는 화요일 오전 7:15였다.
기본 작업 다섯 가지는 medium, 스트림 없음, 1회다. 요약 원문은 471자였다.
| 작업 | 초 | prompt | completion | reasoning | 결과 |
|---|---|---|---|---|---|
| a 음슴체 5줄 | 0.99 | 97 | 241 | 80 | 5줄, 끝맺음 함/임 5개 |
| b PowerShell | 1.93 | 140 | 1055 | 671 | 날짜 폴더, 덮어쓰기 회피, 로그. 앞뒤에 마크다운 펜스 |
| c 3줄 요약 | 0.90 | 352 | 241 | 99 | 가속, 정지 금지, 비와 밤, 합류 후 간격을 3줄에 담음 |
| d 상자 퍼즐 | 1.60 | 167 | 543 | 438 | 사과 라벨은 오렌지만, 오렌지 라벨은 혼합, 사과와 오렌지 라벨은 사과만. 정답과 같음 |
| e JSON | 0.89 | 284 | 230 | 111 | title, steps 3개, risk=mid. 스키마 통과 |
e의 1번 단계는 "합류 전 깜빡이를 켜고 속도를 줄인다"였다. 고속도로 합류에서 속도를 줄이라는 문장은 가속 차로의 내용과 어긋난다. 칸 형식은 맞았고, 조언의 내용은 한 칸이 어색했다.
HTML 조각은 node --check 종료 코드 0, 0.64초였다. 영문 한 단락의 한국어 번역은 0.83초였고, 숫자와 모델 이름을 유지했다. 이 두 호출은 응답 파일만 남고 usage JSON이 없어 가격 표에서 뺐다. 도구 호출은 get_temperature에 도시 Seoul을 넣어 0.41초에 끝났다.
작업마다 든 돈
출력 단가는 completion 토큰 전체에 곱했다. reasoning이 포함된다. 할인가 $0.10 / $0.35, 정가 $0.20 / $0.70, 단위는 100만 토큰이다. usage에 cost 필드는 없었다. 계정은 무료 토큰이라 아래는 공개 단가 환산이다.
| 작업 | prompt | completion | 할인 USD | 정가 USD |
|---|---|---|---|---|
| 속도 instant 3회 합 | 244 | 1795 | 0.000653 | 0.001305 |
| 속도 low 3회 합 | 245 | 11624 | 0.004093 | 0.008186 |
| 속도 medium 3회 합 | 246 | 9641 | 0.003399 | 0.006798 |
| 속도 high 3회 합 | 246 | 12089 | 0.004256 | 0.008511 |
| 기본 a | 97 | 241 | 0.000094 | 0.000188 |
| 기본 b | 140 | 1055 | 0.000383 | 0.000767 |
| 기본 c | 352 | 241 | 0.000120 | 0.000239 |
| 기본 d | 167 | 543 | 0.000207 | 0.000413 |
| 기본 e | 284 | 230 | 0.000109 | 0.000218 |
| tools 1회 | 293 | 70 | 0.000054 | 0.000108 |
| 긴 요약 max 8192 | 8804 | 2047 | 0.001597 | 0.003194 |
| 합계 | 0.014963 | 0.029927 |
속도 측정에서 low 이상 3회가 비싼 이유는 본문이 길어서가 아니다. completion 1만 토큰 안팎의 대부분이 reasoning이었다. instant 3회 합은 할인 기준 0.000653달러, low 3회 합은 0.004093달러다. 같은 프롬프트라도 effort를 올리면 보이는 답 길이와 별개로 청구 토큰이 커진다. HTML과 번역은 usage가 없어 합계에 없다.
OpenCode에서 부르는 이름
OpenCode의 모델 id는 공식 API의 mercury-3가 아니라 inception/mercury-3다. 단독 실행은 --standalone을 붙인다. 키 값은 문서에 적지 않는다. 환경 변수 이름은 INCEPTION_API_KEY다.
필자가 그 플래그로 한 번 실행했을 때 3.26초, 종료 코드 0이었다. 만들어진 파일 mercury-hello.txt의 내용은 mercury-ok뿐이었다.
호출 형태는 다음 한 줄이다. 따옴표 안은 요청 문장 자리다.
opencode run --standalone -m inception/mercury-3 "요청 문장"출시 직후 공개 반응
출시 직후 X에서 직접 써 본 글은 뉴스 재게시보다 적다. 링크가 있는 글만 골랐다.
daniel_mac8은 같은 프롬프트, medium에서 Haiku 5.5가 8.0초, OpenRouter의 Mercury 3가 4.3초였다고 적었다. deedydas는 공식의 4배에서 8배 대신, OpenRouter 실사용으로는 2배에서 4배 빠르고 유효 가격도 그 정도라고 보정했다. tarekalaaddin은 공식 1,068과 OpenRouter 측정 221을 나란히 적었다. codenameposhan은 자사 표 기준 12개 중 8개 우위라고 하면서, 당시 OpenRouter 수치는 383 tok/s였다고 적었다.
코딩 쪽에서는 CoreyNoles가 단일 파일 던전 크롤러가 동작했고 맵 조건 무작위 검사 2,000회를 통과했다고 적었다. 벤치는 자사 발표라는 단서를 달았다. lawsonelliott는 1,000 tok/s에는 못 미치지만 빠르고, 문체에 에이전트 말투가 섞여 7/10이며, 맡긴 코딩은 다 해냈다고 했다. trypalomino의 3D 벤치 4종에서는 Mercury가 출력 토큰을 약 80% 적게 쓰고 24% 빨랐다(231 tps 대 187). 장면 디테일은 Haiku가 더 좋았다고 적었다. nameles45390088은 써 본 모델 중 가장 빠른데 답의 수준이 무너지지는 않았다고 했다.
불만도 링크가 있다. emmetics는 모델은 좋은데 OpenRouter에서 200 tps 수준은 아쉽다고 했다. promovier는 빠르고 가격은 낮은데 안전 필터가 무해한 주제까지 거절한다고 했다. GillelandKristi는 공식 채팅 화면에서 모바일 다운로드 버튼이 동작하지 않고 긴 턴에 네트워크 오류가 있었다고 하면서, 모델의 웹 코딩은 빠르고 좋았다고 적었다. sagguts는 정가 기준으로는 Haiku 5.5보다 비싸고, 할인 기간의 출력만 약간 낮다고 가격을 비교했다. m_t_ramkrushna는 벤치가 medium인데 API 기본값이 low라고 짚었다.
Hacker News에서 Simon Willison은 펠리컨 SVG가 3,337ms였고, 속도가 기대보다 낮아 OpenRouter를 거치지 않은 API를 다시 불러도 더 빨라지지는 않았다고 적었다. 해당 댓글은 이 스레드에 있다.
OpenRouter 모델 페이지를 2026년 10월 23일에 열어 보면, 처리량 P50은 최고 공급자 기준 336 tok/s, 1주 평균은 P50 246, P75 163, P90 104, P95 77, P99 37 tok/s였다. 지연 P50은 1.04초, 끝까지 P50은 2.45초, 끝까지 P99는 75.27초였다. eesel AI가 10월 20일 같은 페이지를 캡처한 글은 P50 221 tok/s, P99 27 tok/s, 끝까지 P99 69.50초였다. 페이지 숫자는 매일 바뀐다. 필자의 공식 API instant 277 tok/s와, low 이상에서 보이는 답 약 90토큰/초는 이 제3자 구간과 공식 1,068 사이에 따로 놓인다. 끝까지 P99가 길다는 점은, 에이전트가 같은 모델을 여러 번 부를 때 느린 한 번이 전체 시간을 잡아먹는다는 뜻이다.
마무리
앞에서 다룬 Mercury 3의 핵심만 짧게 정리한다.
- Mercury 3는 여러 토큰을 같이 다듬는 확산 언어 모델이고, 컨텍스트는 100만 토큰이다.
- 출시 할인은 입력 $0.10, 출력 $0.35이다. 정가는 $0.20, $0.70이고 종료일은 공개되지 않았다.
- 1,068토큰/초와 Luna, Haiku 5.5 대비 4배에서 8배는 공식 주장이다. 필자는 그 두 모델을 호출하지 않았다.
- 한국 PC 공식 API에서 instant 중앙값은 첫 글자 557ms, 본문 277.1토큰/초였다.
- low 이상은 reasoning 포함 시 700토큰/초대로 보이지만, 보이는 답만 전체 시간으로 나누면 약 91에서 99토큰/초였다.
- diffusing은 스트리밍에서만 동작했고, 출력 한도가 짧으면 추론이 본문을 비웠다.
「보이는 답의 속도와, 추론 토큰을 포함한 속도는 다른 숫자다」
출력 한도가 추론으로 차면 본문이 빈다. OpenCode에서는 모델 id inception/mercury-3와 --standalone이 맞았다.
출처와 링크
조사 기준은 2026년 10월 23일이다. 공식 주장과 필자 실측을 구분했다.
FAQ
자주 묻는 질문
캐시된 입력 토큰 단가는 얼마인가?
모델 문서는 캐시된 입력을 입력 단가에서 90% 뺀 금액으로 적는다. 출시 할인가로 보면 100만 토큰당 $0.01이고, 정가 기준으로는 $0.02이다. OpenRouter 모델 API를 2026년 10월 23일에 조회하면 cache read가 토큰당 $0.00000001로 할인가와 맞다.
한 번 응답의 최대 출력 토큰은 얼마인가?
OpenRouter 모델 API와 Inception 문서는 최대 완성 토큰을 131,072로 적는다. 컨텍스트 창 100만 토큰과 같은 상한이 아니다. 필자의 긴 요약은 그 상한보다 짧은 8,192 한도로 다시 부른 호출이다.
OpenRouter 등록일과 공식 발표일은 같은가?
OpenRouter 페이지는 Released Oct 16, 2026으로 표시하고, 모델 created 값 1792158337은 2026-10-16 13:45 UTC에 해당한다. 블로그 목록과 Business Wire의 발표 시점은 2026-10-19이다. 본문의 기준일은 공식 발표일이다.
temperature와 이미지 입력은 어떻게 되나?
추론 문서의 temperature 범위는 0.5에서 1.0이다. 지원 입력은 텍스트이고, 이미지 모달은 OpenRouter 페이지의 입력 목록에 없다. 도구 호출과 JSON 스키마 출력은 같은 문서에 지원 항목으로 적혀 있다.
Mercury Voice와 Mercury Decide도 같은 단가인가?
블로그가 같이 소개한 Mercury Voice는 음성용이고, 첫 답 토큰까지의 시간을 줄이는 쪽이며 엔터프라이즈로 제공된다. 문서의 Voice 출시 할인가는 입력 $0.20, 출력 $0.75이다. Mercury Decide는 분류와 추출용으로 입력만 100만 토큰당 $0.02를 매긴다.
유럽 리전 라우팅은 켜져 있나?
2026년 10월 23일 OpenRouter 페이지는 EU 인리전 라우팅을 미지원으로 표시했다. 같은 날 페이지의 3일 가용성은 99.59%였다. 가용성 숫자는 집계 기간이 지나면 바뀐다.
Design Arena 점수는 어디에 적혀 있나?
OpenRouter 페이지는 Design Arena Elo로 Code 1232, Data Viz 1187, Game Dev 1225, UI Component 1249, Website 1230을 적는다. 이 점수는 블로그 GDPval 표와 다른 제3자 항목이다. 수집일은 2026년 10월 23일이다.
가중치를 내려받을 수 있나?
블로그와 문서는 가중치 파일이나 오픈 웨이트를 안내하지 않고 API 호출만 적는다. 40배라는 말은 Mercury 1 대비 상대 크기다. 절대 파라미터 개수는 블로그 문장과 그래프 축에 숫자로 나오지 않는다.
용어
관련 용어
LLM이 텍스트를 처리하는 기본 단위로, AI 모델의 비용 산정과 성능을 이해하는 데 가장 기본이 되는 개념이다. 토크나이저(tokenizer)라는 알고리즘이 텍스트를 토큰으로 분할하며, 단어 하나가 반드시 토큰 하나가 되는 것은 아니다. 영어의 경우 대략 단어 1개 ≈ 1~1.5 토큰이지만, 한국어는 음절 단위로 분할되어 같은 의미의 텍스트가 영어보다 2~3배 많은 토큰을 소비한다(예: '안녕하세요' ≈ 3~5 토큰). 코드의 경우 'console.log("Hello World")' ≈ 약 6토큰이다. 토큰은 AI 코딩 도구의 사용량과 비용을 결정하는 핵심 단위로, API 과금은 입력 토큰과 출력 토큰을 각각 계산한다. 모델마다 다른 토크나이저를 사용하므로, 같은 텍스트도 모델에 따라 소비하는 토큰 수가 다를 수 있다. 바이브 코딩에서 예상보다 비용이 높아지는 주요 원인이 토큰 소비이므로, 컨텍스트 엔지니어링을 통해 불필요한 토큰 소비를 줄이는 것이 비용 관리의 핵심이다.
AI 모델·프로바이더 GPTOpenAI가 개발한 생성형 사전훈련 트랜스포머(Generative Pre-trained Transformer) 모델 시리즈로, 현대 AI 혁명의 핵심 기술이다. 'Transformer'는 2017년 Google이 발표한 신경망 아키텍처이며, GPT는 이를 '생성(Generative)' 목적으로 '사전 훈련(Pre-trained)'시킨 모델이다. ChatGPT, Codex CLI, GitHub Copilot 등 수많은 AI 제품의 기반이 되며, GPT-4, GPT-4o(최적화 버전), o1(추론 특화), o3(고급 추론) 등 다양한 변형이 존재한다. GPT-4는 코드 생성에서 높은 범용성을 보이며, o1/o3 시리즈는 복잡한 논리적 추론이 필요한 알고리즘 문제에 강점이 있다. Cursor, GitHub Copilot, Windsurf 등 대부분의 AI 코딩 도구에서 기본 모델로 제공되며, OpenAI API를 통해 직접 호출할 수도 있다. 바이브 코딩 생태계에서 Claude와 함께 가장 빈번하게 사용되는 모델이며, 특히 GPT-4o는 빠른 응답 속도와 적절한 코드 품질의 균형으로 일상적 코딩 작업에 널리 활용된다.
성능·최적화 지연시간요청을 보낸 후 응답을 받기까지 걸리는 시간으로, AI 코딩 도구에서는 프롬프트를 전송한 후 코드가 생성되기 시작할 때까지의 대기 시간을 의미한다. 밀리초(ms)에서 수 초(s)까지 다양하며, 개발자의 작업 흐름과 생산성에 직접적 영향을 미친다. AI 모델의 지연시간은 여러 요인에 의해 결정된다: 모델 크기(파라미터 수가 많을수록 느림), 입력 토큰 수(컨텍스트가 길수록 느림), 출력 토큰 수(긴 응답일수록 느림), 서버 부하(동시 사용자 수), 네트워크 거리(API 서버 위치). 바이브 코딩에서의 트레이드오프: Claude Opus 4.6은 가장 정확한 코드를 생성하지만 응답이 느리고, Codex mini나 Claude Sonnet은 빠르지만 복잡한 작업에는 부족하다. 이로 인해 많은 개발자가 '빠른 모델로 초안 생성 → 정확한 모델로 검증·수정'이라는 이중 모델 전략을 사용한다. 스트리밍 응답(streaming)은 전체 응답을 기다리지 않고 토큰이 생성되는 대로 표시하여 체감 지연을 줄이는 기법이며, 대부분의 AI 코딩 도구에서 기본으로 사용된다.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
딥시크 API 싸게 쓰는 곳 | V4.1 Flash, V4 Pro 가격과 데이터 무보관 제공사 비교
딥시크(DeepSeek)는 중국 항저우의 AI 회사이자, 그 회사가 만든 대형 언어 모델 이름이에요. 모델 가중치를 공개하는 오픈 웨이트 방식이라 딥시크 본사 말고도 미국, 싱가포르, 중국, 국내의 여러 회사가 같은 모델을 자기 서버에 올려 API로 팔아요. 그래서 같은 딥시크를 쓰더라도 어디서 부르느냐에 따라 가격이 몇 배씩 차이 나고, 내가 보낸 코드와 대화가 어느 나라 서버에 남는지도 달라져요.
여기서 API는 프로그램이 인터넷으로 모델을 불러 쓰는 연결 창구이고, 요금은 토큰 단위로 매겨져요. 토큰은 모델이 글을 읽기 위해 잘게 자른 조각으로, 보통 단어보다 작은 단위예요. OpenCode나 Cursor 같은 코딩 도구에 API 키를 넣고 딥시크를 코딩 에이전트로 쓰면, 에이전트가 파일을 읽고 고칠 때마다 코드 전체가 토큰으로…
뮤즈 원더와 뮤즈 스파크 1.3 | 한국에서 커서, 오픈라우터로 쓰는 법, 가격, 벤치마크
Muse Spark 1.3과 Muse Wonder는 Meta가 만든 AI 언어 모델이다. 둘 다 질문과 자료를 받아 글로 답한다. 이미지를 그려 주거나 영상을 만들어 주는 모델이 아니다. 그림을 만드는 모델은 따로 있고, 이름은 Muse Image다.
쓰는 자리도 나뉜다. Spark 1.3은 코딩과 도구를 여러 단계로 쓰는 일을 낮은 비용으로 처리하는 중간급 모델이다. Wonder는 더 큰 프런티어 모델로, 긴 코딩과 컴퓨터 조작, 개인과 업무용 에이전트를 겨냥한다. Wonder Full은 같은 날 나온 더 강한 변형이며, Muse Code 구독 안에서만 고른다.
Spark 1.3은 2026년 9월 2일에 나왔다. Wonder와 Wonder Full은 2026년 10월 12일에 나왔다. 만든 곳은 Meta Superintellig…