바이브코딩
극가성비 AI API KIE 에이전트 서비스 출시 | kie-models·채팅 에이전트 스킬
코딩 에이전트가 문서 없이 KIE 마켓과 채팅 모델을 쓰게 하는 kie-models·kie-chat-agents 스킬
KIE는 이미지, 영상, 음악, 음성, 채팅 모델을 한 크레딧 지갑으로 쓰는 AI API 마켓이다. 공식 문서와 홈은 자체 모델을 새로 만든 회사라기보다, 여러 벤더의 모델을 낮은 단가로 묶고 비동기 태스크 API로 제공하는 쪽에 가깝다. 개발자가 쓰는 화면은 마켓, 플레이그라운드, 로그, API 키 관리다.
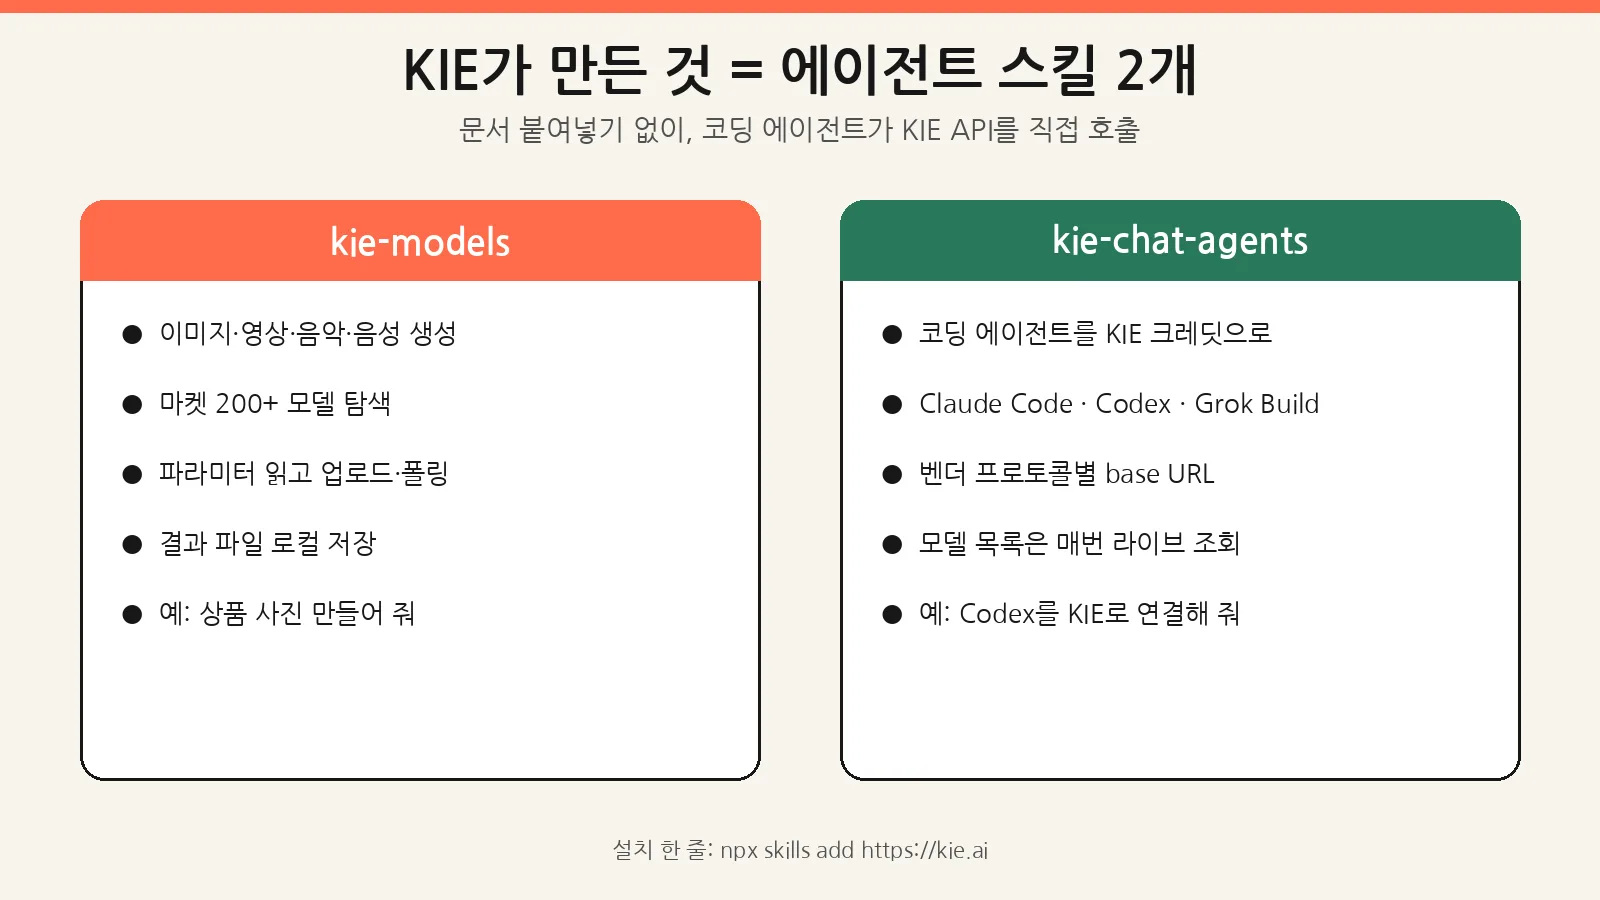
2026년 기준으로 KIE가 코딩 에이전트용으로 내놓은 것은 에이전트 스킬 두 개다. 스킬은 에이전트가 스스로 읽어 들이는 짧은 지시 묶음이다. 설치해 두면 채팅에 공식 문서를 붙여 넣지 않아도, 말로 요청하면 에이전트가 KIE API 호출, 파라미터 확인, 결과 저장까지 처리한다.
대상은 Claude Code, Codex, Grok Build처럼 스킬을 지원하는 코딩 에이전트를 쓰는 사람이다. 앱에 생성 API를 붙이거나 상품컷, 영상, 음성을 바로 뽑을 때, 또는 코딩 에이전트 자체를 KIE 크레딧 과금으로 돌리고 싶을 때 이 서비스가 맞다. 아래는 docs.kie.ai AI Agent 섹션과 설치·트러블슈팅 페이지를 2026년 10월 1일 기준으로 읽은 내용이다.
이게 뭐하는 건가
KIE 에이전트 서비스는 코딩 에이전트가 KIE 마켓과 채팅 모델을 쓰도록 돕는 설치형 스킬 묶음이다. 한 줄로 말하면, 문서 복붙 없이 에이전트가 KIE를 호출하게 만드는 안내서다.
쉬운 특징으로 보면 이렇게 정리된다. 첫째, 설치 명령이 하나다. npx skills add https://kie.ai 한 번이면 kie-models와 kie-chat-agents가 같이 들어온다. 둘째, 키는 프로젝트 파일이 아니라 KIE_API_KEY 환경변수만 본다. 셋째, kie-models는 이미지, 영상, 음악, 음성을 찾아 돌리고 파일을 받아 준다. 넷째, kie-chat-agents는 Claude Code, Codex CLI, Grok Build를 KIE 채팅 모델과 크레딧에 맞춘다. 다섯째, 모델 이름은 기억하지 말고 매번 라이브 목록에서 읽도록 스킬이 유도한다.
공식 Overview는 스킬을 "에이전트가 스스로 로드하는 작은 지시 집합"이라고 정의한다. 요청 문장에 따라 에이전트가 어느 스킬을 쓸지 고른다. 생성 요청이면 kie-models, 에이전트 설정·모델 목록이면 kie-chat-agents 쪽으로 흐른다.
핵심 포인트: KIE가 새로 만든 핵심은 모델 자체보다, 코딩 에이전트가 마켓·채팅 API를 문서 없이 다루게 하는 두 스킬이다.
지금 당장 알아둘 것
요금은 모델별 고정 월정액이 아니라 KIE 크레딧이다. API를 직접 호출할 때와 같은 지갑에서 차감되고, 호출 기록은 kie.ai/logs에 남는다. Getting Started는 공식 API 대비 대체로 30~50% 낮은 가격대, 일부는 최대 80%까지 할인될 수 있다고 적는다. 홈 FAQ는 신규 사용자에게 테스트용 80 무료 크레딧, 실패 태스크는 과금하지 않음, 크레딧 만료 없음을 안내한다. 에이전트 스킬 자체의 별도 구독가는 공개 문서에 없다. 모델별 최신 단가는 kie.ai/pricing을 봐야 한다.
키는 kie.ai/api-key에서 만들고 KIE_API_KEY로보낸다. macOS·Linux는 export, Windows PowerShell은 $env:와 setx를 같이 쓰는 예가 문서에 있다. setx는 이후에 연 창에만 적용되므로, 지금 쓰는 터미널에는 $env:도 필요하다.
생성 결과 파일은 서버에 14일 보관된 뒤 삭제된다. 로그 메타데이터는 약 2개월이다. kie-models 흐름에서는 에이전트가 결과를 로컬 경로로 받아 두므로, 링크가 만료돼도 받은 파일은 남는다.
인증 헤더는 항상 Authorization: Bearer다. 헤더 이름이 apikey이면 401이다. Claude Code는 ANTHROPIC_AUTH_TOKEN에 원시 키만 넣고, Bearer 접두사는 에이전트가 붙인다.
에이전트 기능에는 시리즈 최신 모델을 쓰라는 경고가 있다. 오래된 모델 중 일부는 채팅만 지원하고 Market 페이지에 Chat only로 표시된다. 그런 모델을 에이전트에 물리면 오류나 이상한 결과가 날 수 있다. 각 에이전트가 쓸 수 있는 목록은 해당 에이전트 전용 모델 리스팅 엔드포인트다.
두 스킬이 나누는 일
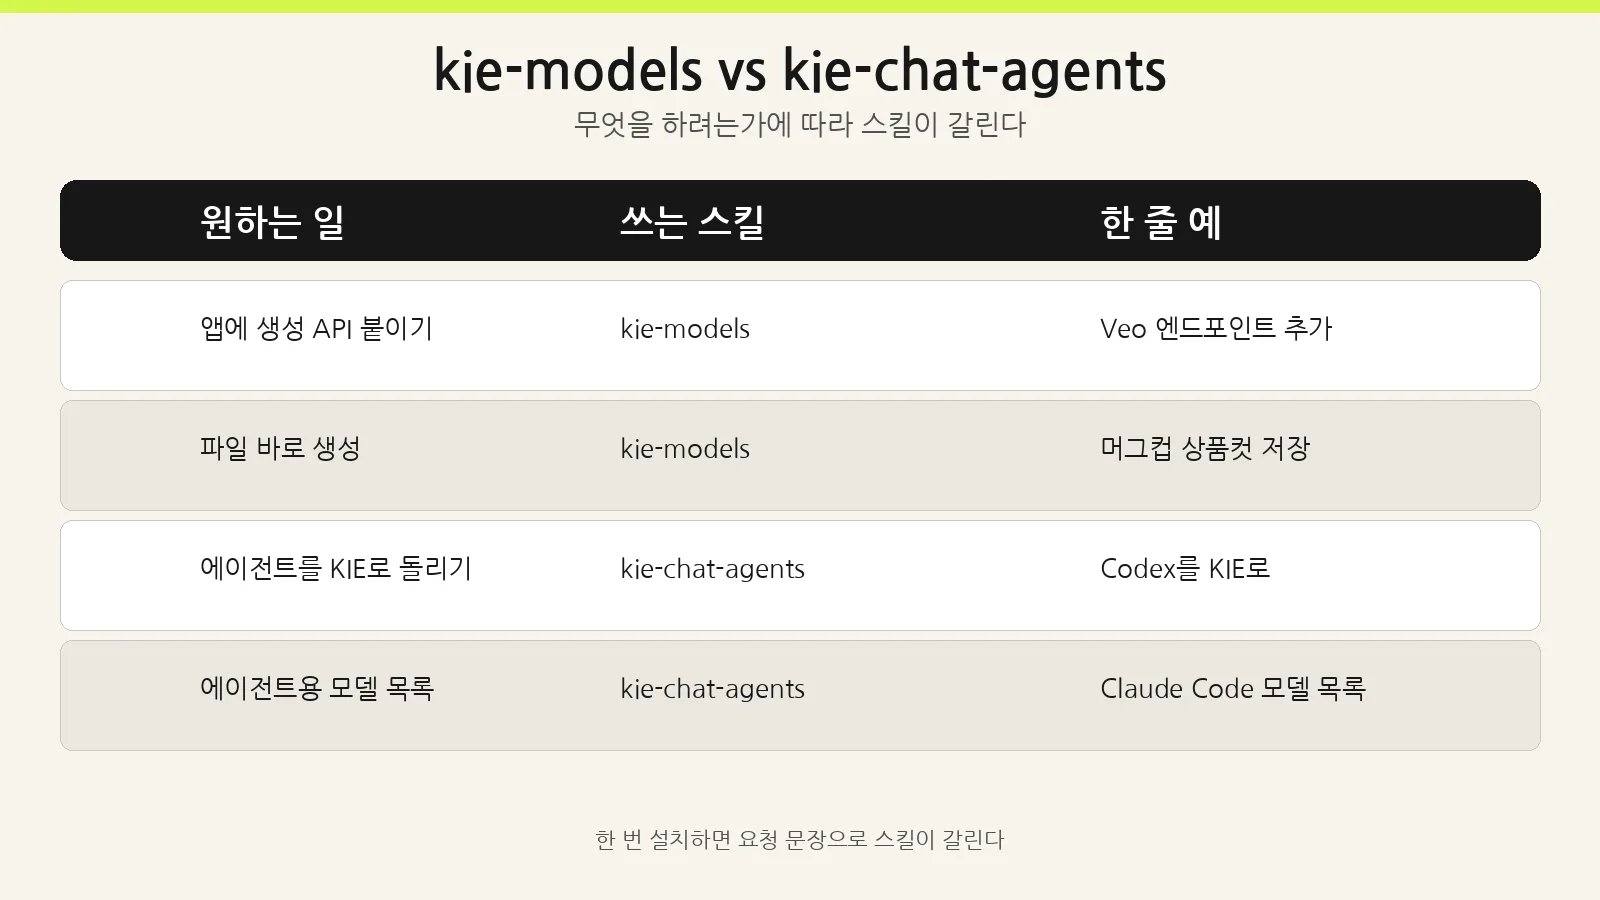
Overview의 선택 표를 한국어로 옮기면 아래와 같다.
| 하려는 일 | 스킬 | 요청 예 |
|---|---|---|
| 앱에 이미지, 영상, 음악, 음성 생성 붙이기 | kie-models | Veo 3.1 영상 엔드포인트를 API에 추가해 줘 |
| 파일을 바로 생성해 저장 | kie-models | GPT Image 2로 1:1 머그컵 상품컷을 ./public에 저장 |
| Claude Code, Codex, Grok Build를 KIE 크레딧으로 | kie-chat-agents | Codex를 KIE로 설정해 줘 |
| 에이전트가 쓸 수 있는 모델 목록 확인 | kie-chat-agents | Claude Code가 KIE에서 쓸 모델 목록 |
kie-models는 마켓의 200+ 생성 모델을 대상으로 한다. 유형은 Image, Video, Music, Speech다. kie-chat-agents는 채팅·코딩 에이전트 쪽이다. 지금까지 문서가 다루는 에이전트는 Codex CLI, Claude Code, Grok Build 세 가지다. 다른 에이전트는 이후에 같은 형식으로 붙일 예정이라고만 적혀 있다.
한 명령으로 둘 다 설치되므로, "어떤 스킬만 깔아야 하나"로 고민할 필요는 적다. 요청 문장이 생성인지 에이전트 설정인지에 따라 로드되는 쪽이 달라진다.
kie-models의 FIND에서 SAVE까지
kie-models가 에이전트에게 가르치는 순서는 다섯 단계다. FIND에서 라이브 모델 목록을 검색하고, READ에서 그 모델의 파라미터와 허용값, 기본값을 읽는다. UPLOAD에서는 디스크의 입력 이미지, 영상, 음성이 필요하면 KIE에 올려 호스팅 URL을 넘긴다. RUN에서 태스크를 제출하고 성공할 때까지 폴링한다. SAVE에서 요청한 경로로 결과를 받는다.
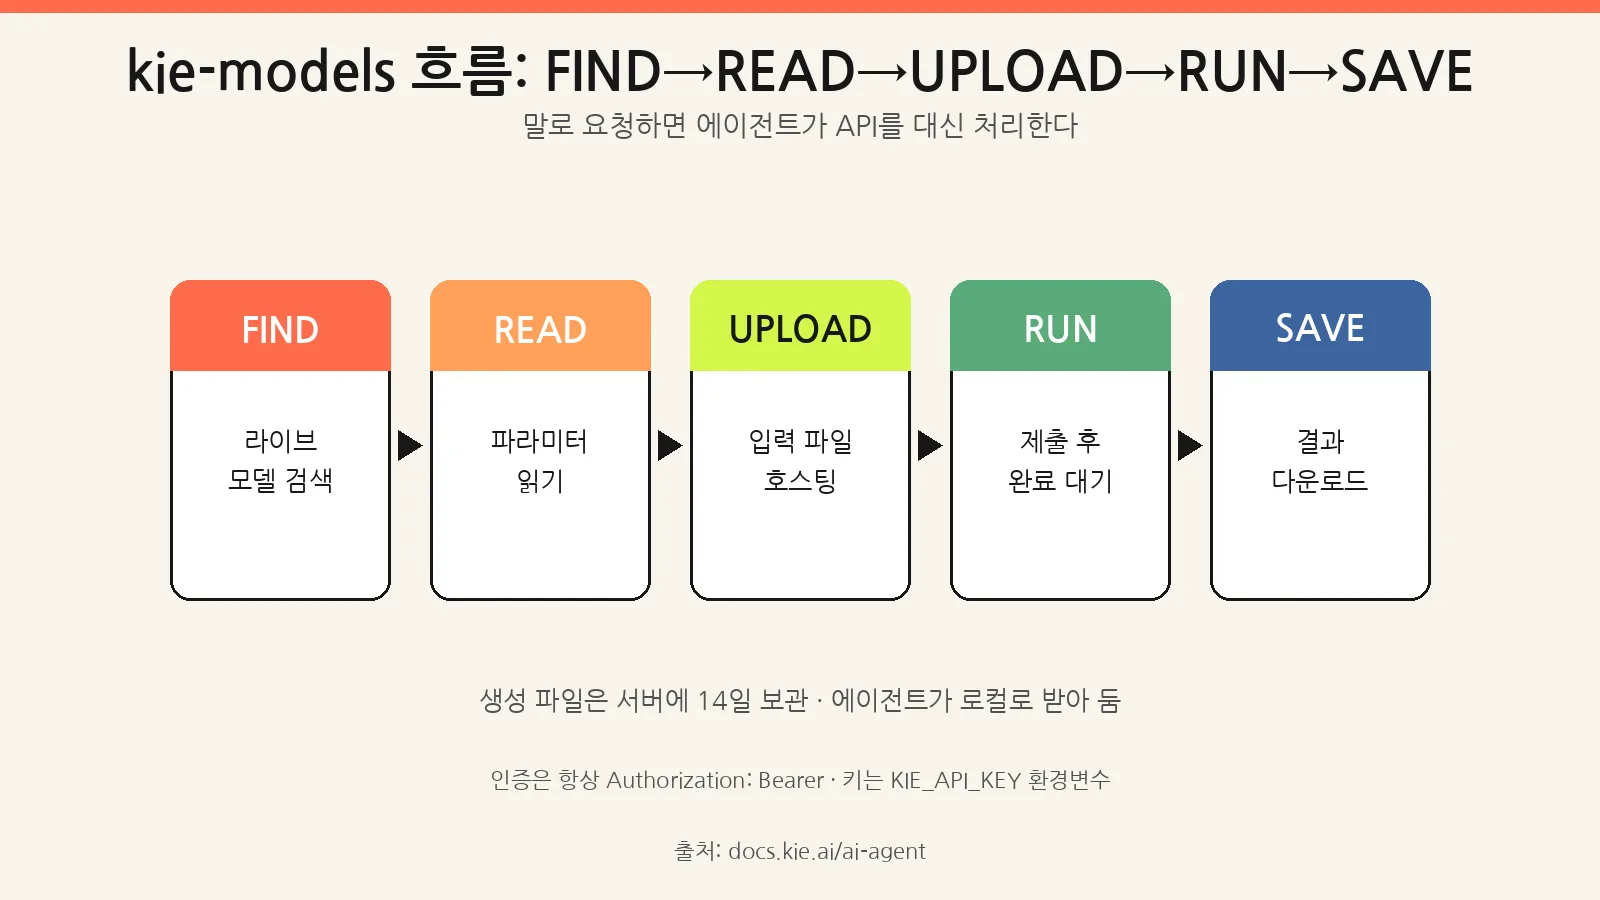
문서 예시는 이렇게 말한다. "GPT Image 2로 흰 세라믹 머그컵 1:1 상품컷을 ./public에 저장해 줘"라고 하면, 에이전트가 모델을 찾고 gpt-image-2-text-to-image 파라미터를 읽은 뒤 태스크를 넣고, 끝나면 이미지를 ./public에 둔다.
좋은 요청에는 저장 경로, 쓰고 싶은 모델 이름, 비율, 해상도, 길이, 보이스처럼 신경 쓰는 파라미터, 그리고 일회성 파일이 아니라 앱 연동이면 "내 API에 엔드포인트를 추가해 줘" 같은 말이 들어간다. 빼 둔 값은 모델 기본값을 쓴다.
설치 전제는 스킬을 지원하는 코딩 에이전트, Node.js(npx), KIE API 키다. 설치 후 에이전트를 키 변수가 있는 셸에서 다시 시작한 다음, 평문으로 첫 생성을 시키면 된다. Install 페이지의 예시 프롬프트는 gpt-image-2-text-to-image, 1:1, 1K, ./output 저장이다.
kie-chat-agents와 세 프로토콜
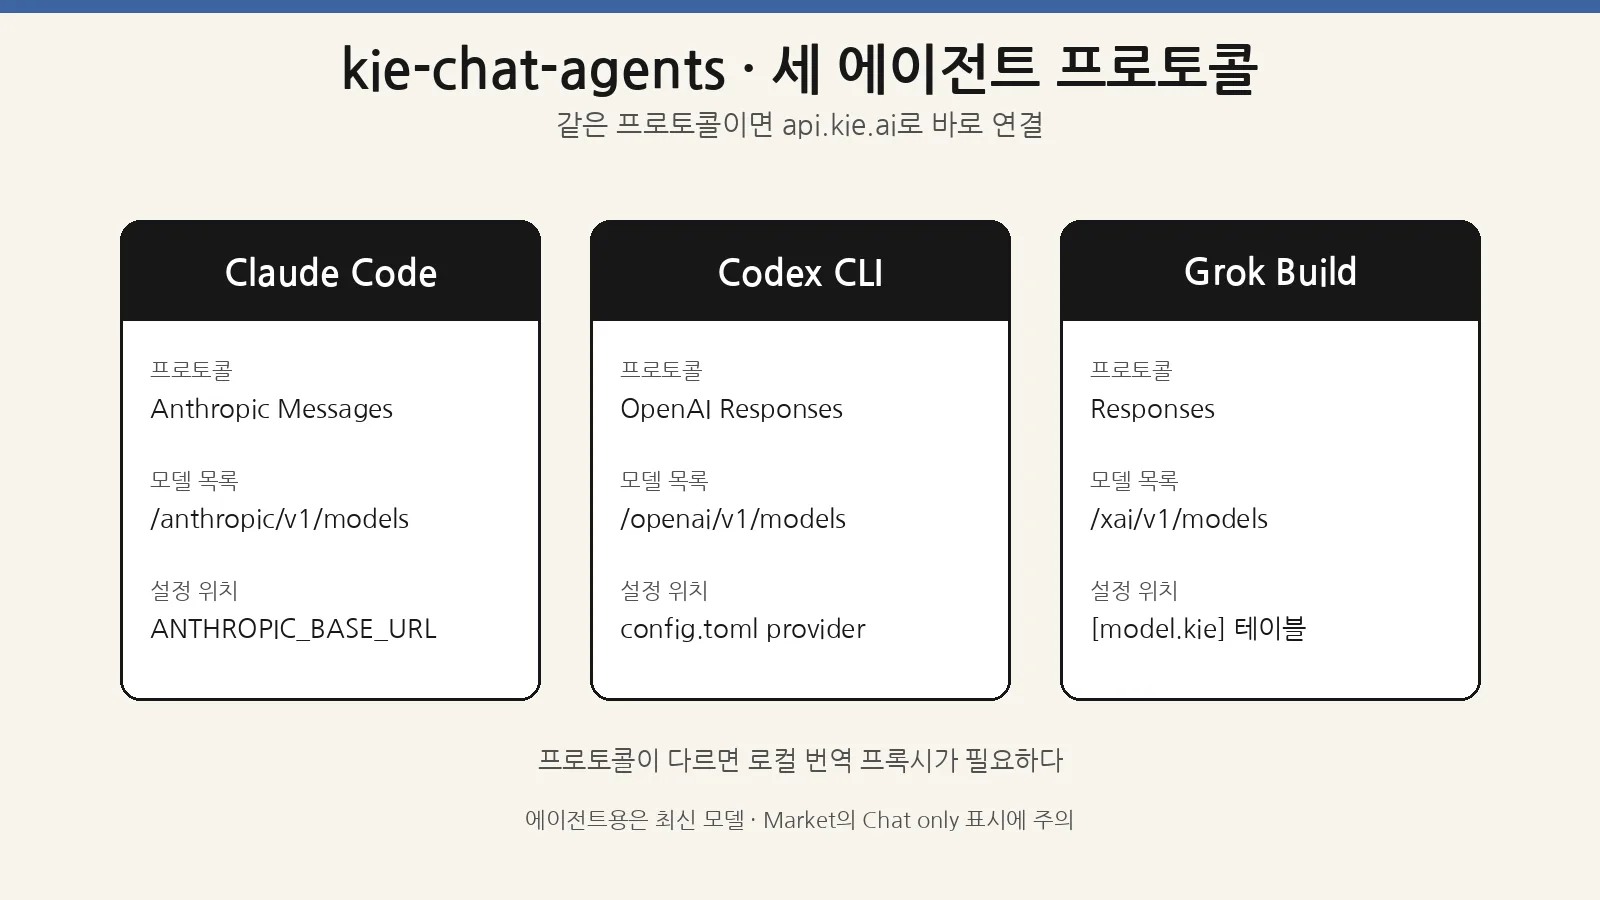
KIE는 채팅 모델을 벤더별 와이어 프로토콜로 그대로 제공한다. 에이전트가 말하는 프로토콜과 모델 쪽 프로토콜이 같으면 api.kie.ai로 바로 연결하고 어댑터가 필요 없다. 다르면 로컬 번역 프록시가 필요하다.
| 에이전트 | 프로토콜 | 모델 목록 | 설정이 가는 곳 | Base URL 요지 |
|---|---|---|---|---|
| Claude Code | Anthropic Messages | GET /anthropic/v1/models | 환경변수 또는 ~/.claude/settings.json의 env | ANTHROPIC_BASE_URL=https://api.kie.ai/anthropic |
| Codex CLI | OpenAI Responses | GET /openai/v1/models | ~/.codex/config.toml의 [model_providers.kie] | https://api.kie.ai/openai/v1 |
| Grok Build | Responses (api_backend=responses) | GET /xai/v1/models | ~/.grok/config.toml의 [model.kie] | https://api.kie.ai/xai/v1 |
세 에이전트에 공통인 규칙은 네 가지다. 모델 이름은 리스팅에서 가져오고 기억으로 쓰지 않는다. 인증은 Bearer다. base URL에 전체 요청 경로를 넣지 않는다. 에이전트가 /v1/messages나 /responses를 스스로 붙이기 때문이다. 설정은 프로젝트 파일이 아니라 사용자 수준 파일에 둔다. 프로젝트 설정은 무시되거나 저장소에 커밋되기 쉽다.
Claude Code
모델은 GET https://api.kie.ai/anthropic/v1/models로만 고른다. 일반 taskType=Chat 카탈로그는 더 넓어서, 이 엔드포인트가 안 주는 모델까지 섞여 있다. ANTHROPIC_BASE_URL은 https://api.kie.ai/anthropic까지다. /v1/messages를 붙이면 경로가 두 번 생긴다. 키는 ANTHROPIC_AUTH_TOKEN에 원시 값으로 둔다. ANTHROPIC_API_KEY를 쓰면 X-Api-Key로 나가며, 값 앞에 Bearer (공백 포함)가 있어야 KIE가 받는다. Anthropic과 같은 id를 쓰므로 sonnet, opus, haiku, fable 별칭도 동작한다. 확인은 /status에서 base URL과 auth 줄을 본다.
Codex CLI
모델은 GET https://api.kie.ai/openai/v1/models다. 응답의 .models[]가 풍부한 쪽이고, slug가 config의 model 값이다. Codex 기본 모델 이름은 KIE에 없으므로, 프로바이더만 맞아도 model을 리스팅 slug로 바꾸기 전에는 요청이 실패한다. base_url은 https://api.kie.ai/openai/v1이고 Codex가 /responses를 붙인다. env_key에는 키 문자열이 아니라 환경변수 이름 KIE_API_KEY를 적는다. 프로바이더 id로 openai, ollama, lmstudio는 예약이라 덮어쓸 수 없다. 프로젝트 .codex/config.toml의 model_provider는 Codex가 무시한다. codex doctor로 로드·도달성을 본다.
Grok Build
모델은 GET https://api.kie.ai/xai/v1/models의 .data[].id다. Grok 내장 표기(예: grok-4.6)와 리스팅 id(예: grok-4-6)가 다를 수 있어, model 필드에는 리스팅 id를 그대로 넣는다. 반드시 api_backend = "responses"다. 기본값 chat_completions는 /v1/chat/completions로 가서 KIE의 /xai/v1/responses와 어긋난다. [models] default는 커스텀 키(예: kie)여야 새 세션이 xAI 기본으로 가지 않는다. 프로젝트 .grok/config.toml의 [model.*]는 추론 설정이 아니다.
설치 빠른 출발
공통 순서는 짧다. Node.js가 있는 머신에서 스킬을 설치하고, API 키를 만든 뒤 KIE_API_KEY를보낸다. 그 변수가 보이는 셸에서 에이전트를 시작한 다음, 생성은 kie-models 경로, 코딩 에이전트 과금은 kie-chat-agents 경로로 가면 된다.
아래는 문서에 나온 설치 명령이다. 같은 명령을 다시 실행하면 최신 버전으로 갱신된다.
npx skills add https://kie.ai키보내기 예는 OS별로 다르다. macOS·Linux는 셸 프로필에 export를 넣을 수 있다.
export KIE_API_KEY=your_keyWindows PowerShell 예는 현재 세션과 이후 창을 함께 맞춘다.
$env:KIE_API_KEY = "your_key"
setx KIE_API_KEY "your_key"
kie-chat-agents 쪽 모델 목록 스니펫은 curl과 jq를 전제로 한다. 대부분 OS에 jq가 없으므로 brew, apt, winget으로 설치한다. PowerShell에서 curl은 Invoke-WebRequest 별칭이라 문서 인자가 깨진다. curl.exe를 쓴다.
프로토콜이 어긋날 때 스킬은 프록시 코드를 기본 제공하지 않는다. 사용자에게 로컬 번역 프록시가 필요하다고 알리고, 코드를 쓰기 전에 먼저 묻는다. 프록시를 쓸 때도 에이전트 base URL에는 에이전트가 붙일 접미사를 넣지 않는다. 모델 id는 모델 쪽 리스팅에서 가져와 그대로 보낸다.
알아 두면 좋은 운영 규칙
모델 이름은 라이브 목록에서 매번 읽는다. 새 모델이 마켓에 올라오면 스킬이 기억에 의존하지 않아 바로 쓸 수 있다. 사용량은 직접 API를 칠 때와 같은 크레딧이고, 모든 호출은 kie.ai/logs에 보인다. 키는 채팅, 스크린샷, 저장소 커밋 파일에 두지 않는다. 유출되면 kie.ai/api-key에서 재발급한다.
생성 API는 비동기다. HTTP 200과 task_id는 접수 성공일 뿐 완료가 아니다. 콜백 URL을 주거나 task_id로 조회 API를 폴링한다. kie-models 스킬이 이 대기를 대신한다. 기본 제출 한도는 10초당 신규 생성 요청 20건 수준이고, 초과 시 429이며 대기열에 안 넣는다. 한도 상향은 지원에 요청하되 신중히 검토된다고 문서에 있다.
KIE는 공식 대비 공격적 가격과 함께, 안정성이 공식보다 약간 낮을 수 있다는 점을 Getting Started에서 먼저 밝힌다. 프로덕션에 쓸 만큼은 된다고 하면서도, 기대를 맞춰 두라는 톤이다. 지원은 Discord와 Telegram 1:1 채널을 우선하고, support@kie.ai 메일은 차선이다.
자주 걸리는 함정
트러블슈팅과 각 에이전트 Common pitfalls을 합치면 패턴이 반복된다. npx가 없으면 Node.js부터다. 스킬을 깔고도 안 쓰면 에이전트를 재시작하고, 요청에 스킬 이름을 명시한다. KIE_API_KEY 없음은 에이전트를 띄운 셸에 변수가 없다는 뜻이다. 401은 키 오류·만료이거나 apikey 헤더 실수다.
kie-models에서 모델이 빗나가면 요청에 모델명을 넣고, 실패 태스크는 logs에서 원인을 본 뒤 파라미터를 조정한다. 크레딧이 모자라면 pricing에서 충전한다. 결과 링크가 안 열리면 14일 만료일 수 있으니, 처음부터 로컬 저장 경로를 요청하는 편이 안전하다.
채팅 에이전트에서는 Chat only 모델을 에이전트에 물린 경우가 많다. 경로가 /v1/v1/messages나 /responses/responses처럼 두 번이면 base URL에 접미사를 넣은 것이다. Claude Code가 Anthropic 로그인을 물으면 변수가 그 프로세스에 안 들어간 상태다. Codex·Grok Build가 프로바이더를 무시하면 설정이 프로젝트 파일에만 있는 경우다. 다른 벤더 프로토콜의 모델을 쓰려면 프로토콜 불일치 절을 따른다.
디버그는 에이전트별로 다르다. Claude Code는 claude --debug, Codex는 codex doctor, Grok Build는 RUST_LOG=debug와 GROK_LOG_FILE이다. KIE 쪽 기록은 항상 logs 페이지다.
요청 문장을 어떻게 쓰는지
What your agent can do 페이지는 모델 유형별로 요청 예시를 준다. 이미지면 비율과 저장 경로를 밝히고, 영상이면 엔드포인트 추가처럼 앱 연동 문장을 쓸 수 있다. 음악은 길이와 분위기, 음성은 원문 파일과 출력 파일명을 함께 적는 식이 문서 예시에 가깝다.
에이전트는 모델 목록을 기억에 의존하지 않고 KIE에서 매번 읽는다. 그래서 마켓에 새로 올라온 모델도, 스킬을 다시 설치하지 않아도 다음 요청부터 후보에 들어올 수 있다. 특정 모델을 쓰고 싶으면 요청에 이름을 넣는다. 빼 두면 요청에 맞는 쪽을 고른다.
일회성 파일과 앱 연동을 구분하는 말도 문서에 있다. 파일을 바로 받으려면 저장 경로를 말한다. 내 API에 붙이려면 엔드포인트를 추가해 달라는 식으로 적는다. 같은 kie-models 스킬이지만, 결과물이 바이너리 파일인지 코드 변경인지가 갈린다.
프로토콜이 어긋날 때
에이전트가 쓰는 프로토콜과 KIE가 그 모델을 제공하는 프로토콜이 다르면, Install kie-chat-agents의 불일치 절이 적용된다. 같은 프로토콜이면 api.kie.ai로 바로 보낸다. 다르면 로컬에서 요청과 응답 모양을 번역하는 프록시가 필요하다.
스킬은 프록시 구현체를 포함하거나 이름을 정해 주지 않는다. 사용자에게 프록시가 필요하다고 알리고, 코드를 쓰기 전에 확인을 받는다. 이미 프록시가 있거나 이번엔 원하지 않을 수 있기 때문이다. 프록시를 쓰게 되면 에이전트의 base URL은 api.kie.ai가 아니라 프록시 주소로 향한다.
모델 목록은 에이전트 기본 목록이 아니라, 실제로 붙일 모델 쪽 KIE 리스팅에서 읽는다. 프록시가 GET /models를 열어 준다면 그 응답 모양은 에이전트가 기대하는 형식이어야 한다. 도구 호출의 id와 call_id, tool_use_id는 왕복에서 일관돼야 하고, 스트리밍은 에이전트가 턴을 끝내는 종료 이벤트까지 맞춰야 한다. 프로토콜 한계를 메우려고 가짜 사용자 메시지를 끼워 넣지 말라고 문서가 명시한다. 의미가 바뀌고, Codex 같은 에이전트는 대화를 계속 이어 갈 수 있다.
Windows와 셸에서 자주 틀리는 지점
문서의 Windows 절은 같은 실수를 여러 페이지에서 반복한다. setx로 넣은 변수는 이후에 연 창에만 보인다. VS Code나 Cursor 안쪽 터미널까지 모두 닫고 다시 열거나, 현재 창에는 $env:로도 넣는다. PowerShell의 curl은 Invoke-WebRequest 별칭이라 문서의 curl 인자가 깨지므로 curl.exe를 쓴다. jq가 없으면 winget으로 jqlang.jq를 설치하는 안내가 있다.
Claude Code는 사용자 수준 settings.json의 env 블록과 셸 변수가 동시에 있으면 설정 파일 쪽이 이긴다. 프로젝트 .claude/settings.json에 키를 넣으면 저장소에 올라갈 수 있어, 사용자 수준 파일이나 settings.local.json을 쓰라고 한다. Codex와 Grok Build도 추론용 프로바이더, 모델 테이블은 사용자 홈 설정에 둔다. 프로젝트 파일에만 있으면 조용히 무시되는 경우가 있다.
키 자체는 채팅에 붙여 넣거나 스크린샷에 남기지 않는다. 유출되면 api-key 페이지에서 재설정한다. 에이전트 스킬도 같은 환경변수 이름을 읽으므로, 프로젝트 루트에 키 파일을 새로 만들 필요는 없다.
마켓과 에이전트 리스팅이 다른 이유
Claude Code와 Grok Build 문서는 일반 채팅 카탈로그와 에이전트 전용 모델 목록이 다르다고 구분한다. taskType=Chat으로 보이는 넓은 목록에는, 그 에이전트 엔드포인트가 실제로 받지 않는 모델이 섞일 수 있다. 그래서 에이전트에 넣을 이름은 반드시 해당 에이전트 리스팅에서 고른다.
Codex 쪽 응답은 같은 모델이 두 형태로 나온다. data 배열은 OpenAI 호환 골격에 가깝고 id 위주다. models 배열이 context_window, default_reasoning_level, supported_reasoning_levels처럼 설정에 필요한 정보를 더 준다. 문서는 models 쪽 slug를 model 값으로 쓰라고 한다.
Grok Build는 피커에 보이는 테이블 키와 KIE로 보내는 model 필드를 나눈다. 테이블 이름은 사람이 고르는 라벨이고, model 값은 리스팅 id다. 내장 표기를 그대로 넣으면 base URL이 맞아도 거절될 수 있다. default도 커스텀 키여야 새 세션이 기본 xAI 경로로 새지 않는다.
에이전트 기능 경고와 맞물리면, 목록에 있어도 Chat only인 구형 모델은 에이전트에 물리지 않는 편이 안전하다. 최신 시리즈로 바꾸고, 그래도 이상하면 logs와 에이전트 디버그 로그를 같이 본다.
크레딧과 로그를 보는 방식
Getting Started는 과금 단위가 모델마다 이미지당, 초당, 영상당, 백만 토큰당처럼 다를 수 있다고 안내한다. 에이전트 스킬은 그 체계를 바꾸지 않고, 같은 지갑을 쓴다. 홈 FAQ는 큰 충전 시 보너스 크레딧 예시(예: 일정 금액 충전 시 추가 비율)를 들지만, 수치는 시점마다 달라질 수 있어 이 글에 고정 단가로 적지 않는다.
실패 태스크는 과금하지 않는다는 정책이 공개되어 있다. 생성이 실패하면 크레딧이 안 빠지는지 logs에서 확인하는 흐름이 문서의 검증 경로다. 크레딧 만료는 없다고 FAQ에 적혀 있다. 인보이스와 회사 정보 기입은 비즈니스 사용자 대상으로 billing 페이지에서 처리한다고 한다.
지원 채널은 대시보드의 Discord, Telegram 1:1을 우선한다. 메일 주소는 있으나 가장 빠른 길은 아니라고 한다. 운영 시간대는 UTC 기준으로 문서에 적혀 있으니, 한국 시간으로 환산해 문의 창을 맞추면 된다.
마무리
앞에서 다룬 KIE 에이전트 서비스의 핵심만 짧게 정리한다.
- KIE는 다중 모델 API 마켓이고, 코딩 에이전트용으로 스킬 두 개를 공개했다
- kie-models는 이미지, 영상, 음악, 음성 생성의 FIND→SAVE 흐름을 맡는다
- kie-chat-agents는 Claude Code, Codex CLI, Grok Build를 KIE 크레딧·프로토콜에 맞춘다
- 키는
KIE_API_KEY, 인증은 Bearer, 생성 파일은 14일 보관이다 - 에이전트에는 최신 모델을 쓰고, Market의 Chat only 표시를 피한다
- 과금은 크레딧이며 스킬 전용 별도 가격은 공개되지 않았다. 단가는 pricing과 logs를 본다
「문서를 붙이지 말고, 스킬과 키와 라이브 모델 목록으로 연결한다」 설치는 한 줄이고, 나머지는 요청 문장과 사용자 수준 설정과 환경변수에 있다. 가격의 세부 숫자는 모델과 시점에 따라 바뀌므로 이 글에 단가를 고정해 두지 않았다.
출처와 링크
조사 기준: 2026년 10월 1일 (KST). 가격과 모델 목록은 시점마다 바뀌므로 pricing과 Market·에이전트별 models 엔드포인트를 다시 확인한다.
FAQ
자주 묻는 질문
KIE 에이전트 서비스가 새로 만든 제품의 정체는 무엇인가요?
자체 초대형 모델을 처음부터 학습한 제품이라기보다, 코딩 에이전트가 KIE 마켓과 채팅 API를 문서 붙여넣기 없이 쓰도록 돕는 스킬 두 개입니다. kie-models와 kie-chat-agents이며, 설치 명령 한 줄로 같이 들어옵니다.
kie-models와 kie-chat-agents 중 어느 쪽만 설치해야 하나요?
공식 설치는 한 명령으로 둘 다 추가합니다. 생성·파일 저장 요청이면 kie-models가, 코딩 에이전트를 KIE 크레딧으로 돌리거나 모델 목록을 물으면 kie-chat-agents가 선택됩니다. 요청 문장으로 갈립니다.
에이전트 과금은 어떻게 되나요?
스킬 전용 별도 구독가는 공개 문서에 없습니다. 사용량은 API를 직접 호출할 때와 같은 KIE 크레딧에서 빠지고, 기록은 kie.ai/logs에 남습니다. 모델별 최신 단가는 pricing 페이지를 봐야 합니다.
Chat only 표시는 무엇을 의미하나요?
일부 오래된 모델은 채팅 요청만 지원하고 에이전트 연결 시 오류나 예상 밖 결과가 날 수 있다는 뜻입니다. Market 모델 페이지에 Chat only로 표시되며, 에이전트 기능에는 시리즈 최신 모델을 쓰라고 문서가 경고합니다.
생성 결과 링크가 며칠 뒤 안 열리면 어떻게 되나요?
생성 미디어는 서버에 14일 보관된 뒤 삭제됩니다. kie-models는 에이전트가 로컬 경로로 받아 두므로, 요청 때 저장 경로를 밝히면 링크 만료 후에도 파일을 가질 수 있습니다. 로그 메타는 약 2개월입니다.
Claude Code에서 401이 자주 나는 설정 실수는 무엇인가요?
헤더 이름을 apikey로 보내거나, ANTHROPIC_AUTH_TOKEN에 Bearer 접두사를 중복으로 넣는 경우가 많습니다. 원시 키만 AUTH_TOKEN에 두고, API_KEY를 쓸 때는 값 앞에 Bearer와 공백이 있어야 합니다.
Codex에서 프로바이더는 맞는데 요청만 실패하면?
Codex 기본 모델 이름은 KIE가 제공하지 않습니다. openai/v1/models 리스팅의 slug를 model에 넣어야 합니다. 또한 model_provider를 프로젝트 .codex/config.toml에만 두면 Codex가 무시합니다.
프로토콜이 다른 모델을 에이전트에 붙일 수 있나요?
가능하지만 로컬 번역 프록시가 필요합니다. 스킬은 프록시 코드를 기본으로 주지 않고, 사용자에게 먼저 확인한 뒤에만 작성합니다. base URL은 프록시를 가리키고, 모델 id는 모델 쪽 리스팅에서 가져옵니다.
용어
관련 용어
AI 코딩 에이전트가 특정 작업을 수행할 때 참조하는 모듈화된 지침·프롬프트 묶음을 통칭한다. Claude Code에서는 '.claude/skills/<스킬명>/SKILL.md' 형태로 프로젝트 저장소, 개인 홈 디렉터리, 또는 조직(Enterprise) 수준에 배치하며, Agent Skills 오픈 스탠더드를 따른다. 각 스킬은 YAML 프론트매터(name, description, allowed-tools, context 등)와 마크다운 본문으로 구성되고, Claude가 대화 맥락에서 자동으로 로드하거나 사용자가 '/스킬명'으로 직접 호출할 수 있다. 스킬 본문은 호출 시점에만 컨텍스트에 적재되므로, 긴 참조 자료도 평소에는 토큰을 거의 소비하지 않는다. CLAUDE.md에 반복적으로 붙여넣던 절차서·체크리스트·코딩 규칙을 스킬로 분리하면, 에이전트가 필요할 때만 불러와 일관된 동작을 유도할 수 있다. 서브에이전트 실행(context: fork), 동적 컨텍스트 주입(!`command`), 인자 치환($ARGUMENTS) 같은 고급 기능도 지원한다. Cursor 등 다른 IDE에서도 유사한 개념으로 커스텀 프롬프트·룰을 관리하며, 넓은 의미에서 '스킬'이라는 용어로 통용된다.
커뮤니티·문화 SWE 벤치AI 코딩 에이전트의 실제 소프트웨어 엔지니어링 능력을 측정하는 벤치마크로, Princeton NLP 그룹이 2023년 10월에 발표했다. 단순한 코드 생성 능력이 아니라, 실제 오픈소스 GitHub 리포지토리에서 보고된 실제 이슈(버그 리포트, 기능 요청)를 해결하는 능력을 평가한다는 점에서 기존 벤치마크(HumanEval, MBPP 등)와 차별화된다. 테스트 과정: 에이전트에게 GitHub 이슈 설명과 관련 코드베이스가 주어지면, 에이전트가 코드를 수정하고 이 수정이 기존 테스트를 통과하는지 확인한다. 이는 실제 소프트웨어 개발 환경과 가장 유사한 평가 방식이다. 2026년 3월 기준 주요 성적: Claude Code 80.8%, Codex CLI 약 70%대(변형에 따라 상이). SWE-bench는 AI 코딩 도구 성능 비교의 사실상 표준(de facto standard)이 되었으며, 새로운 도구나 모델이 출시될 때 SWE-bench 성적이 가장 먼저 언급된다. SWE-bench Verified(검증된 하위 집합), SWE-bench Lite(경량 버전), Terminal Bench(터미널 에이전트 특화) 등의 변형도 존재한다.
핵심 개념 플랜 모드AI 코딩 도구에서 코드를 바로 생성·수정하기 전에, 먼저 코드베이스를 분석하고 구현 계획을 수립하여 사용자에게 검토·승인을 받는 운영 모드를 뜻한다. Claude Code에서는 Shift+Tab을 두 번 눌러 활성화하며, 이 모드에서 Claude는 파일 수정·명령 실행을 할 수 없는 읽기 전용 상태가 된다. 대신 코드베이스 전체를 탐색하고, 명확히 할 질문을 던지며, 마크다운 형태의 구현 계획서를 작성한다. 사용자가 계획을 승인하면 일반 모드(또는 Auto-Accept 모드)로 전환하여 실행에 옮긴다. '생각'과 '실행'을 분리함으로써, AI가 요청하지 않은 변경을 가하거나 아키텍처 판단을 잘못 내리는 문제를 예방한다. Cursor IDE에서도 2025년 10월부터 Plan Mode를 도입했는데, Agent가 코드 변경 전 상세 계획을 생성하고 사용자가 인라인 편집기에서 계획을 수정할 수 있게 한다. 특히 3단계 이상의 복잡한 작업이나 아키텍처 결정이 필요한 경우 플랜 모드를 먼저 사용하는 것이 권장되며, 바이브 코딩의 '무계획' 리스크를 줄이는 실질적 장치로 주목받고 있다.
링크
관련 링크
쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
취업 이력서 AI 에이전트 스킬 6개 | 자소서, 경력기술서, 포트폴리오별 비교와 설치법
GitHub에는 이력서, 자기소개서, 경력기술서, 포트폴리오 작업을 AI 코딩 에이전트에게 맡기는 스킬이 여럿 올라와 있다. 여기서 스킬은 Claude Code나 Codex 같은 에이전트가 읽는 작업 설명서 묶음이다. 폴더 안 SKILL.md에 "자소서를 고칠 때는 이 순서로 보고, 이런 표현은 빼고, 결과는 이 양식으로 낸다"는 식의 규칙이 들어 있어서, 설치해 두면 같은 요청에도 훨씬 일정한 결과가 나온다.
이번에 살펴본 저장소는 6개다. 한국 취업 전 과정을 묶은 jobstack, 면접관 시점 검토와 포트폴리오 제작이 들어 있는 Career-Skills, 자소서 문항 첨삭에 집중한 자소서 도우미, 경력기술서 양식 하나에 집중한 writing-career-resume, 영문 LaTeX 이력서를 만드는 claude-resume-kit, 그리…
구글 애드센스 고시 SEO 점검 개선 후 승인 | fire-your-seo-agency 스킬
사이트를 만들어 두고 Google 애드센스에 신청했다가, 몇 달째 통과하지 못한 적이 있다. 거절 메일을 받을 때마다 무엇을 고쳐야 하는지가 한 줄로 떨어지지 않았고, AI에게 「SEO 점검하고 개선해 줘」라고만 말해 보기도 했다. 그때마다 뭔가 바뀌기는 했지만, 기준이 없어서 다음에 같은 점검을 다시 시킬 수가 없었다.
이거, 메일 받아 보신 분? 많으실 겁니다. 애드센스를 하다 보면 마주치는 그 팔짱 낀 아저씨 쪽에, 이런 사유가 적혀 있었다.
그림. 애드센스 안내에서 자주 보이는 팔짱 낀 아저씨