바이브코딩
뮤즈 원더와 뮤즈 스파크 1.3 | 한국에서 커서, 오픈라우터로 쓰는 법, 가격, 벤치마크
메타가 9월과 10월에 내놓은 Muse Spark 1.3과 Muse Wonder, Wonder Full의 정체, 한국에서 커서로 두 모델을 고르는 법과 오픈라우터 API 사용법, 토큰 가격과 Muse Code 구독, 발표 수치와 독립 평가, X 후기 정리
Muse Spark 1.3과 Muse Wonder는 Meta가 만든 AI 언어 모델이다. 둘 다 질문과 자료를 받아 글로 답한다. 이미지를 그려 주거나 영상을 만들어 주는 모델이 아니다. 그림을 만드는 모델은 따로 있고, 이름은 Muse Image다.
쓰는 자리도 나뉜다. Spark 1.3은 코딩과 도구를 여러 단계로 쓰는 일을 낮은 비용으로 처리하는 중간급 모델이다. Wonder는 더 큰 프런티어 모델로, 긴 코딩과 컴퓨터 조작, 개인과 업무용 에이전트를 겨냥한다. Wonder Full은 같은 날 나온 더 강한 변형이며, Muse Code 구독 안에서만 고른다.
Spark 1.3은 2026년 9월 2일에 나왔다. Wonder와 Wonder Full은 2026년 10월 12일에 나왔다. 만든 곳은 Meta Superintelligence Labs다. 글을 다루는 사람, 저장소 작업을 에이전트에 맡기는 사람, API로 많은 양을 돌리는 팀이 대상이다.
한국에서 쓰는 길은 경로마다 다르다. 커서(Cursor)에서는 한국에서도 Muse Wonder와 Muse Spark 1.3을 모두 고를 수 있다. 필자의 커서 화면에서 두 모델이 모델 목록에 보이고 선택됐다. Meta가 한국에서 Wonder를 아직 제공하지 않는다고 적은 범위는 Meta가 직접 운영하는 Model API와 Muse Code다. 오픈라우터(OpenRouter)에도 두 모델이 올라 있지만, 한국에서의 호출은 공식 문서로 확인되지 않았다. Muse Spark 1.3은 Meta 정책상 한국 제한이 없고, 무료로는 Meta AI 앱에서 Muse Spark를 체험할 수 있다. 그 앱이 Spark의 어느 버전인지는 공개되지 않았다. 가격, 점수, 시작 방법은 2026년 10월 21일까지 공개된 문서와 독립 평가, 필자의 커서 화면을 기준으로 한다.
Muse Wonder와 Muse Spark 1.3은 무엇인가
Spark 1.3은 비용을 낮춘 추론 모델이다. 가벼운 축과 중간 크기 사이에 있다. 나오는 것은 글뿐이다. 넣는 것은 글, 이미지, 영상, 음성, PDF다. 하는 일은 에이전트형 작업과 코딩이다. 한 번에 다루는 맥락은 1,048,576토큰이고, API에서 부르는 이름은 muse-spark-1.3이다.
자료를 읽고 글로 답한다. 도구를 여러 번 부르는 일과 코딩에 맞춰져 있다. 추론 강도를 고를 수 있다. Wonder보다 토큰 단가가 낮다. 새 작업에는 이 1.3을 쓰라고 문서가 권한다.
Wonder는 그보다 큰 모델 가족이다. 구성은 Muse Wonder와 Muse Wonder Full 두 가지다. 출력은 역시 글이고, 맥락은 1M, 곧 1,048,576토큰으로 안내된다. API 이름은 muse-wonder-1.0이다. Full은 API에 없고 Muse Code 구독에만 있다. Meta는 이 가족을 개인용과 업무용 에이전트, 긴 코딩, 컴퓨터 사용에서 가장 강한 모델이라고 소개한다.
Wonder 쪽에서 먼저 알아 둘 기능은 이름이 붙어 있다. Active Memory는 사용자에 대해 중요한 내용을 대화가 바뀌어도 들고 있다가, 지금 일에 맞는 부분을 다시 꺼낸다. Active Focus는 어려운 목표를 향해 다른 방법을 시도하고, 막히면 우회하고, 중요한 행동 전에는 확인한다. Meta가 강점으로 적은 분야는 법률, 재무, 건강의 지식, 기억, 실제 저장소의 코딩, 데스크톱을 직접 다루는 컴퓨터 사용이다. 문서에서 Wonder는 preview로 표시된다.
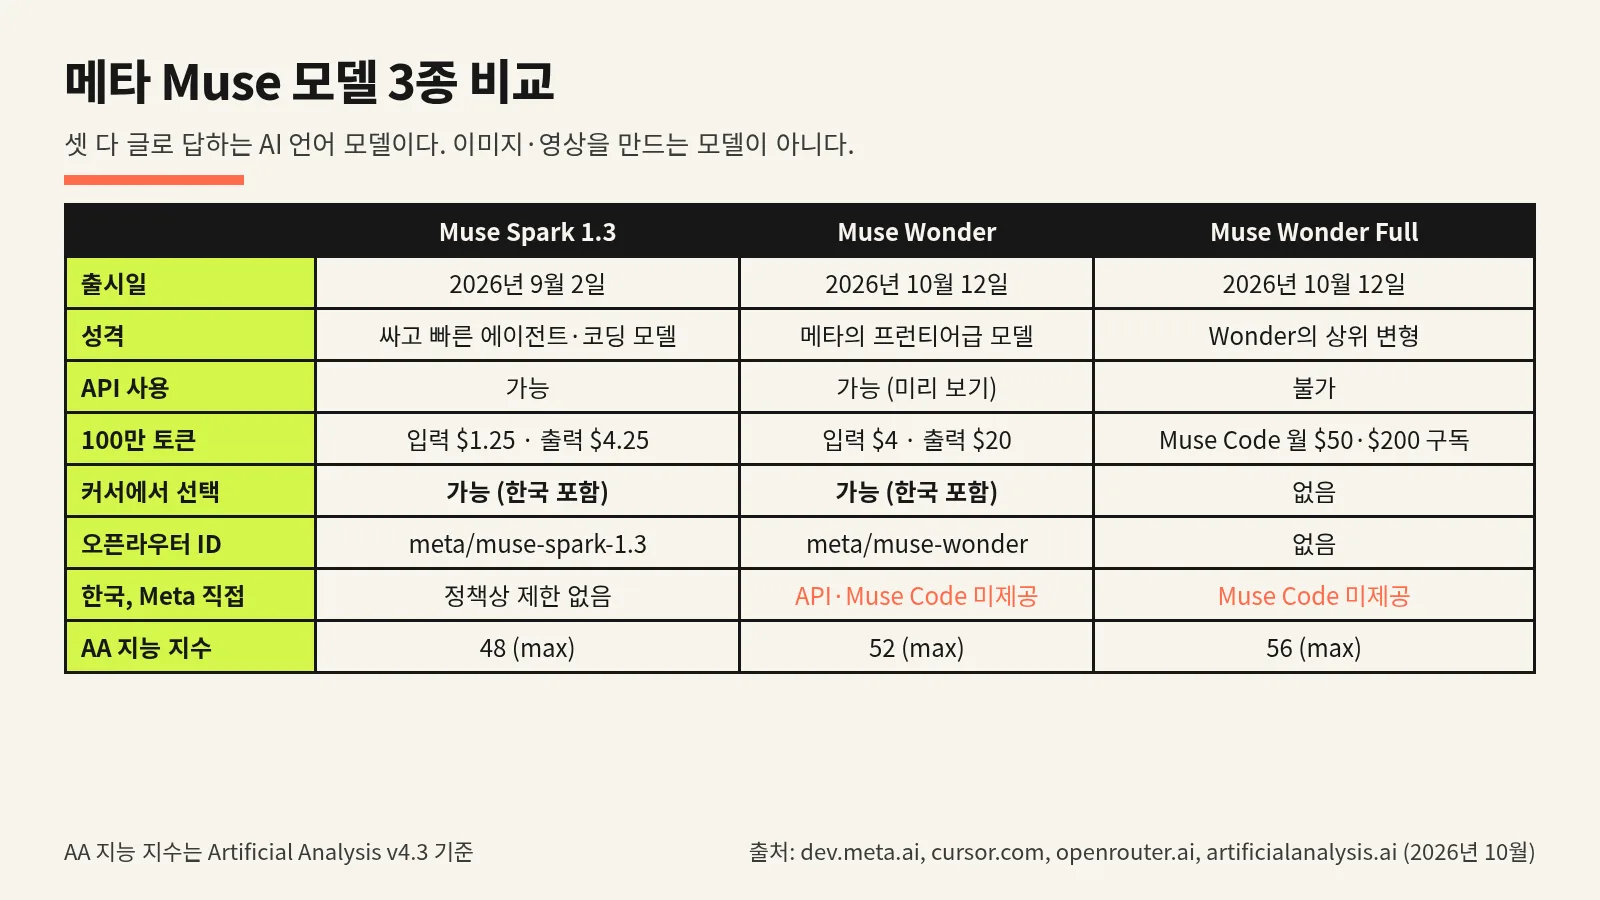
| 항목 | Muse Spark 1.3 | Muse Wonder | Muse Wonder Full |
|---|---|---|---|
| 나온 날 | 2026년 9월 2일 | 2026년 10월 12일 | 2026년 10월 12일 |
| 하는 일 | 대량이고 비용에 민감한 코딩과 도구 사용 | 길고 복잡한 일 | 가장 어려운 작업 |
| 답의 형태 | 글 | 글 | 글 |
| API | 있음 | 있음. 표준만, preview | 없음 |
| 컨텍스트 | 1,048,576 | 1,048,576 | 1M |
| 한국, Meta 직접 | 정책상 제한 없음 | API와 Muse Code 미제공 | Muse Code 미제공 |
| 커서 | 선택 가능 (한국 포함) | 선택 가능 (한국 포함) | 없음 |
| 오픈라우터 ID | meta/muse-spark-1.3 | meta/muse-wonder | 없음 |
Wonder 계열 안내는 1M을 1,048,576토큰으로 풀어 적는다. Full 칸만 1M으로 적힌 표가 있어도 같은 자리다. 세 모델 다 이미지를 생성하지 않는다.
이름 Muse는 한 제품을 가리키지 않는다. 첫째는 모델 가족이다. Muse Spark, Muse Wonder, 이미지를 만드는 Muse Image가 여기 속한다. 둘째는 소비자용 개인 에이전트 앱 Muse다. 셋째는 터미널에서 도는 코딩 에이전트 Muse Code다. Meta AI는 또 다른 챗봇이고 주소는 meta.ai이며, 그 위에서 도는 모델이 Muse Spark다. Meta는 Wonder가 곧 소비자용 Muse의 경험에 들어가고, 구독자부터이며, 산출물 생성도 포함된다고 적었다. 나중에는 더 많은 사람을 위한 특화 모델을 만드는 데 쓴다고도 했다. 앱 이름과 모델 버전을 한 번호로 읽으면 서로 다른 상품이 겹친다.
지금 당장 알아둘 것
무료인 곳과 돈을 내는 곳이 다르다. Meta AI 앱은 무료 챗봇이다. API는 쓴 만큼 낸다. Muse Code는 월 구독이다. 무료 등급은 없다는 2차 자료가 있다.
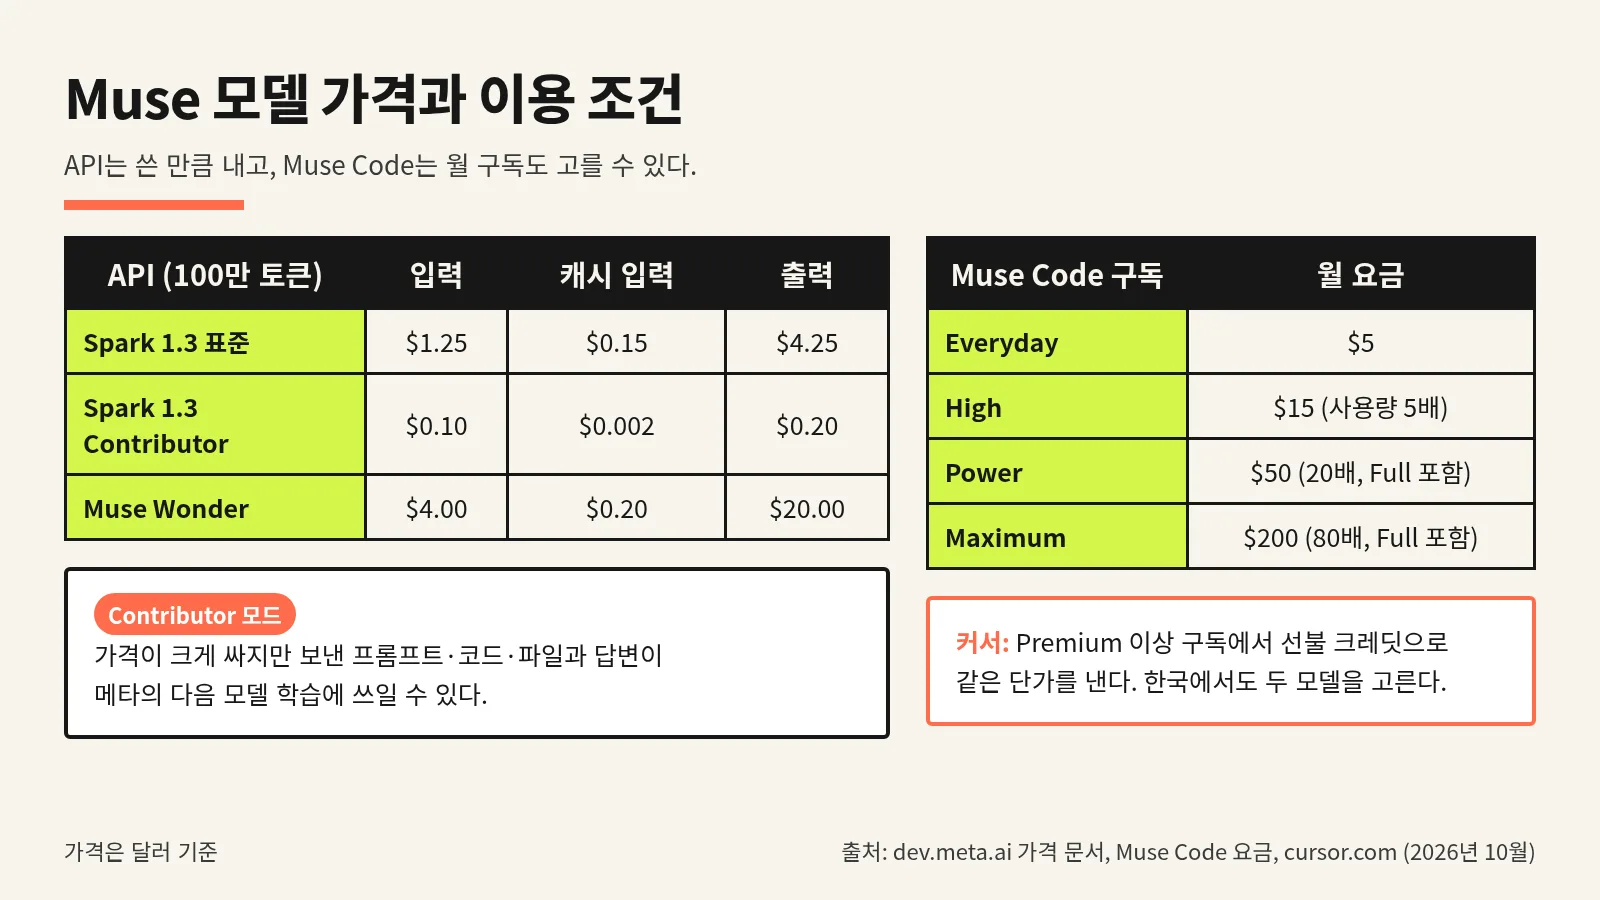
토큰 가격은 100만 개 기준이다. Spark 1.3 표준은 입력이 1.25달러, 캐시된 입력이 0.15달러, 출력이 4.25달러다. Contributor는 입력이 0.10달러, 캐시가 0.002달러, 출력이 0.20달러다. 싼 대신 프롬프트, 코드, 파일, 출력이 이후 모델 학습에 쓰일 수 있다. 표준 모드는 학습에 쓰지 않는다고 적혀 있다. 추론 강도 max는 표준 id에 있다. Contributor용 id에는 max가 없다.
Wonder는 표준만 판다. 입력은 $4, 캐시 입력은 $0.20, 출력은 $20이다. 종량제 Contributor는 없다. Wonder Full은 토큰으로 팔지 않는다. Muse Code는 월 $5부터다. 그 플랜 표에 Wonder가 보여도, 한국의 Muse Code에서는 그 모델이 열리지 않는다. Full은 더 윗단 구독에만 있다.
지역 조건은 경로별로 읽어야 한다. Meta 문서는 Wonder와 Wonder Full이 현재 한국에서 Model API로도 Muse Code로도 제공되지 않는다고 적는다. 이 문장은 Meta가 직접 운영하는 두 경로에 대한 것이다. 커서는 2026년 10월 16일(한국 시간) Muse Wonder를 추가했고, 한국에서도 커서 모델 목록에서 고를 수 있다. Spark는 다르다. 2026년 10월 12일에 갱신된 지역 정책의 제한 목록에 한국이 없고, Spark를 한국만 막는 모델별 목록도 없다. 인도 제한이 걸린 것은 Muse Image다. 그래서 정책만 보면 한국에서 API와 Muse Code로 Spark 1.3을 쓸 수 있다. 계정을 열어 주고 결제가 되는지는 그 문장과 별개다.
소비자용 Muse 앱은 도움말 기준으로 제한된 시험 중이고, 모든 지역에서 열리지는 않았다. 2026년 10월 16일 한국어 2차 자료는 미국과 캐나다를 적고, 한국 출시 발표는 없다고 했다. 한국에서 Spark를 체험하는 무료 입구는 그 앱이 아니라 Meta AI다. Meta AI는 2026년 5월 13일에 한국에 나왔고, Muse Spark 위에서 돈다.
들어갈 문은 다섯 개다. Meta AI 앱과 meta.ai, 커서, 오픈라우터, 터미널의 Muse Code, 종량제 Meta Model API다. 한국에서 Wonder까지 확실히 쓰는 길은 커서다. 오픈라우터는 두 모델을 올려 두었지만 한국 호출은 공식 확인 전이다. VPN 등으로 Meta의 지역 통제를 우회하는 것은 Meta 정책이 금지한다.
⚠️ 주의: Meta 문서 기준으로 Muse Wonder와 Muse Wonder Full은 한국에서 Meta의 Model API와 Muse Code로는 제공되지 않는다. 커서에서는 한국에서도 Muse Wonder를 고를 수 있다. Muse Spark 1.3은 Meta 지역 제한 목록에 한국이 없다. Contributor 모드의 입력과 출력은 이후 모델 학습에 쓰일 수 있고, 표준 모드는 학습에 쓰지 않는다고 Meta가 적었다. Contributor id에는 추론 강도 max가 없다.
Spark 1.3이 1.2와 달라진 점
Muse Spark의 첫 소개는 2026년 4월 8일이다. Meta Superintelligence Labs의 첫 모델이었고, Meta AI 앱과 meta.ai에 들어갔다. 2026년 7월 9일에는 Spark 1.1이 Meta Model API 공개 프리뷰로 열렸다. 2026년 8월 5일에는 터미널 코딩 에이전트 Muse Code의 베타와 Spark 1.2가 함께 나왔다. Muse Code가 베타를 벗어난 날을 2026년 8월 31일로 적은 2차 자료가 있다.
2026년 9월 2일 Spark 1.3이 Muse Code와 API에 올랐다. 출시 당일 max는 일부 파트너에게만 열린 프리뷰였고, 넓게 배포된 추론 강도는 xhigh였다고 VentureBeat가 적었다. 2026년 9월 4일 @alexandr_wang가 max의 공개를 알리며, high나 xhigh를 이미 써 봤어도 max를 한번 써 보라는 취지로 적었다. 소비자용 Muse 앱이 미국에서 나온 2차 기록은 2026년 9월 8일이다. Wonder와 Wonder Full의 출시는 2026년 10월 12일이다.
1.3은 1.2보다 에이전트 작업에 맞춰 조율됐다. 도구를 여러 단계로 쓰고, 브라우저를 다루고, 긴 과제를 이어 가는 쪽이 보강됐다. 사람이 말을 애매하게 하면 되묻고, 막히면 도움을 요청하고, 결과가 큰 행동 전에는 확인한다. 진행을 자주 알릴 수도 있고 조용히 갈 수도 있다. 길고 복잡한 지시에서 조건을 중도에 떨어뜨리는 일이 줄었다고 한다. 한 대화 안에 일이 섞여 있어도 더 버티고, 자기 한계를 보아 되지 않은 결과를 된 것처럼 말하지 않는 쪽이 나아졌다고 한다.
코딩에서는 불필요한 왕복이 줄고, 말이 짧아지고, 문체가 단정해졌다고 한다. Meta 엔지니어의 내부 비교에서는 1.2보다 도구 호출이 약 20% 적고, 토큰이 약 25% 적었다. 이 비율은 독립 기관의 측정이 아니다. 안전 쪽에서는 프롬프트 인젝션을 더 잘 견디고, 되돌리기 어려운 행동을 가늠하는 보정이 나아졌다고 적는다.
Muse Wonder와 Wonder Full의 차이
둘은 같은 날 나왔지만 같은 상품이 아니다. Muse Wonder는 API와 Muse Code에 있고 id는 muse-wonder-1.0이다. Muse Wonder Full은 능력이 더 높고, Muse Code 구독에서만 고른다. API에는 Full이 없다. Wonder에서 추론 강도를 max로 올려도 Full이 선택되지 않는다. 문서가 그 점을 따로 적었다.
핵심 포인트: Muse Wonder의 추론 강도를 max로 맞춰도 Muse Wonder Full이 되지 않는다. Full은 API에 없다. Muse Code의 Power Usage(월 $50)와 Maximum Usage(월 $200)에서만 고른다.
Meta의 표현을 빌리면, 이 가족은 가장 강한 모델이고 개인용 초지능으로 가는 사다리의 다음 칸이다. 개인과 업무용 에이전트 과제에서 최고 수준이라는 소개도 Meta 자신의 문장이다. 블로그는 Wonder를, Meta가 AI 작업을 밑바닥부터 다시 시작한 지 14개월 뒤의 결과로 적는다. TechCrunch는 학습이 기가와트 규모 Prometheus 데이터센터에서 이뤄졌고 그곳이 오하이오라고 전했다. CNBC는 Alexandr Wang 인터뷰에서 코드네임이 Watermelon이었다고 보도했다. @AIatMeta가 2026년 10월 12일 출시 게시물을 올렸다.
코딩에서 Meta가 적은 강점은 실제 저장소의 여러 파일 수정, 하위 에이전트에 일을 나누는 것, 도구를 병렬로 부르는 것, 오류에서 회복하는 것이다. 컴퓨터 사용은 데스크톱을 직접 다루는 일이다. 처음 보는 과제에서는 Spark 1.3의 추세가 예측하는 것보다 Full이 더 낫다는 그림도 블로그에 있다. 이유는 더 크고 강한 기반 모델이라고 Meta가 설명한다.
모델 카드의 한계도 같이 읽어야 한다. 틀리거나 편향될 수 있다. 처음 보는 상황에서는 여러 단계 추론이 어긋날 수 있다. 모든 언어를 평가하지는 않았다. 되돌리기 어려운 행동은 사람이 확인하는 쪽을 Meta가 권한다.
Meta AI, Muse Code, API로 시작하기
이 장은 Meta가 직접 운영하는 세 입구를 다룬다. 한국에서 바로 여는 챗봇, 터미널에 설치하는 코딩 에이전트, 종량제로 부르는 API다. 설치 명령은 지역과 상관없이 같은 주소다. 이 세 입구에서 한국 계정에 열리지 않는 것은 Wonder와 Wonder Full이다. 커서와 오픈라우터는 다음 두 장에서 따로 다룬다.
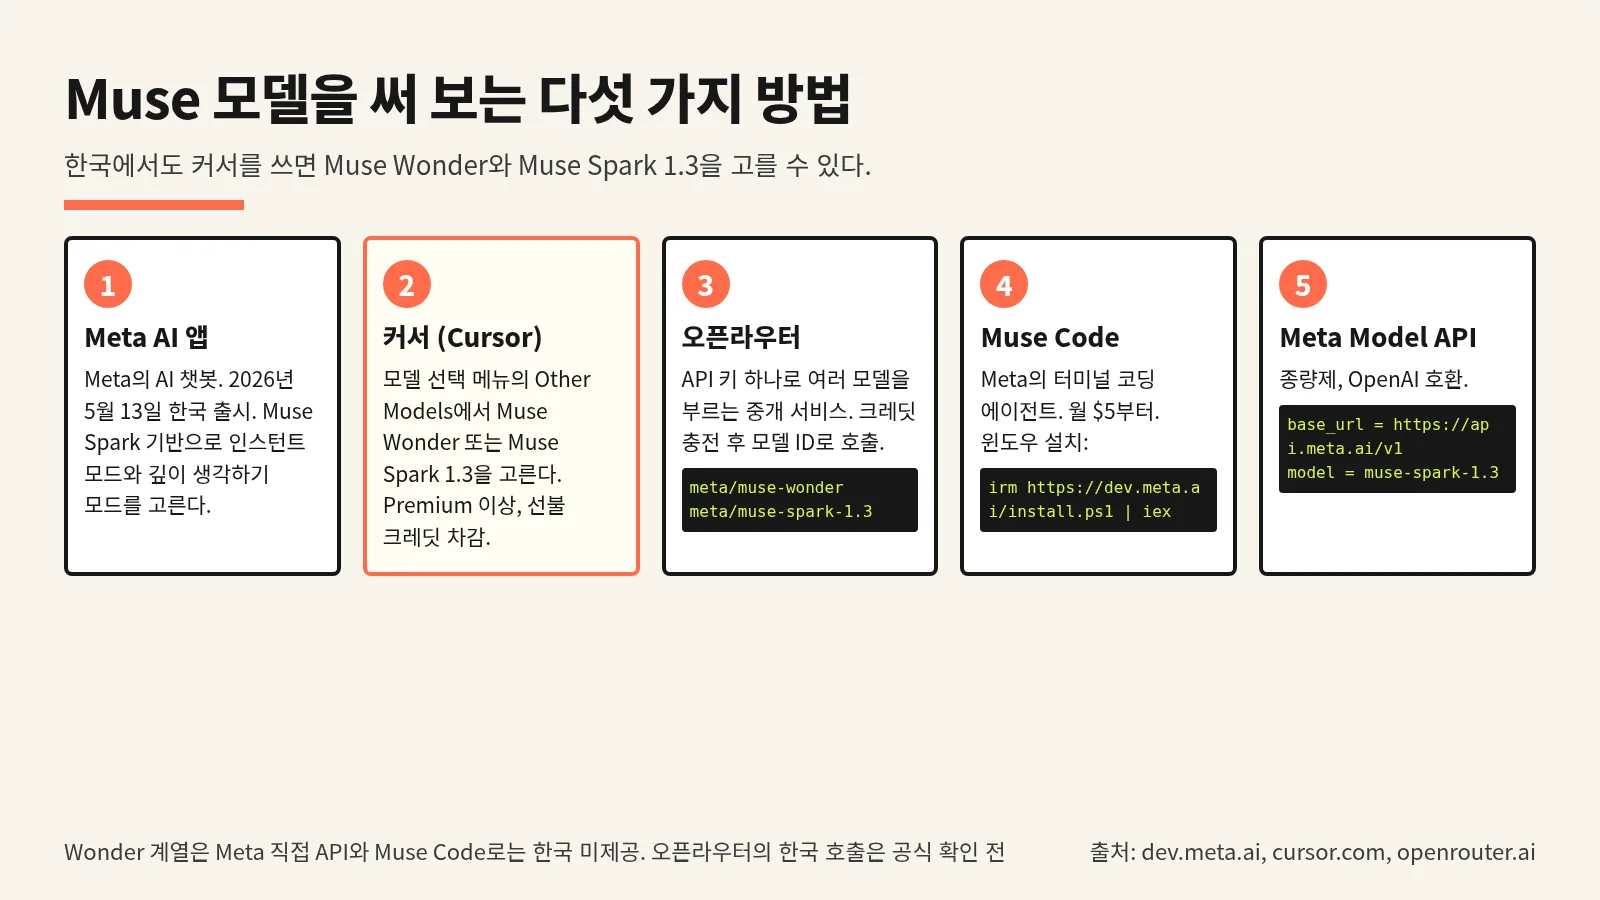
Meta AI는 한국에서 받는 앱이거나 웹의 meta.ai다. Google Play나 App Store에서 Meta AI를 받거나 브라우저로 meta.ai를 연다. 인스턴트 모드는 빠른 답이고, 깊이 생각하기 모드는 더 오래 추론하는 답이다. 사진 분석, 문서 업로드, 문서 비교가 된다.
Muse Code는 터미널에서 도는 코딩 에이전트다. 설치 스크립트는 dev.meta.ai에서 받는다. Windows에서는 PowerShell을 열고 아래 명령을 입력한다.
irm https://dev.meta.ai/install.ps1 | iexmacOS와 Linux에서는 터미널을 열고 아래 명령을 입력한다. 블로그의 다른 예시에는 파이프 뒤를 bash로 적은 줄도 있다.
curl -fsSL https://dev.meta.ai/install.sh | sh설치가 끝나면 같은 PowerShell이나 터미널에 아래 명령을 입력해 버전을 확인한다.
muse --version프로젝트 폴더로 이동한 뒤 그 터미널에 아래 명령을 입력하면 에이전트가 열린다.
muse처음 실행하면 작업 공간을 신뢰할지 묻는다. 신뢰하면 스킬, 규칙, 훅을 불러온다. 로그인은 브라우저 로그인 또는 API 키다. 로그인 화면을 다시 여는 명령은 /login이다. 자동 실행 환경에 두는 키 이름은 META_API_KEY다. 아래 API 예제의 MODEL_API_KEY와 이름이 다르다. 프롬프트 한 번만 실행할 때는 터미널에 아래 명령을 입력한다.
muse exec "<prompt>"Windows에서는 Bash 대신 PowerShell을 쓴다. 샌드박스를 처음 켤 때 UAC 확인 창이 뜰 수 있다. 음성 입력과 세션 메시지는 Windows에서 제공되지 않는다. 문서에 적힌 기본 모델은 muse-spark-1.2다. 설정 항목에서 모델을 바꿀 수 있다고만 되어 있고, 바꾸는 정확한 명령은 확인되지 않았다. 1.2 출시 때 같이 들어온 명령으로 /plan, /grill, /goal이 있다. /plan은 승인 뒤에 계획을 진행하고, /grill은 그 계획을 눌러 보고, /goal은 목표를 향해 작업을 이어 간다.
Meta Model API는 종량제이고 OpenAI 호환 방식이다. 키는 dev.meta.ai에서 만든다. 클라이언트 베이스 주소는 https://api.meta.ai/v1이다. 모델 id는 muse-spark-1.3, muse-spark-1.3-contributor, muse-wonder-1.0 가운데 고른다. 엔드포인트는 Responses, Chat Completions, 그리고 Anthropic 형식의 Messages다. Wonder와 Spark 사이를 옮길 때는 요청 모양을 유지한 채 모델 id만 바꾸면 된다. muse-wonder-1.0은 Full이 아니다. 환경 변수 MODEL_API_KEY가 보이는 파이썬에서 아래 코드를 실행하면 모델 목록이 출력된다.
import os
from openai import OpenAI
client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
print(client.models.list().model_dump_json(indent=2))
커서에서 쓰는 방법
커서(Cursor)는 2026년 9월 9일(한국 시간) Muse Spark 1.3을 모델 목록에 넣었다. 커서 문서는 이 모델을 커서에 들어온 첫 Meta 모델이라고 적는다. Muse Wonder는 2026년 10월 16일(한국 시간)에 추가됐고, 커서는 발표 글에서 기본 추론 강도 기준 CursorBench 점수가 46.1%로 Muse 모델 가운데 가장 높다고 밝혔다. 목록에 있는 것은 Muse Wonder이고, Muse Wonder Full은 커서에 없다.
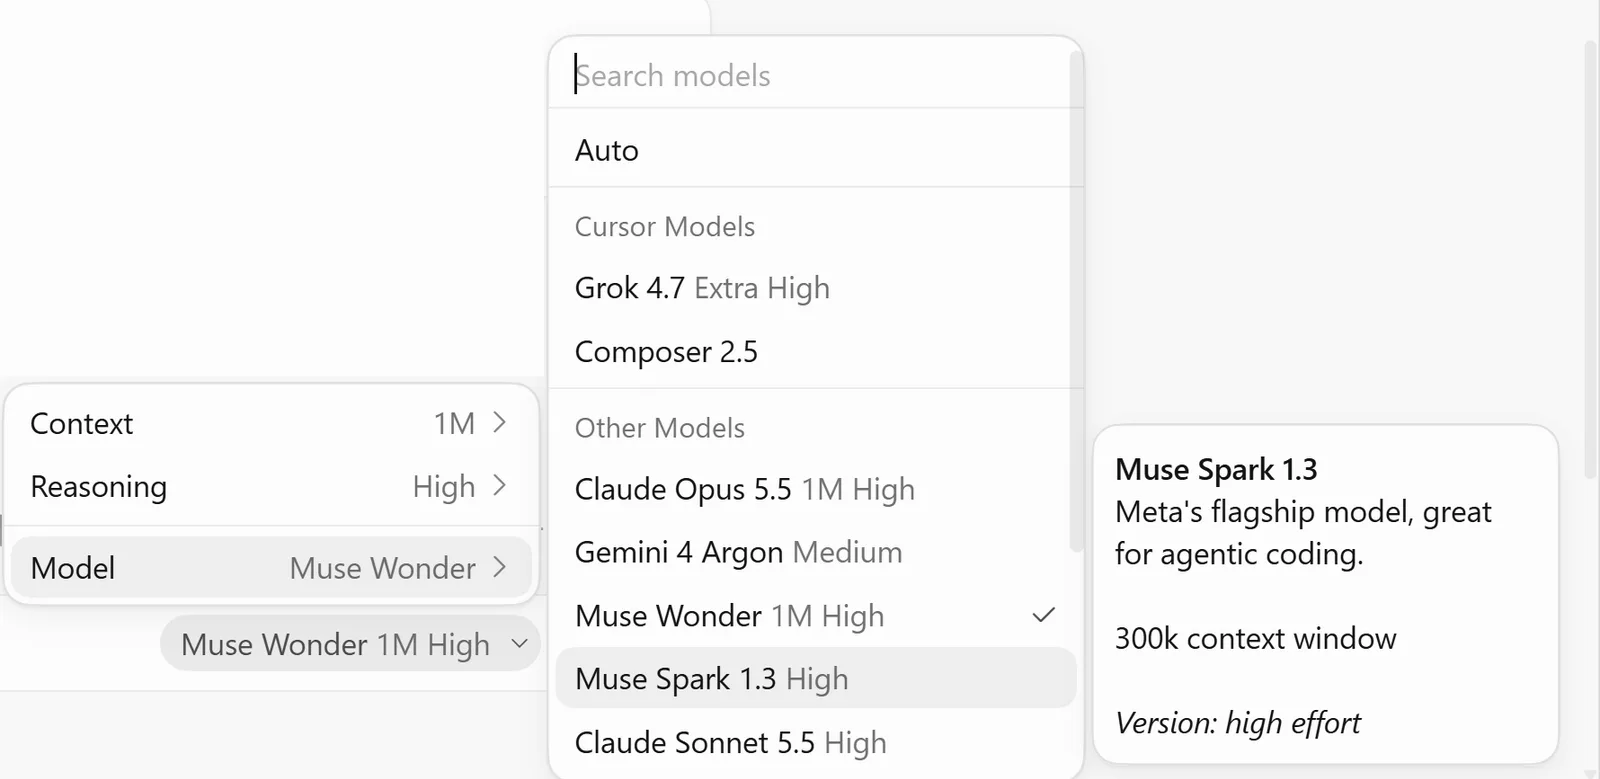
한국에서도 두 모델을 고를 수 있다. 한국에 있는 필자의 커서 화면(2026년 10월 21일)에서 Muse Wonder와 Muse Spark 1.3이 모두 목록에 보였고 실제로 선택됐다. 커서는 자체 제공자 계약으로 Meta 모델을 붙이며, 커서 문서에는 Meta 모델에 대한 국가 제한 안내가 없다. Meta가 한국에서 Wonder를 제공하지 않는다고 적은 문장은 Meta가 직접 운영하는 Model API와 Muse Code에 대한 것이다. 커서 목록에서 고르는 일과 Meta 서비스에 직접 가입하는 일은 범위가 다르다.
요금 조건도 알아 둘 것이 있다. 두 모델은 커서 입장에서 외부(서드파티) 모델이라 요금제에 포함된 기본 사용량으로는 쓰지 못한다. The X Subscription에서는 Premium(월 $30) 이상 단계에서 열리고, 미리 충전한 크레딧에서 API 정가만큼 빠져나간다. 정가는 Meta 직접 API 가격과 같다. Free와 Plus(월 $8)에서는 외부 모델을 쓸 수 없다. Pro, Pro+ 같은 예전 커서 요금제는 Other Models 사용량에서 차감되고, 이때 Muse Spark 1.3은 Max Mode가 필요하다. Teams와 Enterprise는 토큰 100만 개당 $0.25의 Cursor Token Rate가 더 붙고, Meta 모델이 나오기 전에 모델 접근을 설정해 둔 팀은 관리자가 Meta 제공자를 켜야 구성원에게 모델이 보인다.
모델을 고르는 순서는 다음과 같다.
- 커서에서 에이전트 채팅을 연다.
- 입력창 아래에 있는 모델 이름을 누른다.
- 목록의 Other Models 칸으로 내려가거나, 맨 위 Search models 칸에 Muse를 입력한다.
- Muse Wonder 또는 Muse Spark 1.3을 누른다. Muse Spark 1.3은 커서 모델 목록에서 기본으로 숨겨져 있어, 보이지 않으면 모델 설정에서 켜야 할 수 있다.
- 옆에 뜨는 작은 창에서 Context(문맥 크기)와 Reasoning(추론 강도)을 정한다. 추론 강도는 minimal, low, medium, high, extra high, max 여섯 단계이고 기본은 high다.
두 모델 모두 긴 도구 호출, 여러 단계의 디버깅, 큰 저장소 작업 같은 에이전트 코딩용으로 소개되고, 커서의 에이전트 도구를 전부 쓴다. Muse Wonder는 이미지 입력을 받으며, 도구가 찍어 돌려준 스크린샷도 입력으로 읽는다.
| 모델 | 커서 가격 (100만 토큰, 입력/캐시 읽기/출력) | 기본 문맥 | CursorBench 4.0 high | CursorBench 4.0 max |
|---|---|---|---|---|
| Muse Spark 1.3 | $1.25 / $0.15 / $4.25 | 300k | 33.4% (과제당 $1.66) | 41.6% (과제당 $2.64) |
| Muse Wonder | $4 / $0.20 / $20 | 300k | 46.1% (과제당 $3.51) | 50.4% (과제당 $5.25) |
문맥 크기는 Meta API와 다르게 보인다. Meta 문서는 두 모델의 문맥을 1,048,576토큰으로 안내하지만, 커서는 기본 300k 토큰으로 쓰고 Max Mode에서 1M까지 연다. 필자 화면에서도 Muse Spark 1.3의 설명 창에는 300k가, Muse Wonder의 작은 창 Context 항목에는 1M이 표시됐다. 300k든 1M이든 토큰 단가는 같고, 긴 문맥 할증이나 캐시 쓰기 요금도 없다. 커서가 기본값을 300k로 둔 이유는 문서에 나와 있지 않다.
어느 쪽을 고를지는 비용과 점수를 같이 봐야 한다. CursorBench 4.0(커서가 실제 커서 작업에서 뽑아 만든 자체 시험)의 기본값 high에서 Spark 1.3은 33.4%에 과제당 약 $1.66, Wonder는 46.1%에 약 $3.51이다. 같은 시험에서 Grok 4.7 Extra High는 46.3%(과제당 $6.01), Composer 2.5는 27.7%(과제당 $0.68)였다. 간단한 작업이라면 추론 강도를 low나 minimal로 내려 더 빠르고 싸게 돌릴 수 있다. 커서는 작은 점수 차이는 통계적으로 의미가 없을 수 있다고 덧붙였다. 덧붙여 Spark 1.3 설명 창에는 Meta의 주력 모델이라고 나오지만, 지금 커서 문서는 Spark 1.3을 이전 주력 모델로 적고 Muse Wonder를 권한다.
오픈라우터에서 쓰는 방법
오픈라우터(OpenRouter)는 여러 회사의 AI 모델을 API 키 하나와 같은 요청 형식으로 부를 수 있게 해 주는 중개 서비스다. Muse 모델도 올라 있다. Muse Spark 1.3의 모델 ID는 meta/muse-spark-1.3, Muse Wonder는 meta/muse-wonder다. 입력이 학습에 쓰일 수 있는 대신 싼 meta/muse-spark-1.3-contributor도 따로 있다. Muse Wonder Full은 목록에 없다.
| 모델 ID | 입력 | 캐시 읽기 | 출력 | 문맥 | 출시일 표기 |
|---|---|---|---|---|---|
| meta/muse-spark-1.3 | $1.25 | $0.15 | $4.25 | 1,048,576 | 2026년 9월 2일 |
| meta/muse-spark-1.3-contributor | $0.10 | $0.002 | $0.20 | 1,048,576 | 2026년 9월 2일 |
| meta/muse-wonder | $4 | $0.20 | $20 | 1,048,576 | 2026년 10월 12일 |
세 모델 모두 제공자(provider)가 Meta 한 곳이다. 오픈라우터가 요청을 Meta로 그대로 넘긴다는 뜻이고, 토큰 가격도 Meta 직접 API와 같다. 오픈라우터는 토큰 값에 웃돈을 붙이지 않는 대신 크레딧을 살 때 5.5%(최소 $0.80) 수수료를 받는다. 웹 검색 도구를 켜면 검색 1,000회당 $2.50이 붙는다. 한 번 응답의 최대 출력은 943,718토큰으로 표시되고, 추론 강도는 minimal부터 max까지 고를 수 있으며 기본값은 medium이다. 커서의 기본값 high와 다르니 비교할 때 맞춰 두는 편이 좋다.
시작하는 순서는 다음과 같다.
- openrouter.ai에서 계정을 만든다.
- Credits 페이지에서 크레딧을 충전한다. 신용카드, 알리페이, USDC 암호화폐를 받는다.
- 대시보드에서 API 키를 만든다. 키는
sk-or-v1-로 시작한다. - 코드 없이 먼저 써 보려면 오픈라우터 웹 채팅방에서 Muse Wonder나 Muse Spark 1.3을 골라 질문한다.
- 코드에서 부를 때는 OpenAI 호환 방식이라 주소와 모델 ID만 바꾸면 된다.
윈도우라면 PowerShell을 열고 아래 명령으로 키를 환경 변수에 넣는다.
$env:OPENROUTER_API_KEY="sk-or-v1-여기에_발급받은_키"같은 PowerShell 창에서 openai 패키지가 설치된 파이썬으로 아래 코드를 실행하면 Muse Spark 1.3의 답이 출력된다. 모델 ID를 meta/muse-wonder로 바꾸면 Wonder를 부른다.
import os
from openai import OpenAI

client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=os.environ["OPENROUTER_API_KEY"])
r = client.chat.completions.create(
    model="meta/muse-spark-1.3",
    messages=[{"role": "user", "content": "이 파이썬 함수의 버그를 찾아 줘: def add(a, b): return a - b"}],
)
print(r.choices[0].message.content)
한국에서 오픈라우터로 Muse Wonder를 호출할 수 있는지는 2026년 10월 21일 기준 공식 문서로 확인되지 않았다. 오픈라우터 모델 페이지에는 국가별 제한 안내가 없지만, 제공자가 Meta 하나뿐이라 Meta 쪽 지역 통제가 적용될 여지는 남아 있다. 한국에서 Wonder까지 열리는 것이 필자 화면으로 확인된 경로는 커서다. 오픈라우터는 크레딧을 크게 넣기 전에 소액으로 한 번 호출해 보는 편이 안전하다. 미사용 크레딧 환불은 결제 후 24시간 안에만 요청할 수 있다.
토큰 가격과 작업 한 건의 비용
단가의 단위는 토큰 100만 개다. Spark 1.3의 이 가격은 1.2와 같다. Wonder Full의 토큰당 공식 가격은 공개되지 않았다.
| 모델 | 입력 | 캐시 입력 | 출력 | 판매 방식 |
|---|---|---|---|---|
| muse-spark-1.3 | $1.25 | $0.15 | $4.25 | 표준. 학습에 사용하지 않음 |
| muse-spark-1.3-contributor | $0.10 | $0.002 | $0.20 | 학습에 쓰일 수 있음 |
| muse-wonder-1.0 | $4.00 | $0.20 | $20.00 | 표준만. preview |
| Muse Wonder Full | 없음 | 없음 | 없음 | Muse Code 구독만 |
Wonder의 입력 $4, 출력 $20은 Claude Opus 5.5와 같다. Artificial Analysis와 VentureBeat는 이 가격이 GPT-6 Astra와 Claude Fable 5.1의 입력 $10, 출력 $50보다 60% 낮다고 적었다. Claude Sonnet 5.5와 GPT-6 Sol은 입력 $2, 출력 $10이다. Gemini 4 Argon은 도입 가격이 입력 $2, 출력 $10이었고, 이후 입력 $4, 출력 $20이다.
Muse Code 구독은 월 단위다. 5시간과 주 단위로 사용량이 초기화된다.
| 플랜 | 월 요금 | 사용량 | 포함 모델 |
|---|---|---|---|
| Everyday Usage | $5 | 5시간당 프롬프트 10-50개, 음성, 웹 검색 | Spark, Wonder, Muse Image |
| High Usage | $15 | Everyday의 5배 | Everyday와 같은 모델 범위 |
| Power Usage | $50 | Everyday의 20배, 업로드 한도 확대, 초기 기능 | Wonder Full 포함 |
| Maximum Usage | $200 | Everyday의 80배 | Wonder Full 포함 |
Everyday의 10개에서 50개 프롬프트에는 이미지와 영상 업로드가 들어간다. High는 그 사용량의 5배, Power는 20배, Maximum은 80배다. Power와 Maximum만 Wonder Full을 포함한다. 플랜 표에 Wonder가 있어도 한국 Muse Code에서는 Wonder 계열이 열리지 않는다. 구독은 Contributor가 기본으로 켜져 사용량이 더 많고, 설정에서 끌 수 있다. 끈 설정은 그 다음 제출부터 적용된다고 VentureBeat가 적었다. 무료 등급이 없다는 기록은 OrcaRouter의 2차 자료다.
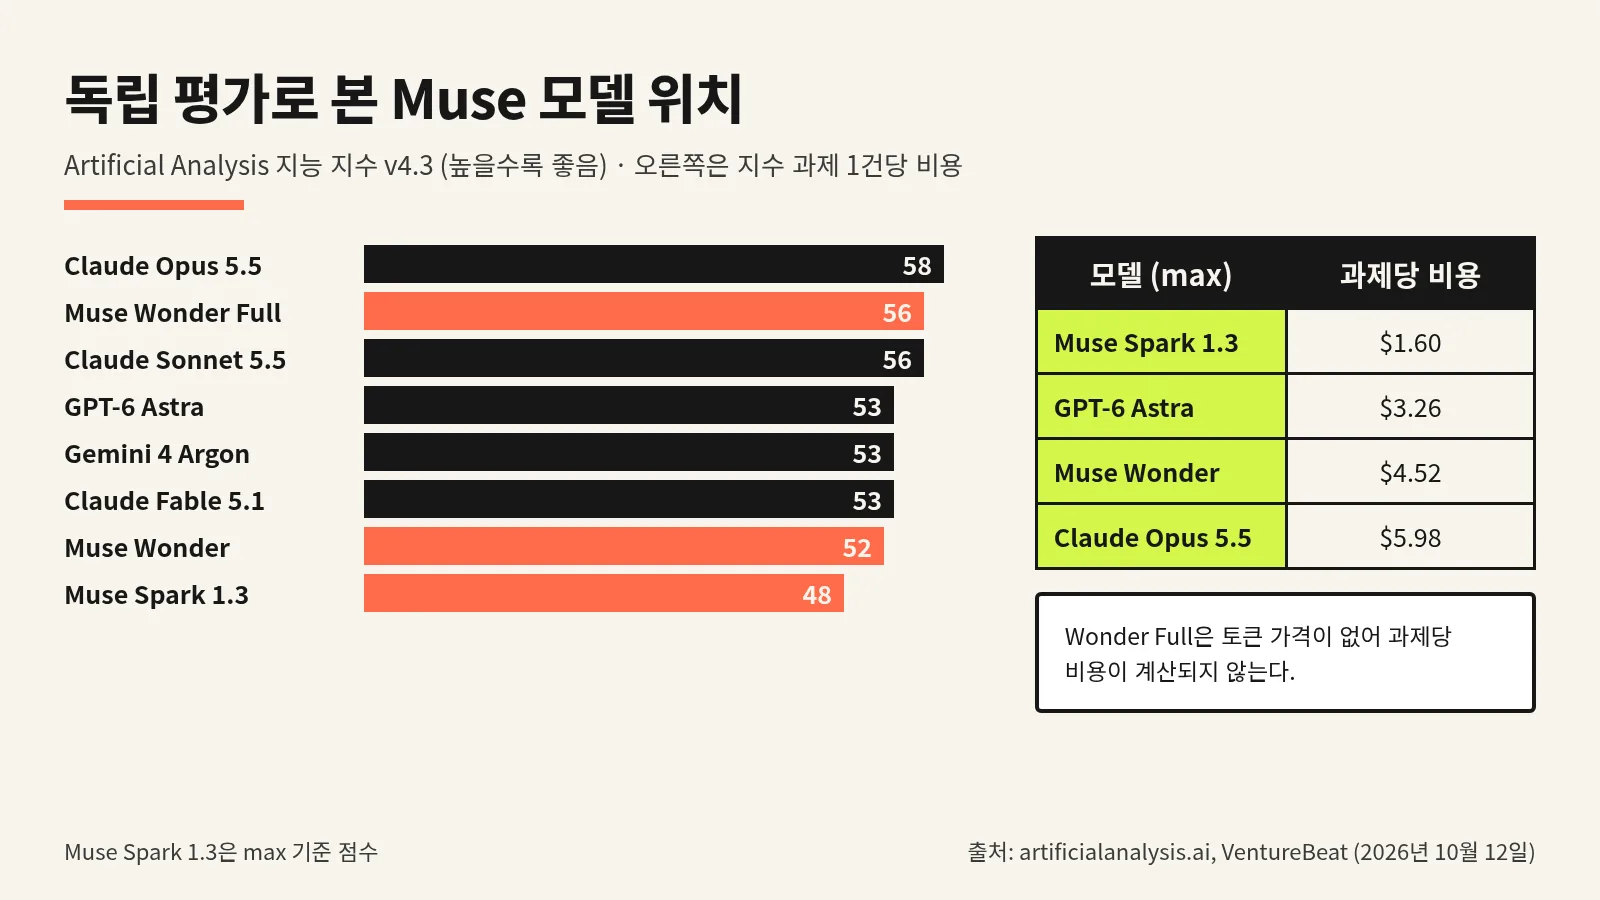
작업 한 건의 비용은 토큰 단가와 다른 줄이다. Artificial Analysis가 지수 과제 하나를 돌릴 때 든 돈을 적었다. 9월 판과 10월 판을 한 칸의 인상분처럼 읽으면 숫자가 어긋난다.
| 모델과 강도 | 작업 1건 비용 | 어느 비교인가 |
|---|---|---|
| Spark 1.3 xhigh | $0.55 | 2026-09-02. 당시 59점 이상 중 최저 |
| GPT-5.6 Sol max | $0.95 | 2026-09-02 같은 글 |
| Spark 1.2 | $0.40 | 같은 9월 글이 적은 이전 모델 |
| Spark 1.3 max | $1.60 | 2026-10-12 지수 v4.3 |
| GPT-6.1 Sol max | $0.72 | 2026-10-12 같은 판 |
| Gemini 4 Argon high | $1.99 | 2026-10-12 같은 판 |
| GPT-6 Astra | $3.26 | 2026-10-12 같은 판 |
| Wonder max | $4.52 | 2026-10-12. 입력 토큰 7.69M |
| Opus 5.5 | $5.98 | 2026-10-12 같은 판 |
9월 2일 글에서 xhigh의 작업당 비용 0.55달러는, 당시 지수 59점 이상인 모델 가운데 가장 낮았다. 같은 글의 GPT-5.6 Sol max는 0.95달러다. Spark 1.2는 작업당 0.40달러였고, 1.3은 에이전트 평가에서 입력 토큰을 약 57% 더 썼다. 10월 12일 v4.3 비교는 max 기준이다. Spark 1.3 max가 1.60달러, Wonder max가 4.52달러, Opus 5.5가 5.98달러, GPT-6 Astra가 3.26달러, Gemini 4 Argon high가 1.99달러, GPT-6.1 Sol max가 0.72달러다. Wonder가 단가 차이만으로 설명되지 않는 이유로 AA는 작업당 입력 토큰 7.69M을 든다. $0.55와 $1.60은 추론 강도와 지수 버전이 달라, 같은 항목이 오른 금액이 아니다. Full의 작업당 비용은 이 비교에 없다.
Meta 발표 수치와 독립 평가
모델 페이지와 개발자 블로그의 표는 Meta 발표 수치다. Spark 1.3 평가 방법론은, 자체 평가와 리더보드와 다른 회사의 자체 보고 가운데 비교 가능한 가장 높은 값을 고른다고 적는다. 그래서 표의 1위는 같은 날 같은 하네스로 다시 잰 공동 실험이 아니다. Artificial Analysis 숫자는 그 아래에 따로 둔다.
아래 표는 Muse Spark 모델 페이지의 발표 수치다. 열은 Spark 1.3 max, Spark 1.2 xhigh, GPT 5.6 Sol max, Opus 5 max다.
| 벤치마크 | Spark 1.3 max | Spark 1.2 xhigh | GPT 5.6 Sol max | Opus 5 max |
|---|---|---|---|---|
| GDPVal-AA v2 (지식 노동, Elo) | 1754 | 1615 | 1710 | 1824 |
| JobBench (직업 도구 사용) | 64.9 | 61.6 | 45.4 | 65.7 |
| OSWorld 2.0 partial / binary | 66.9 / 32.0 | 47.6 / 17.9 | 62.7 / 27.3 | 68.3 / 31.4 |
| DeepSWE v1.1 (긴 코딩) | 75.4 | 55.0 | 73.0 | 74.0 |
| Terminal-Bench 2.1 | 88.8 | 82.9 | 88.8 | 86.7 |
| MRCR 512K-1M (긴 문맥) | 98.1 | 55.5 | 73.8 | - |
지식 노동 Elo는 1.2의 1615에서 1.3 max 1754로 올랐다. GPT 5.6 Sol max 1710보다 높고, Opus 5 max 1824보다는 낮다. 컴퓨터 사용 OSWorld 2.0의 partial은 47.6에서 66.9, binary는 17.9에서 32.0이다. Opus 5의 partial 68.3, binary 31.4와 나란히 보면 partial은 Opus가 조금 높고 binary는 Spark가 조금 높다. 긴 코딩 DeepSWE v1.1은 55.0에서 75.4로, 표에서는 GPT 73.0과 Opus 74.0보다 높다. Terminal-Bench 2.1은 88.8로 GPT와 같고, 1.2의 82.9와 Opus 86.7보다 높다. 긴 문맥 MRCR 512K-1M은 55.5에서 98.1이다. 256K-512K 구간은 66.3에서 98.5다.
같은 페이지의 다른 칸도 방향이 한결같지는 않다. DeepSearchQA는 1.3 max 90.3, 1.2 xhigh 85.9, Opus 5 max 90.4, GPT 5.6 Sol max 93.1이다. 브라우징에서는 GPT가 앞에 있다. 지시 이행 내부 지수 Agentic IF는 46.2에서 57.8로 올랐으나 GPT 60.5, Opus 59.1보다는 낮다. AutomationBench는 38.2에서 49.6으로 올라 GPT 46.7을 넘고 Opus 50.3에는 약간 못 미친다. 코드베이스 이해 SWEAtlas는 46.2에서 59.4로, GPT 53.5와 Opus 52.7보다 높다.
VentureBeat가 전한 1.3끼리의 xhigh와 max도 페이지의 1.2 비교와 짝이 다르다. GDPval-AA는 xhigh 1709, max 1754다. OSWorld 2.0은 57.2와 66.9, JobBench는 61.2와 64.9다. Terminal-Bench 2.1만 xhigh 89.2가 max 88.8보다 높다.
독립 평가의 9월 2일 지능 지수는 xhigh 61, max 62다. Spark 1.2는 8월에 57, 1.1은 7월에 53이었다. 62는 Claude Fable 5 max와 같고, Claude Opus 5 max 63, Claude Fable 5.1 max 66보다는 낮다. xhigh 61은 GPT-5.6 Sol max, Claude Opus 5 high와 같은 줄이었다. 이 max 점수는 당시 제한된 프리뷰를 잰 값이다. Tau3-Bench Banking에서는 max가 52%로 당시 전체 1위였고 xhigh는 47%였다. 1.2는 35%였다. Terminal-Bench 2.1은 AA 측정에서 80%에서 85%(xhigh)로 올랐다. Meta 표의 88.8은 max이고 측정 주체가 다르다. GPQA Diamond는 90%에서 94%, CritPt는 18%에서 26%다. 반대로 AA-LCR은 83%에서 79%로 내려갔다. AA-Omniscience 정확도도 내려갔는데, 답을 보류하는 비율은 늘고 환각은 줄었다.
10월 12일 지수 v4.3에서는 눈금이 바뀐다. Wonder Full max가 56, Wonder max가 52, Spark 1.3 max가 48이다. 같은 판에서 Claude Opus 5.5는 58, Claude Sonnet 5.5는 56, GPT-6 Astra는 53, Gemini 4 Argon은 53, Claude Fable 5.1은 53이다. 9월의 62와 10월의 48은 지수 버전이 달라, 점수가 내려갔다고 이어서 읽으면 틀린다.
핵심 포인트: 모델 페이지의 점수는 Meta 발표 수치다. 비교값은 자체 평가, 리더보드, 다른 회사의 자체 보고 중 높은 쪽을 고른 것이다. Artificial Analysis의 9월 지수 62와 10월 지수 v4.3의 48은 버전이 달라 같은 점수로 나란히 읽지 않는다. Spark 시절의 Terminal-Bench 2.1과 Wonder 시절의 Terminal-Bench 4.0도 이름이 같은 시험이 아니다.
Wonder 블로그의 표도 Meta 발표 수치다. 열은 Wonder Full, Wonder, Claude Fable 5.1, GPT-6 Astra, Claude Opus 5.5이고, 추론 강도는 max다. SWE-Marathon의 Full 칸만 xhigh다.
| 벤치마크 | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| PSI (내부 종합) | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA (법률) | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| HealthBench Pro (건강) | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| OSWorld V2.1 partial / binary | 78.4 / 39.4 | 72.6 / 34.3 | 80.7 / 43.1 | 75.8 / 34.3 | 81.8 / - |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| AA 지수 (Meta 표에 인용) | 56 | 52 | 53 | 53 | 58 |
이 표에서 Full이 앞선 항목은 내부 종합 PSI 59.1, 법률 Harvey LAB-AA 13.1, AutomationBench-AA 45.4, 긴 코딩 DeepSWE 79.0이다. Opus 5.5가 앞선 항목은 Meta 표에 인용된 AA 지수 58, Terminal-Bench 4.0-AA 59.6, HealthBench Pro 65.6, ProgramBench 70.5, OSWorld partial 81.8이다. 건강 질의와 처음부터 짜는 프로그래밍, 컴퓨터 사용의 partial에서는 Full이 1위가 아니다. Wonder의 ProgramBench 50.0은 Fable 55.5와 Astra 52.5보다도 낮다. MemoryBench는 내부 벤치이고 Wonder 85.6, Full 85.5, Fable 79.0, Astra 81.4, Opus 81.5다. Wonder가 Full보다 아주 조금 높다. JobBench는 Full 75.3, Opus 75.4로 거의 같고 Wonder는 70.5, Fable은 73.1, Astra는 66.1이다. 재무 Vals Finance Agent V2는 Full 59.1, Fable 58.9, Opus 58.6, Wonder 56.6, Astra 53.5다. PDF로 하는 업무 GDP.pdf는 Astra 34.2가 Full 33.2보다 높고, Wonder는 30.8, Opus는 30.6, Fable은 27.6이다. PSI와 MemoryBench는 Meta 내부 벤치다.
SWE-Marathon은 같은 방식으로 붙인 비교가 아니다. Full은 xhigh에서 57.5, Wonder는 53.1, Fable 45.6, Astra 42.5, Opus 46.3이다. 경쟁 모델은 Codex와 Claude Code 안에서 돌았다. 숫자로는 Full이 앞서지만, 같은 실행 환경에서 잰 비교로 보기는 어렵다.
AA가 10월 12일에 따로 잰 상승은 Spark 1.3 max와의 차이다. Terminal-Bench 4.0은 33%에서 Full 57%, Wonder 52%다. Meta 표의 57.1과 52.0을 반올림하면 이 퍼센트와 맞닿아 보인다. GDPval-AA v2.1 Elo는 1681에서 Full 1857이다. 9월 모델 페이지의 GDPVal-AA v2 1754와 버전 이름이 다르므로 한 Elo 막대로 잇지 않는다. AutomationBench-AA는 AA 글에서 Spark 58%에서 Wonder 68%, Full 71%이고 Full은 그 판에서 3위다. Meta 표의 AutomationBench-AA 45.4와 39.1은 이 퍼센트와 눈금이 같아 보이지 않아 한 열로 합치지 않는다. Full은 CritPt 33%와 GDP.pdf 33%에서 근소하게 1위였고, GDPval-AA v2.1에서는 2위였다.
지식은 상대적 약점이다. AA-Omniscience는 Full 30, Wonder 25이고, Opus 5.5는 46, GPT-6 Astra는 43, Gemini 4 Argon은 42다. 환각 비율은 Full 23%로, 지수 45 이상 모델 가운데 Gemini 4 Argon 15% 다음으로 낮고 Wonder는 27%다. 아는 폭은 좁고, 모르는 것을 지어내는 비율은 그 집단에서 낮은 편이라는 그림이다.
코딩 에이전트 지수는 제품을 어디에 올렸는지까지 적혀 있다. Muse Code에 Wonder Full을 올린 구성이 68이고, Claude Code에 Sonnet 5.5를 올린 구성과 같다. Wonder는 63, Muse Code에 Spark 1.3 max를 올린 구성은 54다. API 표의 모델 점수와, 코딩 에이전트 안에 넣었을 때의 점수가 다른 줄이라는 뜻이다.
X에 올라온 사용 후기
출시 직후 글은 칭찬과 의심이 같이 있다.
@PawelHuryn은 2026년 9월 13일, 실제 저장소 두 곳에 심어 둔 버그 105개로 Spark 1.3을 시험했다. max는 33점이었고 Claude Fable 5.1 high와 같았다. Opus 5 max는 27점이었다. high 설정은 19점이었다. 그는 Meta가 상위권에 들어왔다고 보았다. @KaminskyPavel은 2026년 9월 15일, 개인 프로젝트는 Contributor로 두고 업무는 표준으로 둔다고 적었다. High Usage 플랜에서 Rust와 TypeScript를 쓰며 만족한다는 글이다. @CommanderROR9는 2026년 9월 7일, Hermes Agent 안에서 1.3이 Gemini 3.8 Flash보다 더 일에 붙어 있다고 느꼈다. @arena는 2026년 9월 8일, 1.3 max가 Code Arena WebDev에서 가격 대비 성능의 앞줄을 다시 그었다고 보았다.
반대쪽도 같은 주에 나왔다. @JohnKlerAI는 2026년 9월 7일, 1.3이 벤치마크에 과하게 맞춰진 느낌이 있다고 적었다. @VulKan42069는 2026년 9월 11일, 표준 1.3 max가 본인에게는 비싸고 Contributor에도 max가 있으면 좋겠다고 적었다. 문서상 Contributor id에 max가 없다는 점과 맞는 불만이다. @SPAC89는 2026년 9월 8일, 1.3 max로 계획을 세운 뒤 싼 1.3 xhigh Contributor 하위 에이전트로 실행하면 비용을 90%보다 많이 줄일 수 있다고 제안했다. 개인이 올린 비용 제안이지 공식 측정은 아니다.
Wonder가 나온 뒤 @PawelHuryn은 2026년 10월 13일 같은 버그 시험을 다시 적었다. GPT-6 Astra max 45.0, Opus 5.5 max 41.7, Spark 1.3 max 32.2, Wonder 1.0 max 31.7이었다. API로 부른 Wonder는 이 시험에서 Spark 1.3을 넘지 못했다. @dummerspast39는 2026년 10월 12일, 좋아요 49개가 붙은 글과 이어지는 글에서, Meta가 Full 점수를 앞에 세우지만 API에는 보통 Wonder만 있고 그 Wonder는 Meta 자신의 AA 지수 칸에서 맨 뒤라고 비판했다. Opus 5.5와 토큰 가격이 같은데 더 약하다는 지적도 있었다. Meta 표의 AA 지수 칸은 Full 56, Fable 53, Astra 53, Wonder 52, Opus 58이라 그 지적이 칸과 어긋나지는 않는다. @eddieor는 2026년 10월 13일, Wonder와 Opus 5.5와 GPT-6.1 Sol로 빌드 세 번을 돌렸더니 테스트는 모두 통과했지만 Wonder 청구액이 약 80% 더 높았다고 적었다. 토큰 단가는 Opus와 같았다고 했다.
속도와 신중함에 대한 글도 갈린다. @Fuwned는 2026년 10월 13일 Forth 인터프리터 시험에서 Wonder가 매우 빠르지만 조금 헐겁고, GPT-6.1 Sol은 느리지만 신중했다고 비교했다. @VulcanBench는 2026년 10월 14일, Low 강도에서 Wonder가 생각을 과하게 하는 것 같다고 적었다. @rails는 2026년 10월 15일 Agents on Rails 시험에서 Wonder xhigh의 성공률이 46.6%로 하위 절반이었다고 적었다. @bvilhjal는 2026년 10월 13일, Full max는 괜찮아 보였고 Wonder xhigh는 실망스러우며 보정이 어긋난 느낌이었다고 적었다.
이름을 섞지 말라는 글이 여러 개다. @Divine_machine은 2026년 10월 13일, Wonder와 Wonder Full이 매우 다르니 하나로 뭉개지 말라고 적었다. @alexmorris10x는 2026년 10월 14일, Full보다 훨씬 약해서 이름을 Muse Wonder Small로 불러야 한다는 농담을 올렸다. @maropetignat는 2026년 10월 12일, 이름 때문에 다른 쪽을 시험해 보고 나쁘다고 말하는 반응이 나올 것이라고 적었다. @eliebakouch는 2026년 10월 15일 구독 사용량으로 Full의 토큰 가격을 추정했다. 공식 토큰 가격은 확인되지 않았다.
아레나 순위는 X에 올라온 2차 전언이다. Meta나 Artificial Analysis의 표는 아니다. @defaiscope는 2026년 10월 14일 Wonder max가 텍스트 아레나 2위이고 Gemini 4 Argon에 12점 뒤이며, Code Arena WebDev에서는 15위라고 적었다. @maga_musk는 WebDev 아레나 데뷔가 15위, 1651점이라고 적었다. @Chaosai0는 에이전트 아레나 데뷔가 12위라고 적었다. 한국어 게시물도 같은 주를 옮겼다. @kdw9804는 Wonder API의 id와 입력 $4, 캐시 $0.20, 출력 $20, 맥락 1M을 요약했다. @NURadu_는 지능 지수와 작업당 비용 표를 옮겼다.
콘텐츠와 바이브 코딩에서 되는 일과 한계
긴 글과 영상을 넣는 분석은 두 모델의 입력 범위 안에 있다. 글, 이미지, 영상, PDF를 받고 글로 답한다. 슬라이드와 보고서, 표 계산 파일의 요약이 시연의 중심에 있다.
Spark 1.3 블로그가 보여 준 일은 네 가지다. 시뮬레이션 데이터와 CAD 파일로 유체 해석 보고서 PDF를 만든 일, 베이스 음원 트랙을 고치고 믹싱한 일, 8장에서 10장 분량의 설득용 슬라이드, 엑셀의 민원성 피드백을 PDF 요약으로 바꾼 일이다. Muse Code 1.2 시연에서는 공간을 훑는 mp4로 휴가용 임대 숙소의 홍보와 예약 페이지를 만들었다. 그 시연은 1.2 시절의 것이고 1.3의 점수로 바꾸어 읽을 일은 아니다.
음성은 여기서 문서와 시연이 어긋나 보인다. Spark 1.3 문서는 음성 입력이 완전히 지원되지 않으며 품질이 떨어질 수 있다고 적고, 음성이 필요하면 Spark 1.2나 Muse Voice Transcribe를 쓰라고 한다. 그런데 1.3 블로그 시연에는 베이스 트랙 편집이 들어 있다. 시연이 있다고 해서 음성 입력이 안정하다고 적힌 것은 아니다. Wonder와 Wonder Full의 입력 목록에는 음성이 올라 있고, 1.3에 붙은 그 단서가 Wonder 문장으로 반복되지는 않는다.
Wonder 시연에는 이미지로 만든, 플레이할 수 있는 3D 주방 게임, 브라우저에서 여러 앱을 오가며 토요일 달리기를 짠 일, 인스타그램 사진으로 기념품을 디자인하고 주문한 일, 제약이 많은 결혼식 좌석 배치, 건강 관련 지원, 보험 청구가 있다. 모델 카드는 시각과 공간 추론, 특히 3D가 알려진 약점이라고 적는다. 주방 게임이 시연에 있다는 사실과, 3D가 약점이라는 문장은 둘 다 공식 기록이다. 시연이 약점 문장을 지우지는 않는다.
역할을 나누는 문장도 문서에 있다. 파일이 여러 개인 수정, 몇 시간에 걸친 실행, 여러 에이전트의 조율처럼 능력이 비용을 앞서는 일에는 Wonder를 둔다. 양이 많고 지연이나 비용에 민감한 일, 분류, 도구를 짧게 반복하는 일에는 Spark를 둔다. 성적 자체는 하네스와 도구 구성에 따라 달라진다고 모델 카드가 적는다.
비용을 줄이려고 강한 모델로 계획을 잡고 Contributor 하위 작업으로 실행하자는 제안은 X에 있다. 그 제안의 절감 비율은 공식 측정이 아니다. Meta 약관은 Contributor 모드에 비밀 정보와 개인 정보를 넣는 것을 금지한다. 고객 문서나 비공개 저장소를 그 모드에 넣는 일은 이 금지에 걸린다.
마무리
앞에서 다룬 Muse Spark 1.3과 Muse Wonder의 핵심만 짧게 정리한다.
- Spark 1.3은 2026년 9월 2일, Wonder와 Wonder Full은 2026년 10월 12일에 나온 글 답변 모델이다. 이미지를 생성하는 모델이 아니다.
- 한국에서는 커서로 Muse Wonder와 Muse Spark 1.3을 모두 쓸 수 있다. 커서 Premium(월 $30) 이상 구독에서 API 정가로 크레딧이 차감되고, 기본 문맥은 300k, Max Mode에서 1M이다.
- Meta 직접 경로에서는 Wonder와 Full이 한국의 Model API와 Muse Code에 없고, Spark 1.3은 지역 제한 목록에 없다. 오픈라우터는 같은 단가로 두 모델을 열어 두었지만 한국 호출은 공식 확인 전이다.
- 표준 Spark는 토큰 100만 개당 입력 $1.25, 출력 $4.25다. Contributor는 훨씬 싸지만 학습에 쓰일 수 있고 max가 없다.
- Wonder의 토큰 가격은 입력 $4, 출력 $20이다. Full은 API에 없고, Wonder에서 max를 골라도 Full이 되지 않는다. Full은 Muse Code 월 $50과 월 $200 구독이다.
- 모델 페이지 점수는 Meta 발표 수치다. Artificial Analysis의 9월 지수 62와 10월 지수 48은 버전이 다르다.
- Spark 1.3의 음성 입력은 완전 지원이 아니고, Wonder의 3D와 공간 추론은 모델 카드가 약점으로 적는다.
「한국에서 Muse Wonder를 바로 써 보려면 커서가 가장 확실한 길이고, Wonder의 점수는 Full과 API용 Wonder를 나눠 읽어야 한다.」
비밀이 있는 코드와 문서는 학습에 쓰지 않는다고 적힌 표준 모드 쪽에 둔다. Full의 표 점수를 API에서 부르는 Wonder의 성적으로 옮기면 상품이 달라진다.
출처와 링크
수치와 정책의 출처는 아래 문서다. 조사 기준은 2026년 10월 21일이다.
- Muse Spark 1.3 모델 페이지
- Meta Model API 모델 문서
- Muse Spark 1.3 소개 (2026-09-02)
- Muse Wonder 연구 블로그 (2026-10-12)
- Muse Wonder 개발자 블로그
- Muse Wonder 모델 카드
- Spark 1.3 평가 방법론
- API 가격 문서
- 지역 사용 정책 (2026-10-12 갱신)
- Artificial Analysis, Muse Spark 1.3
- Artificial Analysis, Muse Wonder
- VentureBeat, Muse Spark 1.3
- VentureBeat, Muse Wonder
- TechCrunch, Muse Wonder
- CNBC, Muse Wonder
- Muse Code 문서
- Muse Code 요금
- Muse Code와 Spark 1.2 소개
- Muse Spark 첫 소개
- AI타임스, 메타 AI 국내 출시
- Meta 도움말, Muse 구독
- 커서, Muse Spark 1.3 추가 발표 (2026-09-08 UTC)
- 커서, Muse Wonder 추가 발표 (2026-10-15 UTC)
- 커서 문서, Muse Wonder
- 커서 문서, Muse Spark 1.3
- CursorBench
- OpenRouter, Muse Wonder
- OpenRouter, Muse Spark 1.3
- OpenRouter FAQ
- OrcaRouter, Muse Code 무료 등급 (2차)
- AI Creator Lab, 뮤즈 한국 출시 여부 (2차, 2026-10-16)
FAQ
자주 묻는 질문
한국에서 Muse Wonder를 쓸 방법이 있나요?
있습니다. 커서(Cursor)에서는 한국에서도 모델 목록의 Other Models에서 Muse Wonder와 Muse Spark 1.3을 고를 수 있고, 필자 화면에서도 두 모델이 선택됐습니다. Meta 문서가 한국 미제공이라고 적은 범위는 Meta가 직접 운영하는 Model API와 Muse Code입니다. 커서는 Premium(월 30달러) 이상 구독에서 API 정가로 크레딧이 차감되며, VPN 등으로 Meta의 지역 통제를 우회하는 것은 Meta 정책이 금지합니다.
커서에서 Muse 모델을 쓰려면 어떤 요금제가 필요한가요?
커서 문서 기준 Muse 모델은 외부 모델이라 요금제의 기본 포함 사용량으로는 쓰지 못합니다. The X Subscription에서는 Premium(월 30달러) 이상에서 열리고, 미리 충전한 크레딧에서 Meta API와 같은 정가가 빠져나갑니다. Free와 Plus(월 8달러)는 쓸 수 없고, Teams와 Enterprise는 토큰 100만 개당 0.25달러가 더 붙습니다.
커서에서는 왜 문맥이 300k로 나오나요?
커서는 Muse Wonder와 Muse Spark 1.3을 기본 300k 토큰 문맥으로 쓰고, Max Mode에서 1M까지 엽니다. Meta API와 오픈라우터는 1,048,576토큰으로 안내합니다. 300k든 1M이든 토큰 단가는 같고 긴 문맥 할증도 없지만, 커서가 기본값을 300k로 둔 이유는 문서에 나와 있지 않습니다.
오픈라우터에서 Muse 모델을 쓰려면 어떻게 하나요?
openrouter.ai에서 가입하고 Credits 페이지에서 크레딧을 충전한 뒤 API 키를 만들면 됩니다. 모델 ID는 meta/muse-wonder와 meta/muse-spark-1.3이고, 토큰 가격은 Meta 직접 API와 같으며 크레딧 구매 때 5.5%(최소 0.80달러) 수수료가 붙습니다. 한국에서의 호출은 공식 문서로 확인되지 않았으니 소액으로 먼저 시험하는 편이 안전합니다.
커서의 Muse Wonder는 화면 캡처를 입력으로 받나요?
받습니다. 커서 문서는 Muse Wonder가 이미지 입력을 지원하고, 도구가 돌려준 스크린샷도 입력으로 읽는다고 적습니다. 두 모델 모두 커서의 에이전트 도구를 전부 쓸 수 있으며, 긴 도구 호출과 여러 단계의 디버깅, 큰 저장소 작업에 맞춰 소개됩니다.
Muse Spark 1.3 API의 요청 한도는 얼마인가요?
Meta 가격 문서 기준 표준 muse-spark-1.3은 분당 3,000회 요청, 분당 400만 토큰까지 처리합니다. 값싼 muse-spark-1.3-contributor는 분당 150회 요청, 분당 300만 토큰으로 요청 횟수 한도가 훨씬 낮습니다. 짧은 요청을 대량으로 보내는 서비스라면 단가만 보지 말고 이 요청 한도부터 비교하는 편이 안전합니다.
Muse Spark 1.3은 긴 문맥을 넣으면 요금이 더 붙나요?
Meta 가격 문서에는 긴 문맥 할증이 없다고 적혀 있어, 100만 토큰 가까이 넣어도 같은 토큰 단가가 적용됩니다. 다만 웹 검색 그라운딩 도구를 켜면 검색 1,000회당 2.50달러가 따로 붙습니다. 검색을 자주 부르는 에이전트라면 토큰 비용과 검색 비용을 나눠서 계산해야 합니다.
Muse Wonder Full의 토큰 가격은 얼마로 예상되나요?
Meta는 Wonder Full을 API로 팔지 않아 공식 토큰 가격이 없습니다. X에서 @eliebakouch가 구독 사용량으로 추정한 값은 Wonder의 약 2배, 즉 입력 8달러와 출력 40달러 수준이지만 이는 개인 추정치로 확인된 가격이 아닙니다. 실제로 쓰려면 Muse Code의 Power(월 50달러)나 Maximum(월 200달러) 구독이 유일한 경로입니다.
Muse 모델 중에 직접 내려받아 쓸 수 있는 오픈 모델도 있나요?
Meta는 2026년 8월 10일 Apache 2.0 라이선스의 300억 파라미터 오픈 가중치 모델 Muse Glimmer를 공개했습니다. 2026년 10월 15일에는 전체 8,160억 파라미터 중 420억 개만 활성화되는 MoE 구조의 Muse Spark Open도 가중치를 공개했습니다. Muse Spark 1.3과 Muse Wonder 자체는 가중치가 공개되지 않은 API 전용 모델입니다.
소비자용 Muse 앱 구독은 Muse Code 구독과 같은 건가요?
다른 상품입니다. Meta 도움말 기준 소비자용 Muse 앱은 무료 등급 외에 월 20달러 Power(주당 Muse 토큰 5억 개)와 월 100달러 Maximum(주당 30억 개) 구독이 있습니다. 반면 Muse Code는 월 5달러부터 200달러까지 네 단계라서, 코딩 에이전트를 쓰려면 Muse Code 요금제를 따로 봐야 합니다.
Muse Wonder Full은 안전성 평가에서 어떤 결과를 받았나요?
Muse Wonder 모델 카드는 Full이 화생방, 사이버, 통제 상실 영역에서 완화 조치 후 잔여 위험이 보통 이하라고 평가했습니다. 정직성 평가 MASK는 87.3%, 에이전트 비정렬 평가는 0%로 적혀 있습니다. 모델 카드는 18세 미만 사용을 상정하지 않는다고도 밝히고 있습니다.
다른 코딩 도구에서도 Muse Spark 1.3을 쓸 수 있나요?
커서는 2026년 9월 9일(한국 시간) Muse Spark 1.3을, 10월 16일 Muse Wonder를 모델 목록에 넣었습니다. OpenRouter에는 meta/muse-spark-1.3이 출시일과 같은 9월 2일 날짜로 올라 있습니다. X 게시물에 따르면 Command Code는 /model 메뉴에서 1.3 max를 고를 수 있게 했고, OpenCode 사용량 1위 전언도 있지만 이는 2차 정보라 공식 수치로 보기는 어렵습니다.
용어
관련 용어
AI 참여도에 따른 코딩 방식의 연속적 범위를 나타내는 개념 모델. 한쪽 끝에는 개발자가 모든 코드를 직접 작성하는 '완전 수동 코딩(Manual Coding)'이 있고, 반대쪽 끝에는 AI가 독립적으로 소프트웨어를 구축하는 '완전 AI 자율 코딩(Autonomous Development)'이 있으며, 대부분의 실무는 그 사이 어딘가에 위치한다. 일반적으로 Manual Coding → AI-Assisted Coding(자동완성·제안 수준) → Vibe Coding(자연어 기반 코드 생성) → Agentic Engineering(AI 에이전트 자율 작업 + 인간 감독) 순으로 AI 참여도가 높아진다. 중요한 것은 이것이 '진화의 단계'가 아니라 '선택의 스펙트럼'이라는 점이다. 같은 개발자가 같은 프로젝트 내에서도 작업의 성격에 따라 다른 지점을 선택할 수 있다. 예를 들어, 단순 스크립트나 보일러플레이트는 바이브 코딩으로, 핵심 결제 로직이나 보안 관련 코드는 AI 어시스트 + 수동 코딩으로, 대규모 리팩토링은 에이전틱 엔지니어링으로 접근하는 식이다.
AI 모델·프로바이더 클로드Anthropic이 개발한 AI 모델 시리즈로, 안전성(safety), 정직성(honesty), 유용성(helpfulness)을 핵심 원칙으로 설계되었다. 바이브 코딩에서 가장 널리 사용되는 모델 중 하나이며, 깊은 코드 이해, 상세한 설명 생성, 100만 토큰의 업계 최대급 컨텍스트 윈도우가 주요 강점이다. 현재 Claude 4 패밀리로 구성되어 있으며, Claude Opus 4.6(가장 강력한 최상위 모델), Claude Opus 4.5, Claude Opus 4.1, Claude Opus 4, Claude Sonnet 4의 다섯 가지 모델이 있다. Opus 계열은 복잡한 추론과 대규모 코드 분석에, Sonnet 계열은 빠른 응답과 비용 효율에 최적화되어 있다. Claude Code(CLI 도구)를 통해 터미널에서 직접 사용하거나, Cursor·Windsurf 등 제3자 IDE에서 모델로 선택할 수 있다. API 모델 문자열은 'claude-opus-4-6'이며, 웹·모바일·데스크톱 채팅 인터페이스를 통해서도 접근 가능하다. Constitutional AI라는 독자적인 안전 기술로 유해한 출력을 최소화하면서도 유용한 코드 생성을 유지하는 것이 특징이다.
AI 모델·프로바이더 GPTOpenAI가 개발한 생성형 사전훈련 트랜스포머(Generative Pre-trained Transformer) 모델 시리즈로, 현대 AI 혁명의 핵심 기술이다. 'Transformer'는 2017년 Google이 발표한 신경망 아키텍처이며, GPT는 이를 '생성(Generative)' 목적으로 '사전 훈련(Pre-trained)'시킨 모델이다. ChatGPT, Codex CLI, GitHub Copilot 등 수많은 AI 제품의 기반이 되며, GPT-4, GPT-4o(최적화 버전), o1(추론 특화), o3(고급 추론) 등 다양한 변형이 존재한다. GPT-4는 코드 생성에서 높은 범용성을 보이며, o1/o3 시리즈는 복잡한 논리적 추론이 필요한 알고리즘 문제에 강점이 있다. Cursor, GitHub Copilot, Windsurf 등 대부분의 AI 코딩 도구에서 기본 모델로 제공되며, OpenAI API를 통해 직접 호출할 수도 있다. 바이브 코딩 생태계에서 Claude와 함께 가장 빈번하게 사용되는 모델이며, 특히 GPT-4o는 빠른 응답 속도와 적절한 코드 품질의 균형으로 일상적 코딩 작업에 널리 활용된다.
링크
관련 링크
AI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
VIBE 코딩 보안 테이텀 시큐리티 Threads쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 제품 리서치 Killed by Google · Google GraveyardGoogle이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
관련 글
관련 글
Recommended
Gemini 4 Argon 드디어 공개 | 누가 쓸 수 있고 얼마인지, 윈도우에서 API·Antig…
Gemini 4 Argon(제미나이 4 아르곤)은 구글이 10월 13일(한국 시간 10월 14일 새벽 1시)에 정식으로 풀기 시작한 최상위 AI 모델이다. 지금까지 구글의 가장 강한 모델이던 Gemini 3.1 Pro 다음 세대에 해당하고, 구글은 이 모델을 코딩, 기업 업무, 사이버 보안 방어 세 분야를 겨냥해 만들었다고 설명한다. 이름 끝의 "Argon"은 크기 등급이 아니라 이번 세대 첫 모델에 붙인 이름이다. 한 번의 답변으로 최대 100만 토큰까지 길게 써 내려갈 수 있다는 점이 가장 눈에 띄는 변화다.
바이브 코딩을 하는 사람에게 중요한 질문은 세 가지다. 어디서 쓸 수 있는지, 돈이 얼마나 드는지, 내가 쓰는 도구에 바로 붙일 수 있는지다. 결론부터 말하면 무료로는 쓸 수 없다. Google AI Ultra 구독자이거나, 결제를…
AI 자동화 핵심 API 개념과 유명 사이트 목록 | OpenRouter, Kie, Hugging…
AI API는 내 프로그램이 인터넷 너머의 AI 모델에게 일을 시키고 결과를 돌려받는 통로예요. ChatGPT나 Claude 같은 앱 화면에서 직접 묻는 대신, 자동화 스크립트나 웹 서비스, n8n 같은 도구가 "이 글 요약해 줘", "이 문장으로 이미지 만들어 줘"라고 요청하면 모델이 답을 보내 주는 방식이에요. 블로그 글 초안 만들기, 쇼핑몰 상품 사진 생성, 유튜브 자막 번역, 고객 문의 분류처럼 반복되는 일을 AI에게 맡길 때 거의 항상 이 API를 쓰게 돼요.
문제는 같은 모델을 파는 곳이 너무 많다는 점이에요. 모델을 만든 회사의 공식 API가 있고, 여러 모델을 한 번에 묶어 파는 라우터가 있고, 오픈 모델만 빠르게 돌려 주는 추론 회사와 이미지와 영상만 전문으로 하는 곳도 있어요. 가격 단위도 토큰, 이미지 한 장, 영상 1초,…