바이브코딩
AI 자동화 핵심 API 개념과 유명 사이트 목록 | OpenRouter, Kie, Hugging Face부터 fal, Replicate까지 가격 비교와 소식 채널
API 키, 엔드포인트, 토큰 요금, 속도 제한, 비동기 작업 같은 기본 개념부터 실제로 결제해 쓰는 공급자, 성능과 가격 비교 사이트, 새 모델 소식 채널, 결과물 1개당 비용 계산까지 공식 페이지 기준으로 다룬 AI API 안내
AI API는 내 프로그램이 인터넷 너머의 AI 모델에게 일을 시키고 결과를 돌려받는 통로예요. ChatGPT나 Claude 같은 앱 화면에서 직접 묻는 대신, 자동화 스크립트나 웹 서비스, n8n 같은 도구가 "이 글 요약해 줘", "이 문장으로 이미지 만들어 줘"라고 요청하면 모델이 답을 보내 주는 방식이에요. 블로그 글 초안 만들기, 쇼핑몰 상품 사진 생성, 유튜브 자막 번역, 고객 문의 분류처럼 반복되는 일을 AI에게 맡길 때 거의 항상 이 API를 쓰게 돼요.
문제는 같은 모델을 파는 곳이 너무 많다는 점이에요. 모델을 만든 회사의 공식 API가 있고, 여러 모델을 한 번에 묶어 파는 라우터가 있고, 오픈 모델만 빠르게 돌려 주는 추론 회사와 이미지와 영상만 전문으로 하는 곳도 있어요. 가격 단위도 토큰, 이미지 한 장, 영상 1초, GPU 1초로 제각각이라 표시 가격만 보고 고르면 생각보다 돈이 더 나가거나, 갑자기 요청이 막히는 일이 생겨요.
그래서 처음 AI 자동화를 시작할 때 알아야 할 API 기본 개념을 아주 쉬운 말로 먼저 풀고, 이어서 실제로 결제해서 쓸 수 있는 곳, 모델 성능과 가격을 비교하는 곳, 새 모델 소식을 빨리 전해 주는 곳을 역할별로 나눠 소개해요. OpenRouter, Kie, Hugging Face를 출발점으로 두고 fal, Replicate, Together AI, Fireworks AI, DeepInfra, WaveSpeedAI, Novita AI, 그리고 Google AI Studio, Groq, Artificial Analysis, Arena 같은 곳까지 다뤄요.
가격, 투자, 고객사, 정책은 각 서비스의 공식 페이지와 발표문을 2026년 10월 20일에 다시 열어 확인한 내용이에요. 서비스가 스스로 밝힌 숫자(가동률, 할인율 같은 것)는 따로 "자체 주장"이라고 표시했어요.
AI API는 무엇이고 어떻게 돈을 내나
AI API는 "AI 모델을 빌려 쓰는 창구"라고 생각하면 쉬워요. 내 컴퓨터에 거대한 모델을 설치하지 않아도, 정해진 주소로 요청을 보내면 모델을 가진 회사의 서버가 계산해서 답을 보내 줘요. 사람이 쓰는 앱이 아니라 프로그램이 쓰는 창구라서, 한 번 연결해 두면 밤새 수백 건을 자동으로 처리할 수도 있어요.
AI API에는 이런 특징이 있어요.
- 쓴 만큼 내요. 월 구독료 대신 요청 한 번, 토큰 몇 개, 이미지 몇 장처럼 사용량으로 계산하는 곳이 대부분이에요.
- 열쇠가 필요해요. 가입하면 API 키라는 긴 비밀번호를 받고, 모든 요청에 이 키를 붙여서 "누가 쓰는지"를 증명해요.
- 한 번에 처리할 수 있는 양에 한도가 있어요. 1분에 몇 번, 하루에 몇 번까지라는 속도 제한이 걸려 있어요.
- 같은 모델도 파는 곳마다 값과 속도가 달라요. 오픈 모델은 여러 회사가 동시에 서비스하기 때문이에요.
- 글을 쓰는 모델은 대개 바로 답이 오고, 이미지와 영상은 "접수번호"를 먼저 받고 나중에 결과를 찾아가는 방식이 많아요.
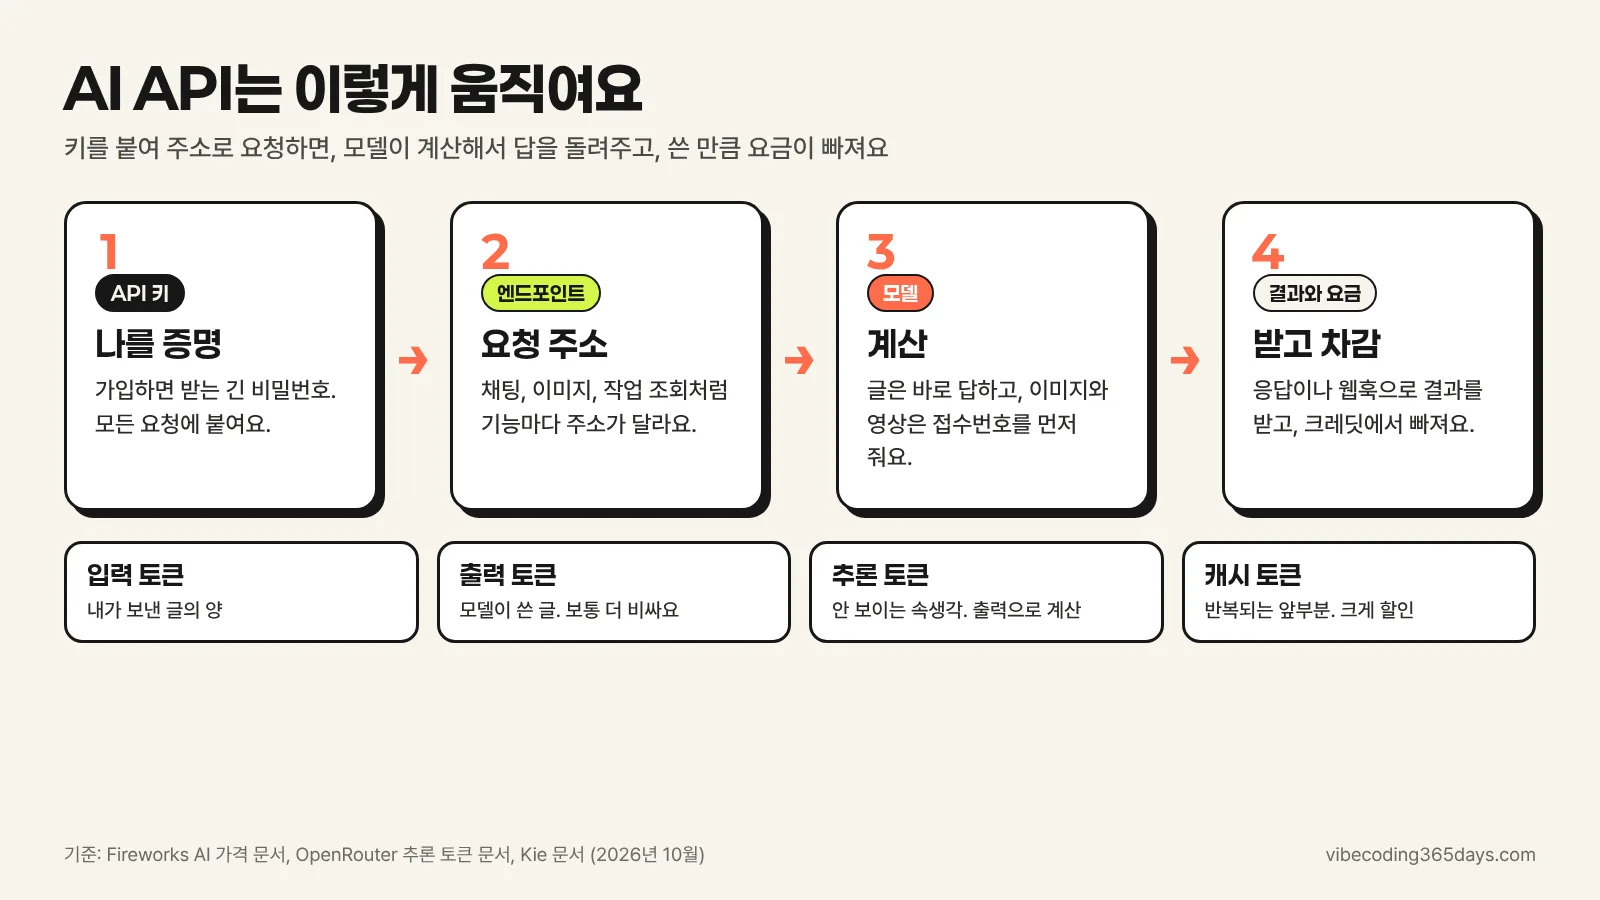
핵심 포인트: AI API는 키를 붙여 주소로 요청을 보내고, 쓴 만큼 돈을 내는 구조예요. 어디서 사느냐에 따라 같은 모델도 가격, 속도, 한도가 달라져요.
처음 시작할 때 알아둘 것
처음에는 "어디서 가입하고, 얼마를 넣고, 무엇을 조심하나" 세 가지만 알면 충분해요.
결제는 대부분 선불 충전 방식이에요. OpenRouter, Kie, DeepInfra 같은 곳은 크레딧을 먼저 사 두고 요청할 때마다 잔액에서 빠져나가요. DeepInfra는 카드 등록이나 선불 충전이 없으면 아예 쓸 수 없고, 대신 지출 한도를 걸어 둘 수 있어요. 무료로 맛보기를 주는 곳도 있어요. WaveSpeedAI는 자격이 되는 신규 계정에 1달러, Runware는 업무용 메일로 가입하면 2달러, Cerebras는 결제수단을 등록하면 30일짜리 5달러 크레딧을 한 번 줘요. Google AI Studio의 Gemini API는 무료 등급이 있지만, 무료 등급에서 보낸 내용은 Google 제품 개선에 쓰일 수 있다고 가격 페이지에 적혀 있어요. 유료 등급은 그렇지 않아요.
API 키는 비밀번호처럼 다뤄야 해요. Kie 공식 문서도 브라우저 코드, 모바일 앱, 공개 저장소에 키를 넣지 말라고 따로 경고해요. 키가 새면 다른 사람이 내 충전금으로 요청을 보낼 수 있으니, 서비스마다 키별 사용 한도나 지출 한도를 걸어 두는 편이 안전해요.
어디에 쓰는지에 따라 출발점도 달라져요.
| 하고 싶은 일 | 먼저 볼 곳 | 이유 |
|---|---|---|
| 글쓰기, 요약, 번역, 코딩 에이전트 | OpenRouter | 한 키로 여러 회사의 모델을 바꿔 가며 써 볼 수 있음 |
| 이미지, 영상, 음악을 싸게 대량 생성 | Kie, fal | 생성형 미디어 모델이 많고 건당 가격이 공개됨 |
| 새로 나온 오픈 모델을 바로 써 보기 | Hugging Face | 모델 페이지에서 바로 여러 공급자로 호출 가능 |
| 오픈 LLM을 서비스에 붙여 운영비 줄이기 | DeepInfra, Together AI, Fireworks AI | 토큰 단가가 공개되고 대량 처리용 할인이 있음 |
| 모델끼리 성능과 가격 비교 | Artificial Analysis, Arena | 독립 측정과 이용자 투표 순위를 제공 |
AI API 핵심 개념
API 문서를 처음 열면 낯선 말이 쏟아져요. 아래 표의 열 가지만 알면 대부분의 가격표와 설명서를 읽을 수 있어요.
| 용어 | 쉽게 말하면 | 알아둘 점 |
|---|---|---|
| API 키 | 내 계정을 증명하는 긴 비밀번호 | 요청 머리글(헤더)에 붙여 보냄. 공개 코드에 넣으면 안 됨 |
| 엔드포인트 | 요청을 보내는 주소 | 채팅용, 이미지용, 작업 조회용처럼 기능마다 주소가 다름 |
| 토큰 | 모델이 글을 읽고 쓰는 단위 | 영어는 단어보다 조금 작은 조각, 한국어는 글자 몇 개 단위로 잘림 |
| 입력과 출력 요금 | 내가 보낸 글 값, 모델이 쓴 글 값 | 출력이 입력보다 몇 배 비싼 경우가 많음 |
| 추론 토큰 | 생각하는 모델이 답 전에 쓰는 속생각 | 출력 토큰으로 계산됨. 화면에 안 보여도 돈이 나갈 수 있음 |
| 캐시 | 같은 앞부분을 다시 보낼 때 깎아 주는 값 | 긴 지시문이나 대화 기록을 반복할 때 비용이 크게 줄어듦 |
| 속도 제한 | 1분, 1일당 보낼 수 있는 요청과 토큰 수 | 넘으면 429 오류. 잠시 기다렸다 다시 보내야 함 |
| 동기와 비동기 | 바로 답을 받는 방식, 접수 후 나중에 받는 방식 | 이미지와 영상은 비동기, 결과는 조회나 웹훅으로 받음 |
| OpenAI 호환 API | OpenAI와 같은 요청 형식 | 주소와 키만 바꾸면 기존 코드와 도구를 그대로 쓸 수 있음 |
| 서버리스와 전용 | 공용 서버를 쓴 만큼, 내 전용 GPU를 시간만큼 | 적게 쓰면 서버리스, 많이 꾸준히 쓰면 전용이 유리할 수 있음 |
토큰 요금은 네 갈래로 나뉘어요
글을 다루는 모델의 가격표에는 보통 "100만 토큰당 입력 얼마, 출력 얼마"가 적혀 있어요. Fireworks AI 공식 가격 문서는 한 요청을 입력 토큰, 캐시된 입력 토큰, 출력 토큰 세 가지로 나눠 계산한다고 설명해요. 여기에 생각하는 모델의 추론 토큰이 더해져요. OpenRouter 문서는 추론 토큰을 출력 토큰으로 보고 그만큼 요금을 매긴다고 적고 있고, 일부 모델은 그 속생각을 응답에 보여 주지도 않아요. 그래서 "짧게 답했는데 왜 비싸지?" 싶을 때는 추론 토큰부터 의심해 보면 돼요.
캐시는 반대로 돈을 아껴 주는 장치예요. Anthropic 공식 가격표를 보면 캐시 적중은 일반 입력 가격의 10%이고, 5분짜리 캐시를 만드는 쓰기 비용은 입력 가격의 1.25배라서 한 번만 다시 읽어도 이득이 된다고 설명해요. 매번 같은 긴 지시문을 붙이는 자동화라면 캐시를 지원하는 곳과 아닌 곳의 실제 비용 차이가 커요.
바로 받는 호출과 나중에 받는 작업
채팅 모델은 요청을 보내면 그 연결 안에서 답이 돌아오는 동기 방식이 기본이에요. 이미지, 영상, 음악은 몇십 초에서 몇 분이 걸리기 때문에 비동기 방식을 많이 써요. Kie 문서는 이미지, 영상, 음악 생성을 비동기 작업으로 처리하고, 성공 응답에는 작업 번호(taskId)만 들어 있으며 이것은 "접수됐다"는 뜻이지 "완성됐다"는 뜻이 아니라고 설명해요. 결과는 작업 조회 API로 직접 확인하거나, 요청할 때 적어 둔 내 서버 주소로 완료 알림을 받는 웹훅으로 받아요.
fal도 같은 구조예요. 공식 문서는 바로 결과를 받는 run, 대기열을 쓰지만 기다려 주는 subscribe, 접수 후 조회나 웹훅으로 받는 submit 세 가지 호출 방식을 설명하고, 운영 환경에는 submit을 권해요. fal 대기열은 요청을 버리지 않고, 처리 중 서버가 503이나 504 같은 오류를 내면 최대 10번까지 자동으로 다시 넣어 준다고 적혀 있어요.
결과물 보관 기간도 서비스마다 달라요. Replicate는 API로 만든 예측의 입력과 출력 파일을 한 시간 뒤 자동으로 지우고, Kie는 생성된 미디어 파일을 14일 동안 보관해요. 자동화를 짤 때는 결과를 받자마자 내 저장소에 옮겨 두는 단계가 꼭 들어가야 해요.
OpenAI 호환이면 주소만 바꾸면 돼요
요즘 많은 서비스가 OpenAI와 같은 요청 형식을 받아 줘요. 이걸 OpenAI 호환 API라고 해요. Google은 Gemini API를, Groq는 자기 API를, Hugging Face는 라우터를 OpenAI 라이브러리로 쓸 수 있게 열어 두었고, DeepInfra도 150개가 넘는 오픈 모델을 OpenAI 호환 API로 제공한다고 밝혀요. 덕분에 코드는 거의 그대로 두고 두 줄만 바꾸면 공급자를 옮길 수 있어요. 아래는 OpenAI 파이썬 라이브러리에서 주소와 키만 Groq로 바꾼 예시예요.
from openai import OpenAI
client = OpenAI(base_url="https://api.groq.com/openai/v1", api_key="GROQ_API_KEY")
다만 "호환"은 기본 대화 기능이 같다는 뜻이지 모든 옵션이 같다는 뜻은 아니에요. Groq 문서에도 지원하지 않는 OpenAI 기능 목록이 따로 있어요.
라우터와 직접 공급자, 서버리스와 전용
라우터(또는 애그리게이터)는 여러 공급자 앞에 서서 내 요청을 대신 전달해 주는 중개소예요. OpenRouter와 Hugging Face Inference Providers가 여기에 해당해요. 키 하나로 여러 회사의 모델을 쓰고, 한 공급자가 막히면 다른 곳으로 넘길 수 있다는 게 장점이에요. 직접 공급자는 DeepInfra, Fireworks AI, Together AI처럼 자기 GPU에서 모델을 돌려 파는 회사예요. 중개 수수료가 없고 세부 옵션을 다 쓸 수 있지만, 공급자마다 따로 가입하고 충전해야 해요.
서버리스는 여러 사람이 같이 쓰는 서버를 요청한 만큼만 쓰는 방식이고, 전용(dedicated)은 GPU를 통째로 빌려 켜 둔 시간만큼 내는 방식이에요. Replicate 가격 페이지는 공개 모델은 실행 시간만큼만 내지만, 비공개 모델 대부분은 전용 하드웨어에서 돌아가 준비 시간과 놀고 있는 시간까지 과금된다고 설명해요. 처음에는 서버리스로 시작하고, 하루 종일 꾸준히 요청이 들어올 때 전용을 계산해 보면 돼요.
먼저 알아둘 3곳: OpenRouter, Kie, Hugging Face
세 곳은 성격이 달라서 함께 알아 두면 좋아요. OpenRouter는 글 모델의 라우터, Kie는 이미지와 영상 중심의 저가 통합 API, Hugging Face는 오픈 모델의 본거지이자 라우터예요.
| 서비스 | 성격 | 과금 | 확인한 특징 |
|---|---|---|---|
| OpenRouter | 글 모델 중심 라우터 | 크레딧 선불, 구매 수수료 5.5%(Standard) | 무료 모델 변형, 빠른 공급자 정렬(:nitro), 최저가 정렬(:floor) |
| Kie | 이미지, 영상, 음악, LLM 통합 API | 크레딧 선불, 1크레딧 약 0.005달러 | 비동기 작업, 웹훅, 실패한 생성은 과금하지 않는다는 정책 공개 |
| Hugging Face | 오픈 모델 허브와 라우터 | HF 크레딧, 공급자 가격 그대로 | 공급자 18곳 연동, 웃돈 없음, PRO는 매월 2달러 크레딧 |
OpenRouter
OpenRouter는 여러 회사의 글 모델을 키 하나로 쓰게 해 주는 중개 서비스예요. 공식 요금 페이지에 따르면 Standard와 Business 요금제는 크레딧을 사 두고 요청마다 차감하는 방식이고, 차이는 크레딧을 살 때 붙는 수수료예요. Standard는 5.5%, Business는 8%예요. 무료 요금제에는 25개 이상의 무료 모델과 하루 50회 요청 한도가 있고, 크레딧을 일정 금액 이상 사면 무료 모델의 하루 한도가 올라가요.
이미 다른 공급자 키가 있다면 BYOK(내 키 가져오기)로 OpenRouter를 거쳐 쓸 수도 있어요. 이 경우 추론 요금은 공급자가 직접 청구하고, Standard와 Business는 매달 정가 기준 2만 5천 달러어치까지 OpenRouter 수수료가 없으며 그 위로는 같은 요청을 OpenRouter에서 샀을 때 가격의 5%를 떼요.
모델 이름 뒤에 붙이는 꼬리표도 유용해요. FAQ에 따르면 :free는 무료 변형, :nitro는 처리 속도가 빠른 공급자 순, :floor는 가격이 싼 공급자 순으로 보내요. 한 가지 알아둘 점은 같은 모델이라도 실제로 응답한 공급자에 따라 속도가 크게 달라질 수 있다는 거예요. 그래서 운영 단계에서는 공급자를 고정하거나 정렬 기준을 정해 두는 편이 결과가 안정적이에요.
Kie
Kie(kie.ai)는 영상, 이미지, 음악, 채팅 모델을 하나의 API와 하나의 크레딧 잔액으로 쓰게 해 주는 서비스예요. 가격 페이지에는 모델별 크레딧과 달러 가격이 함께 나오는데, 예를 들어 6.5크레딧이 0.0325달러로 적혀 있어 1크레딧은 약 0.005달러로 계산돼요. 같은 표에 "공식 또는 fal 가격" 열을 두고 할인율을 보여 주는 점이 특징이에요.
공식 문서에서 확인되는 운영 규칙은 꽤 구체적이에요.
- 이미지, 영상, 음악은 비동기 작업이고 채팅 모델은 바로 답을 줘요.
- 기본 한도는 계정당 10초에 새 생성 요청 20건이고, 넘으면 429 코드가 오며 그 요청은 대기열에 들어가지 않아요.
- 일부 오류는 HTTP 200으로 오면서 본문 안의 code 값에 429 같은 실제 결과가 담겨 와요. 그래서 상태 코드만 보지 말고 본문의 code를 꼭 확인해야 해요.
- 생성된 미디어는 14일, 로그 기록은 2개월 뒤 자동 삭제돼요.
- 키별로 시간당, 일별, 총 사용 한도와 IP 허용 목록을 설정할 수 있어요.
홈페이지에는 "실패한 생성에는 절대 비용을 내지 않는다"는 정책과 함께 "많은 모델이 공식 API보다 약 30% 싸고 일부는 60~70% 아낄 수 있다", "99% 가용성" 같은 문구가 있어요. 이 할인율과 가용성 숫자는 Kie의 자체 주장이고, 이번 확인에서 이를 따로 검증한 외부 감사 자료는 찾지 못했어요. 그렇다고 불안하다고 볼 근거가 있는 것도 아니라서, 쓰려는 모델 몇 개로 소액 테스트를 해 보고 실패 건이 실제로 차감되지 않는지 사용 기록에서 확인하는 방식이 현실적이에요. Kie 에이전트 기능은 VibeCoding 365의 KIE 에이전트 서비스 글에서 따로 다뤘어요.
Hugging Face Inference Providers
Hugging Face는 오픈 모델이 가장 먼저 올라오는 곳이에요. 여기에 Inference Providers라는 라우터가 붙어 있어서, 모델 페이지를 보다가 바로 여러 공급자로 호출할 수 있어요. 공식 문서의 파트너 표에는 Baseten, Cerebras, Cohere, DeepInfra, Fal AI, Featherless AI, Fireworks, Groq, Novita, Nscale, Replicate, Together, WaveSpeedAI, Z.ai 등 18곳이 올라 있어요.
요금은 공급자 가격을 그대로 받고 Hugging Face가 웃돈을 붙이지 않는다고 명시돼 있어요. 무료 계정은 크레딧을 사야 쓸 수 있고, PRO 사용자와 Team, Enterprise 조직은 매달 2달러 크레딧을 받아요. 모델 이름 뒤에 :fastest를 붙이면 처리량이 가장 높은 공급자로, :cheapest를 붙이면 출력 토큰이 가장 싼 공급자로 보내고, 기본값은 :fastest예요. 이미 공급자 계정이 있다면 내 공급자 키를 등록해서 그 공급자가 직접 청구하게 할 수도 있어요.
핵심 포인트: Hugging Face 공급자 목록에 있다는 건 "Hugging Face에서 그 공급자로 실제 추론 요청을 보낼 수 있다"는 뜻이에요. 장애가 없다거나 모든 모델 품질이 같다는 보증은 아니에요.
실제로 결제해서 쓰는 API 공급자
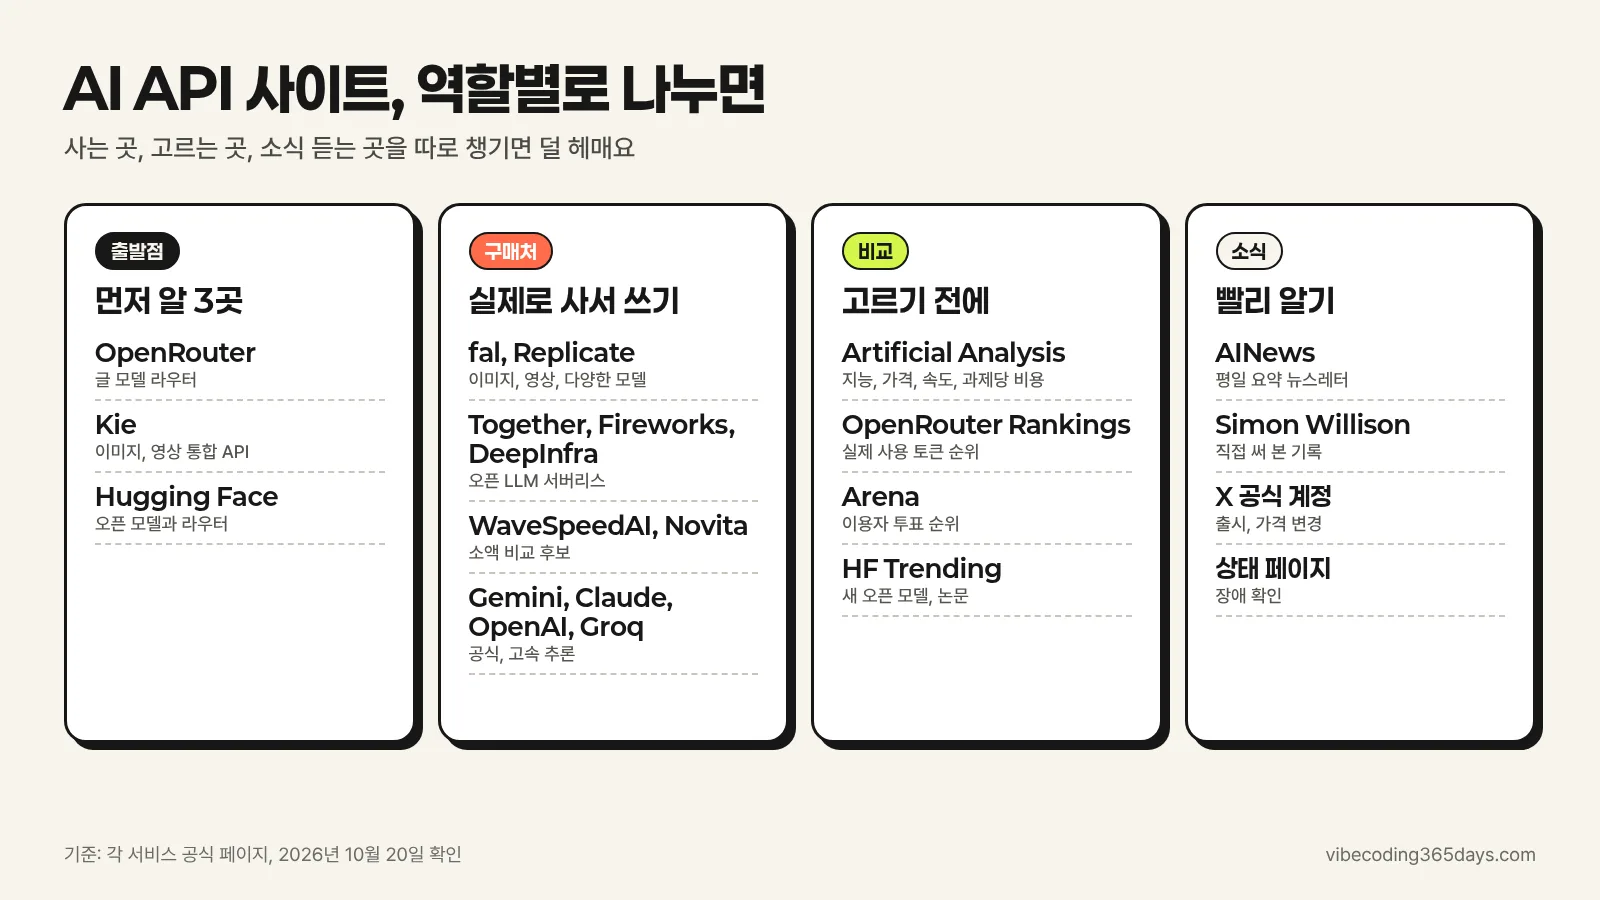
여기부터는 공개된 가격표와 API 문서가 있고, 운영 주체와 투자 이력을 공식 발표로 확인할 수 있는 곳들이에요. 다섯 곳 모두 Hugging Face Inference Providers 파트너이기도 해요. 투자와 고객사는 회사가 실제로 운영되고 있다는 근거이지, 지금 이 순간의 속도나 가동률을 독립적으로 보증하는 자료는 아니에요.
| 서비스 | 주력 | 과금 방식 | 확인한 운영 근거 |
|---|---|---|---|
| fal | 이미지, 영상, 음성 생성형 미디어 | 모델별 건당, 초당, 토큰당 | 2025년 12월 140M달러 Series D(Sequoia, Kleiner Perkins, NVIDIA 참여). 투자사 First Round 인터뷰에 Adobe, Canva, Shopify 고객 언급 |
| Replicate | 커뮤니티 모델 실행, 커스텀 모델 배포 | 실행 시간과 하드웨어, 또는 입출력 | 2025년 12월 1일 Cloudflare에 공식 편입 |
| Together AI | 오픈 모델 추론, 파인튜닝 | 토큰, 메가픽셀, 초 단위 서버리스 | 2026년 7월 800M달러 Series C(Aramco Ventures 주도). Cursor, Cognition, Decagon 등 고객 공개 |
| Fireworks AI | 오픈 모델 추론, 최적화, 맞춤 배포 | 입력, 캐시 입력, 출력 토큰 | 2026년 7월 1.505B달러 Series D(평가액 175억 달러). Samsung, Uber, DoorDash, Notion, Shopify 고객 공개 |
| DeepInfra | 오픈 모델 추론 API | 토큰 또는 실행 시간 | 2026년 5월 107M달러 Series B. 미국 데이터센터 8곳 자체 운영, 데이터 무보관 |
이미지와 영상 중심: fal, Replicate
fal은 생성형 미디어 전문이에요. 모델마다 놀이터(Playground), API 스키마, 가격, 예제 코드가 한 페이지에 있어 비교와 도입이 편해요. 가격 페이지에는 영상 모델이 초당 가격으로 정리돼 있어서, 같은 길이의 클립을 다른 곳과 바로 견줘 볼 수 있어요. 신모델 대응도 강점으로 꼽히는데, 공동 창업자 인터뷰에는 FLUX 모델 개발팀과 출시 전부터 연락해 함께 대형 출시를 준비했다는 이야기가 나와요. 다만 모든 신모델을 항상 가장 먼저 낸다고 볼 근거는 없어요.
Replicate는 모델 종류가 넓은 실험실 같은 곳이에요. 공개 모델 수천 개를 API로 돌릴 수 있고, Cog라는 도구로 내 모델을 올려 배포할 수도 있어요. 대부분의 모델은 실행 시간과 하드웨어 기준으로, 일부는 출력 이미지 한 장이나 영상 1초 같은 입출력 기준으로 과금돼요. 그래서 "호출 한 번에 얼마"로 단순 비교하지 말고 모델 페이지의 예상 비용을 건당 가격으로 바꿔 봐야 해요. Cloudflare 편입 이후 Replicate의 상태 정보는 Cloudflare 상태 페이지에서 함께 보여 줘요.
오픈 LLM 중심: Together AI, Fireworks AI, DeepInfra
세 곳은 DeepSeek, Qwen, Kimi, GLM 같은 오픈 모델을 서버리스 API로 파는 대표 공급자예요. 공통점은 대량 처리용 Batch 할인이에요. Fireworks AI는 Batch를 서버리스 가격의 50%로, Together AI는 최대 50% 낮은 비용으로 안내해요.
DeepInfra는 가격 정보가 특히 자세해요. 모델별 입력, 캐시 입력, 출력 가격이 나오고, 요청 우선순위를 고르는 서비스 등급도 공개돼 있어요. 기본 Standard는 1배, 붐빌 때 먼저 처리하는 Priority는 1.5배, 느려도 되는 비운영 작업용 Flex는 0.8배 가격이에요. 계정당 동시 요청은 기본 200건으로 제한된다고 적혀 있어요.
Together AI 문서에는 속도 제한을 만났을 때의 대처도 나와요. 429 응답을 받으면 요청 속도를 줄이고, 503을 받으면 잠깐 기다렸다가 점점 간격을 늘리며 다시 시도하라고 안내해요. 서버리스 요청이 처리되는 지역은 고를 수 없고, 특정 지역이 필요하면 전용 엔드포인트를 써야 해요.
소액으로 비교해 볼 후보: WaveSpeedAI, Novita AI
두 곳도 Hugging Face 공급자 목록에 있고 공개 가격표가 있어요. 다만 이번에 확인한 대형 고객이나 투자 발표 자료는 위 다섯 곳보다 적어서, 작은 금액으로 먼저 써 보는 쪽이 좋아요.
WaveSpeedAI는 Hugging Face가 "이미지와 영상 생성 전문 추론 플랫폼"으로 소개하는 곳이에요. 자체 가격 페이지는 요청, 초, 메가픽셀, 토큰 단위 과금을 공개하고, 이미지는 장당, 영상은 초당 시작 가격을 보여 줘요. 최근에는 Claude, GPT, Gemini 같은 글 모델도 함께 팔고 있어요. Novita AI는 Hugging Face가 LLM, 이미지, 영상, 음성을 아우르는 200개 이상의 API 플랫폼으로 소개하고, Hugging Face에서는 LLM과 비전 대화, 텍스트 투 비디오를 지원해요. 가격표에는 입력, 캐시 읽기, 출력 가격이 모델별로 나오고, 지원 모델의 Batch를 도입가 50% 할인으로 제공해요.
공식 API와 빠른 추론 서비스
라우터나 재판매처를 거치지 않고 모델 회사에서 직접 사는 방법도 있어요. 가장 최신 기능을 가장 먼저 쓰고 정책이 명확하다는 장점이 있고, 대신 회사마다 키와 결제를 따로 관리해야 해요.
| 서비스 | 성격 | 알아둘 점 |
|---|---|---|
| Google AI Studio | Gemini 공식 API | 무료 등급 있음(내용이 제품 개선에 쓰일 수 있음). 유료는 Batch 50% 할인, OpenAI 호환 주소 제공 |
| Anthropic API | Claude 공식 API | Batch 50% 할인, 캐시 적중은 입력 가격의 10% |
| OpenAI API | GPT 공식 API | Batch는 50% 저렴하고 24시간 안에 처리, 일반 요청과 별도 한도 |
| Groq | 자체 칩(LPU) 기반 고속 추론 | OpenAI 호환, 조직 단위 RPM, RPD, TPM 한도. HF 공급자 |
| Cerebras | 고속 추론 전문 클라우드 | 결제수단 등록 시 30일짜리 5달러 크레딧 1회, 개발과 평가용 등급 따로 있음. HF 공급자 |
Groq 문서는 속도 제한을 이해하기 좋은 예를 들어 줘요. 1분에 50번(RPM), 1분에 20만 토큰(TPM)이 한도인 계정이 100토큰짜리 요청 50개를 1분 안에 보내면, 토큰은 한참 남았어도 요청 횟수 한도에 먼저 걸려요. 한도는 개인이 아니라 조직 단위로 걸리고, 응답 헤더에 남은 요청 수와 토큰 수가 같이 와요.
Batch는 "급하지 않은 일을 반값에 맡기는 창구"예요. OpenAI 공식 문서는 Batch API가 50% 낮은 비용, 별도의 높은 한도, 24시간 안의 처리 시간을 제공한다고 설명해요. 밤사이 상품 설명 1만 건을 만들거나 지난 글 전체를 다시 분류하는 자동화라면 실시간 호출 대신 Batch를 먼저 검토할 만해요.
분야별 전문 API와 GPU 서버리스
특정 분야만 깊게 다루거나, 모델 대신 GPU 자체를 초 단위로 빌려주는 곳도 알아 두면 쓸모가 있어요.
- Runware: 이미지, 영상, 오디오, 글, 3D 모델을 하나의 엔드포인트로 제공해요. 가격 페이지에 공개 단가가 있는 모델이 300개 이상이고, 이미지는 장당, 영상은 클립당, LLM은 100만 토큰당으로 예시 가격을 보여 줘요. 업무용 메일로 가입하면 2달러 크레딧을 줘요.
- ElevenLabs: 음성 합성(TTS)과 음성 에이전트 전문이에요. API는 쓴 만큼 내는 방식과 월 요금제가 있고, 모델별로 1천 자당 가격을 공개해요.
- Modal: 모델이 아니라 GPU와 CPU를 초 단위로 빌려주는 서버리스 컴퓨팅이에요. 놀고 있는 시간은 과금하지 않고, Starter 요금제에 매달 30달러 무료 크레딧이 들어 있어요. 내가 고른 오픈 모델을 직접 띄워야 할 때 써요.
성능과 가격을 비교하는 곳
어디서 살지 정하기 전에 "어떤 모델을 살지"부터 비교해야 해요. 아래 곳들은 직접 API를 팔지 않고 판단 자료를 줘요.
Artificial Analysis
Artificial Analysis는 모델의 지능 점수, 100만 토큰당 가격, 초당 출력 속도, 첫 토큰까지 걸리는 시간, 컨텍스트 길이를 직접 측정해 비교하는 독립 분석 사이트예요. 특히 쓸모 있는 지표는 "과제 하나당 비용(Cost per Task)"이에요. 입력, 캐시, 추론, 답변 토큰 가격과 실제로 쓴 토큰 수를 곱해 계산하기 때문에, 단가는 싸지만 생각을 길게 하는 모델의 진짜 비용이 드러나요. 2026년 10월 13일에는 공급자별 캐시 적중률과 과제당 비용을 공개했는데, 공식 X 계정 설명에 따르면 같은 GLM-5.3 모델도 공급자에 따라 과제당 비용이 약 9배까지 차이 났어요.
OpenRouter Models와 Rankings
OpenRouter Models는 모델별 가격, 컨텍스트, 지원 공급자를 한 화면에서 보는 카탈로그예요. API를 OpenRouter로 부르지 않더라도 "이 모델을 어느 공급자가 얼마에 파는지" 찾는 북마크로 쓸 만해요. Rankings는 OpenRouter를 통해 처리된 토큰 양으로 모델 순위를 매기고, 최근 7일 증가율로 뜨는 모델도 보여 줘요. 실제 사용량 기준이라 "요즘 개발자들이 무엇을 쓰는지" 감을 잡기에 좋고, 데이터는 CC BY 4.0으로 출처를 밝히면 다시 쓸 수 있어요.
Arena
Arena는 예전 LMArena가 2026년 1월 28일 이름을 바꾼 곳이에요. 사람들이 두 모델의 답을 나란히 보고 더 나은 쪽에 투표한 결과로 순위를 만들고, 글뿐 아니라 코드, 이미지, 영상 분야 순위도 있어요. 벤치마크 점수가 높은데 실제 대화 품질이 어떤지 궁금할 때 참고하기 좋아요.
Hugging Face Trending
새 오픈 모델은 Hugging Face 트렌딩 모델 목록에 가장 먼저 떠요. 연구 논문 쪽은 2025년 7월 문을 닫은 Papers with Code 주소가 지금 Hugging Face Trending Papers로 연결돼요. Hugging Face 스스로도 예전 Papers with Code를 1대1로 대신하는 서비스는 아니라고 밝혔으니, 성능 순위표는 Artificial Analysis나 Arena에서 보는 편이 맞아요.
새 모델 소식을 빨리 따라가는 곳
소식을 빨리 아는 것과 그 모델을 API로 쓸 수 있는 것은 별개예요. 아래 채널로 소식을 받고, 실제 도입 전에는 공급자의 모델 목록과 가격표를 다시 확인하는 순서가 안전해요.
- AINews: AI 관련 Discord, Reddit, X의 이야기를 모아 평일마다 요약하는 뉴스레터예요. smol.ai가 시작했고, 지금은 Latent Space 뉴스레터 안의 "AINews: Weekday Roundups" 섹션으로도 발행돼요. Latent Space 유료 구독 혜택에 평일 전체판이 들어 있어요.
- Simon Willison 블로그: Django 공동 개발자인 Simon Willison이 새 모델과 도구를 직접 써 보고 거의 매일 기록하는 블로그예요. 가격이나 기능의 바뀐 점을 짧게 짚어 줘서 개발자들이 많이 구독해요.
- Latent Space: AI 엔지니어용 뉴스레터와 팟캐스트예요. 모델 회사와 인프라 회사 관계자 인터뷰가 많아요.
X에서는 아래 계정을 팔로우해 두면 출시와 가격 변경 소식이 빨리 들어와요. 계정 이름은 2026년 10월 20일 X에서 직접 조회한 것이에요.
| 계정 | 무엇을 올리나 |
|---|---|
| @OpenRouter | 새 모델 입점, 무료 모델, 공급자 추가 |
| @ArtificialAnlys | 새 모델 측정 결과, 가격과 속도 비교 |
| @arena | 리더보드 변화 |
| @huggingface, @_akhaliq | 오픈 모델과 새 논문 |
| @fal, @replicate | 이미지와 영상 모델 입점 |
| @OpenAIDevs, @GoogleAIStudio | 공식 API 기능과 가격 변경 |
| @simonw, @latentspacepod | 개발자 관점 해설, AINews |
상태 페이지도 북마크해 두세요
자동화가 갑자기 멈췄을 때 내 코드 문제인지 공급자 장애인지 가장 빨리 가르는 방법은 상태 페이지예요. 이번에 열어 본 공식 상태 페이지는 OpenRouter, Hugging Face, fal, Together AI, Fireworks AI, DeepInfra, OpenAI, Claude, Google AI Studio, Groq이고, Replicate는 Cloudflare 상태 페이지에서 함께 보여 줘요. Kie는 별도 공개 상태 페이지를 찾지 못했고, 대신 Telegram과 Discord 전용 지원 채널을 안내해요.
결과물 1개당 비용으로 계산하기
합리적인 가격은 표시 단가가 아니라 "쓸 만한 결과물 1개를 얻는 데 든 돈"으로 판단해야 해요. 같은 모델을 같은 날 비교해도 내 작업의 입력과 출력 비율에 따라 순위가 뒤집히거든요.
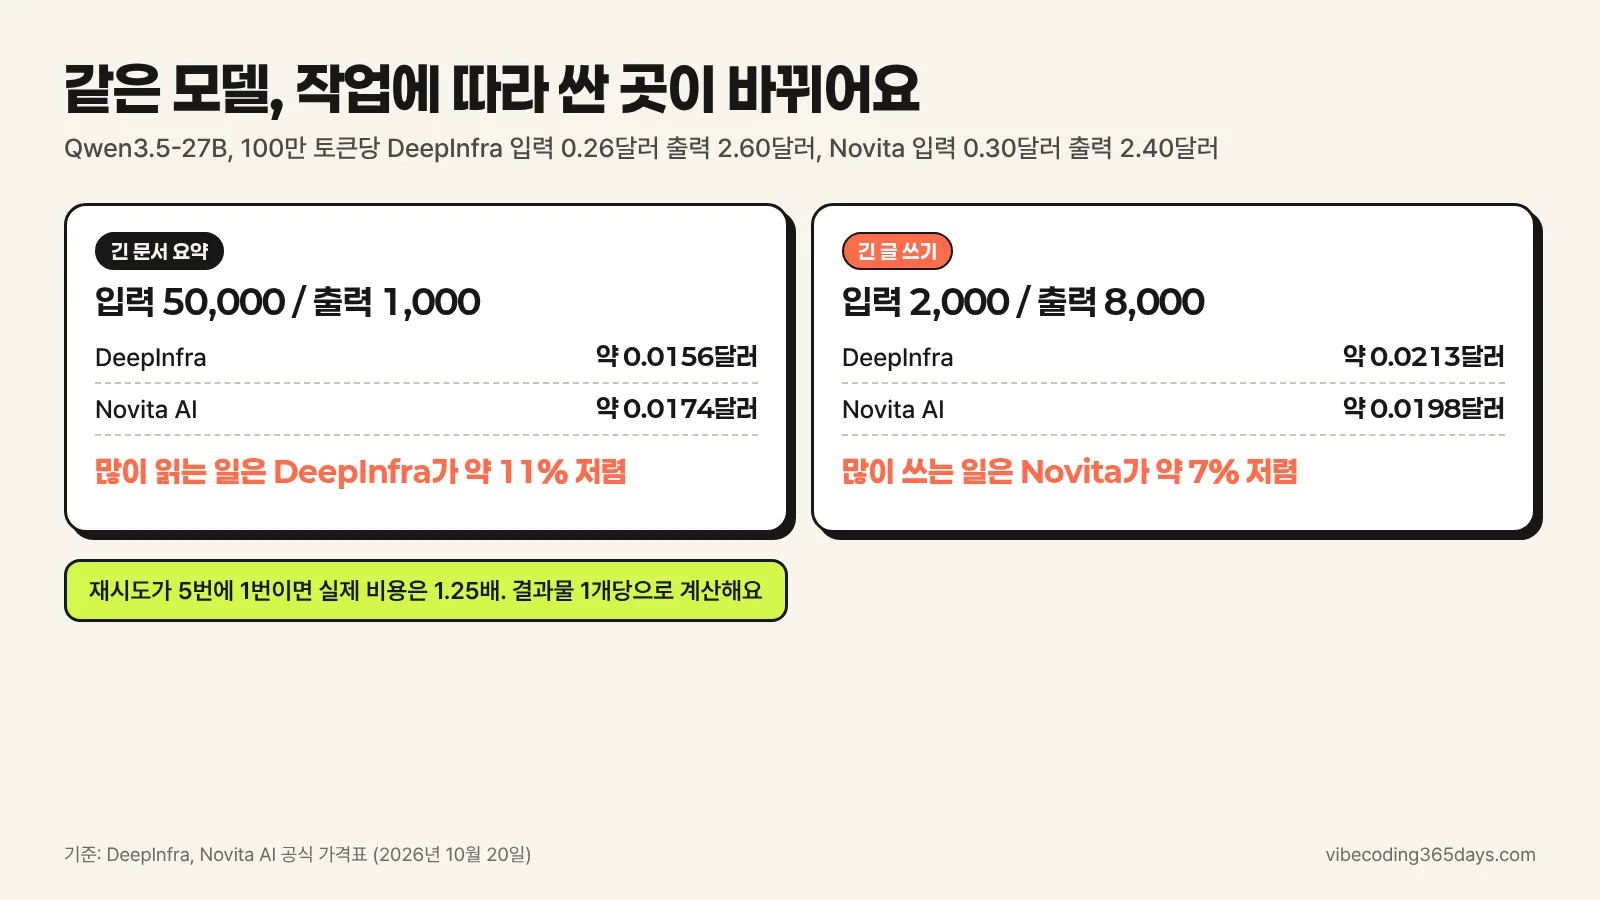
예를 들어 Qwen3.5-27B 모델은 2026년 10월 20일 기준 DeepInfra에서 100만 토큰당 입력 0.26달러, 출력 2.60달러이고, Novita AI에서는 입력 0.30달러, 출력 2.40달러예요. 입력은 DeepInfra가, 출력은 Novita가 싸요. 이걸 두 가지 작업에 넣어 보면 이렇게 달라져요.
| 작업 예시 | 입력 토큰 | 출력 토큰 | DeepInfra | Novita AI |
|---|---|---|---|---|
| 긴 문서 요약 | 50,000 | 1,000 | 약 0.0156달러 | 약 0.0174달러 |
| 짧은 지시로 긴 글 쓰기 | 2,000 | 8,000 | 약 0.0213달러 | 약 0.0198달러 |
요약처럼 많이 읽고 짧게 쓰는 일은 DeepInfra가 약 11% 싸고, 긴 글을 쓰는 일은 Novita가 약 7% 싸요. 여기에 실패와 재시도를 더해야 해요. 다섯 번 중 한 번 결과가 마음에 안 들어 다시 돌린다면 실제 비용은 표의 1.25배가 되고, 생각하는 모델이라면 보이지 않는 추론 토큰이 출력에 더해져요.
이미지와 영상은 계산 단위가 달라요. 해상도, 길이, 소리 포함 여부, 그리고 쓸 만한 컷이 나올 때까지 몇 번 생성했는지가 비용을 정해요. WaveSpeedAI 가격표의 Veo 3.1 Fast 시작가는 초당 0.10달러라서 8초 클립 하나는 0.80달러인데, 세 번 만들어 하나를 고른다면 결과물 1개당 2.40달러가 돼요. 실패한 생성을 과금하지 않는 곳이라면 "오류로 끝난 작업" 비용은 빠지지만, 결과가 나왔는데 마음에 안 드는 경우는 여전히 비용이에요.
LLM과 미디어를 함께 따져 보면 확인할 항목은 이렇게 정리돼요.
- LLM: 입력, 출력, 추론 토큰, 캐시 적중, 재시도 횟수
- 이미지와 영상: 해상도, 길이, 오디오, 실패와 재생성 횟수
- 공통: 속도 제한, 결과물 보관 기간, 데이터 보관 정책, 상업적 이용 조건, 장애 때 넘길 대체 공급자
더 자세한 공급자별 가격 비교는 VibeCoding 365의 딥시크 API 제공사 비교 글에서 DeepSeek 모델을 예로 다뤘어요.
여러 API를 묶어 쓸 때: LiteLLM
공급자가 세 곳 이상으로 늘면 키와 예산 관리가 일이 돼요. LiteLLM은 API를 파는 곳이 아니라 여러 공급자를 하나의 주소로 묶어 운영하는 오픈소스 프록시예요. 공식 문서에 따르면 "OpenAI는 하루 100달러, Azure는 하루 100달러"처럼 공급자별 예산, 모델별 예산, 서비스 태그별 예산을 걸 수 있어요. v1.92 이후에는 키별 모델 예산을 넘었을 때 오류를 내는 대신 미리 정한 다른 모델로 요청을 넘기는 예산 대체(budget fallbacks) 기능도 있어요.
처음부터 필요한 도구는 아니에요. 키가 두세 개일 때는 각 서비스의 지출 한도로 충분하고, 팀이 함께 쓰거나 한 달 비용 상한을 반드시 지켜야 할 때 검토하면 돼요.
마무리
앞에서 다룬 AI API 개념과 사이트를 짧게 정리하면 이래요.
- AI API는 키를 붙여 주소로 요청하고 쓴 만큼 내는 구조이고, 글 모델은 입력, 출력, 추론, 캐시 토큰으로 값이 정해져요.
- 이미지와 영상은 비동기 작업이 많아 작업 조회나 웹훅으로 결과를 받고, 보관 기간이 짧으니 바로 옮겨 둬야 해요.
- 출발점은 OpenRouter(글 모델 라우터), Kie(미디어 중심 통합 API), Hugging Face(오픈 모델과 라우터)예요. Kie의 할인율과 가용성 숫자는 자체 주장이에요.
- 실제 구매처로는 fal, Replicate, Together AI, Fireworks AI, DeepInfra를 먼저 비교하고, WaveSpeedAI와 Novita AI는 소액 테스트 후 추가하면 좋아요.
- 모델 비교는 Artificial Analysis, OpenRouter Rankings, Arena, 소식은 AINews, Simon Willison 블로그, X 공식 계정으로 받아요.
- 가격은 표시 단가가 아니라 성공한 결과물 1개당 비용으로 계산하고, 상태 페이지와 지출 한도를 함께 챙겨요.
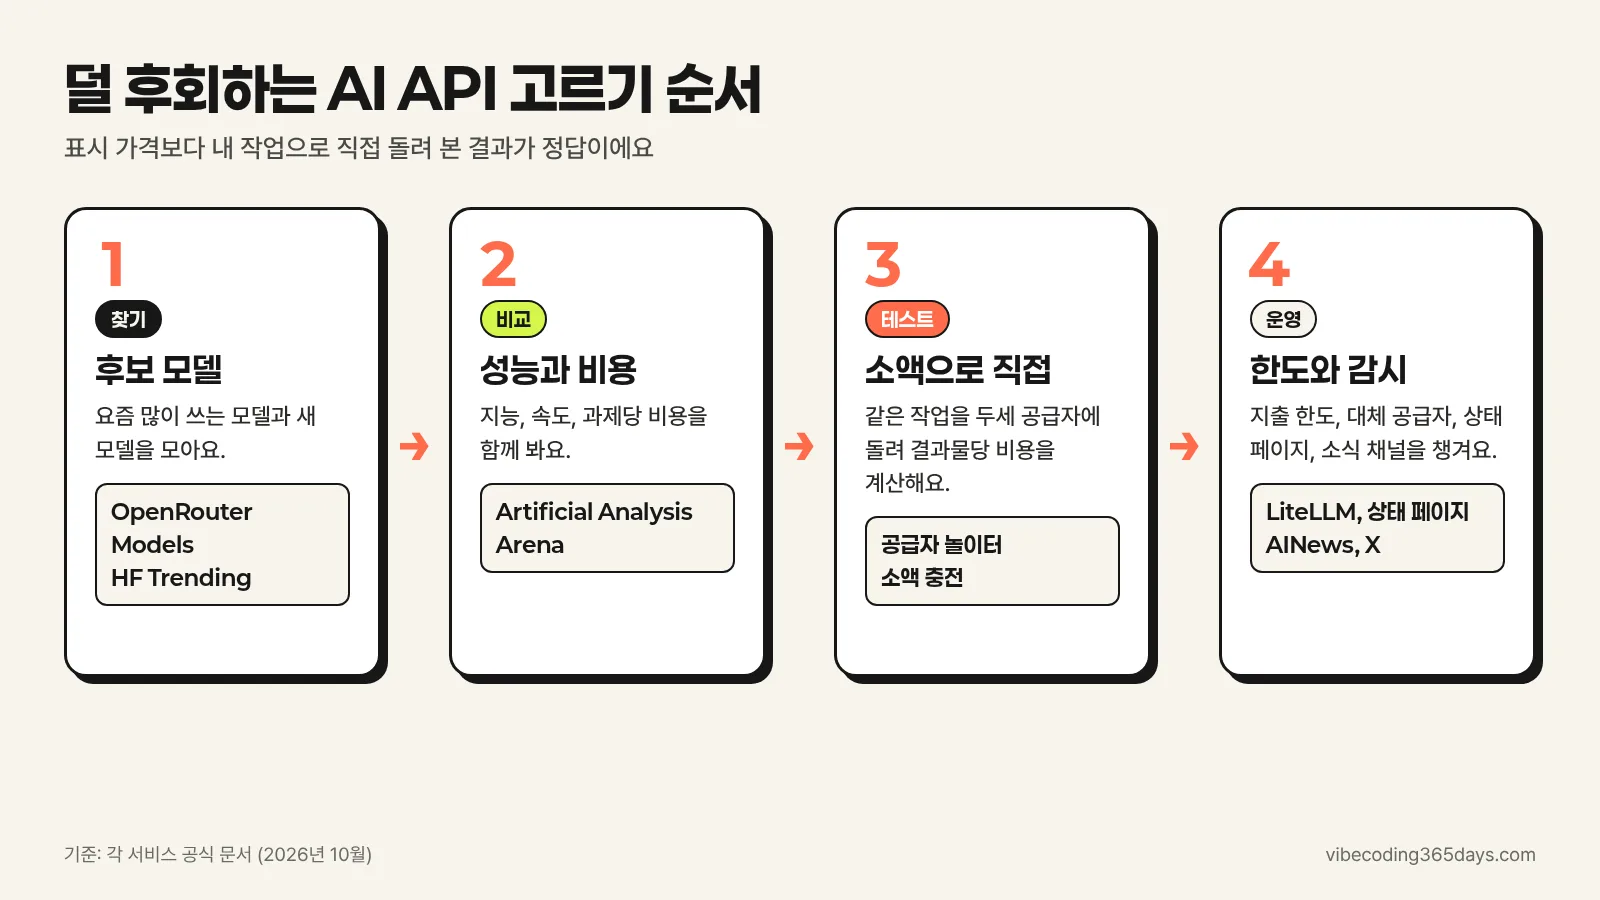
「찾고, 비교하고, 내 작업으로 직접 테스트한 뒤 사기」 OpenRouter와 Hugging Face에서 후보를 찾고, Artificial Analysis로 성능과 비용을 비교한 다음, 내 실제 작업 몇 건으로 두세 공급자를 돌려 보고 정하는 순서가 가장 덜 후회하는 방법이에요.
출처와 링크
조사 기준: 2026년 10월 20일. 가격과 정책은 바뀔 수 있으니 결제 전 각 공식 페이지를 다시 확인해 주세요.
- Hugging Face Inference Providers 문서, 요금과 청구, WaveSpeed, Novita
- OpenRouter 요금, FAQ, 추론 토큰, Rankings
- Kie 홈, Kie 가격, Kie 문서
- fal Model APIs 개요, fal 대기열, fal 가격, fal Series D, First Round 인터뷰
- Replicate 가격, Replicate 웹훅, Cloudflare 편입 발표
- Together AI 서버리스, Together AI Series C
- Fireworks AI 서버리스 가격, Fireworks Series C, Fireworks Series D
- DeepInfra 가격, DeepInfra Series B
- WaveSpeedAI 가격, Novita AI 가격
- Gemini API 가격, Gemini OpenAI 호환, Anthropic 가격, OpenAI Batch
- Groq OpenAI 호환, Groq 속도 제한, Cerebras 가격
- Runware 가격, ElevenLabs API 가격, Modal 가격
- Artificial Analysis 모델 비교, Arena 리더보드, LMArena 개명 발표, Hugging Face Trending Papers
- AINews(Latent Space), Simon Willison 블로그
- LiteLLM 예산 라우팅, LiteLLM 예산 대체
FAQ
자주 묻는 질문
OpenRouter와 Hugging Face Inference Providers는 무엇이 다른가요?
둘 다 여러 공급자 앞에 선 라우터지만 출발점이 달라요. OpenRouter는 상용 모델과 오픈 모델을 섞어 글 모델 위주로 묶고 크레딧 구매 때 수수료를 받아요. Hugging Face는 허브에 올라온 오픈 모델을 파트너 공급자로 바로 보내 주는 구조이고 공급자 가격에 웃돈을 붙이지 않는다고 밝히고 있어요.
API 키가 유출되면 어떤 일이 생기나요?
키를 가진 사람은 누구든 내 계정의 충전금으로 요청을 보낼 수 있어서, 몇 시간 만에 크레딧이 바닥날 수 있어요. 유출을 알게 되면 대시보드에서 해당 키를 즉시 폐기하고 새 키를 만드는 것이 먼저예요. 평소에는 키별 사용 한도와 IP 허용 목록을 걸어 두면 피해 범위를 줄일 수 있어요.
무료 모델만으로 자동화를 돌릴 수 있나요?
가벼운 테스트는 가능하지만 운영용으로는 한계가 커요. OpenRouter 무료 요금제는 하루 요청 수가 정해져 있고, 무료 모델은 붐비는 시간에 느려지거나 예고 없이 빠질 수 있어요. 매일 정해진 시간에 돌아야 하는 자동화라면 소액이라도 유료 모델을 기본으로 두고 무료 모델은 보조로 쓰는 편이 안정적이에요.
429 오류는 왜 생기고 어떻게 처리하나요?
429는 정해진 시간 안에 보낼 수 있는 요청 수나 토큰 수를 넘었다는 뜻이에요. 잠시 기다렸다가 간격을 점점 늘리며 다시 보내는 지수 백오프 방식이 일반적이고, 응답 헤더에 남은 한도와 초기화 시각을 알려 주는 서비스도 많아요. 계속 걸린다면 요청을 묶어 Batch로 보내거나 한도 상향을 문의하는 방법이 있어요.
Batch API를 쓰면 무엇이 불리한가요?
결과가 바로 오지 않는다는 점이 가장 큰 차이예요. OpenAI Batch는 24시간 안 처리를 약속하는 방식이라 채팅 응답이나 실시간 화면에는 맞지 않아요. 대신 밤사이 대량 요약이나 분류처럼 기다려도 되는 일에서는 같은 모델을 절반 가격에 쓸 수 있어요.
Kie에서 실패한 생성은 정말 돈이 빠지지 않나요?
Kie는 홈페이지에 실패한 생성에는 비용을 받지 않는다는 정책을 내걸고 있어요. 다만 이 정책이 모든 모델과 오류 유형에 똑같이 적용되는지는 외부 감사 자료로 확인되지 않았어요. 작업 기록 화면에서 실패 건의 차감 여부를 직접 보고, 결과는 나왔지만 품질이 나쁜 경우는 실패로 치지 않는다는 점도 감안하는 게 좋아요.
OpenAI 호환 API라면 모든 도구에서 그대로 쓸 수 있나요?
기본 채팅 요청은 대부분 그대로 동작하지만, 도구 호출, 구조화된 출력, 이미지 입력 같은 고급 옵션은 공급자마다 지원 범위가 달라요. Groq처럼 지원하지 않는 기능 목록을 따로 공개하는 곳도 있어요. n8n이나 코딩 에이전트에 붙일 때는 사용하는 기능 한두 개를 먼저 시험해 보고 넘어가는 것이 안전해요.
용어
관련 용어
사용자가 로그인한 상태를 악용해, 공격자가 다른 사이트에서 원치 않는 요청을 대신 보내게 만드는 공격이다. 쿠키 기반 로그인은 브라우저가 쿠키를 자동으로 붙여 보내기 때문에, 방어가 없으면 사용자가 모르는 사이에 설정 변경이나 결제 같은 요청이 실행될 수 있다. 방어 방법은 CSRF 토큰, SameSite 쿠키, 중요한 요청의 재확인, Origin/Referer 검증 등이 있다. AI에게 폼 제출이나 관리자 API를 만들게 할 때 '쿠키 인증이면 CSRF 방어도 포함해줘'라고 명시해야 한다.
AI 모델·프로바이더 토큰LLM이 텍스트를 처리하는 기본 단위로, AI 모델의 비용 산정과 성능을 이해하는 데 가장 기본이 되는 개념이다. 토크나이저(tokenizer)라는 알고리즘이 텍스트를 토큰으로 분할하며, 단어 하나가 반드시 토큰 하나가 되는 것은 아니다. 영어의 경우 대략 단어 1개 ≈ 1~1.5 토큰이지만, 한국어는 음절 단위로 분할되어 같은 의미의 텍스트가 영어보다 2~3배 많은 토큰을 소비한다(예: '안녕하세요' ≈ 3~5 토큰). 코드의 경우 'console.log("Hello World")' ≈ 약 6토큰이다. 토큰은 AI 코딩 도구의 사용량과 비용을 결정하는 핵심 단위로, API 과금은 입력 토큰과 출력 토큰을 각각 계산한다. 모델마다 다른 토크나이저를 사용하므로, 같은 텍스트도 모델에 따라 소비하는 토큰 수가 다를 수 있다. 바이브 코딩에서 예상보다 비용이 높아지는 주요 원인이 토큰 소비이므로, 컨텍스트 엔지니어링을 통해 불필요한 토큰 소비를 줄이는 것이 비용 관리의 핵심이다.
프롬프트 엔지니어링 출력 형식AI가 답변이나 코드를 어떤 구조로 내야 하는지 미리 정하는 규칙이다. 초보자는 '설명해줘'보다 '수정할 파일, 이유, 코드 변경, 테스트 명령, 남은 위험 순서로 답해줘'처럼 출력 형식을 지정하면 결과를 훨씬 쉽게 검토할 수 있다. VIBE 코딩에서 출력 형식은 사람의 리뷰 시간을 줄이는 품질 게이트다. 예를 들어 JSON, 표, 체크리스트, 단계별 목록 중 무엇이 필요한지 정하면 AI가 장황한 설명으로 핵심을 숨기거나, 코드만 던지고 검증 방법을 빼먹는 일을 줄일 수 있다. 자동화 파이프라인에서는 특히 정해진 형식이 중요하며, 형식이 어긋나면 후속 스크립트나 테스트가 실패할 수 있다.
링크
관련 링크
Google이 종료한 서비스와 제품을 한눈에 모아, 플랫폼 의존성과 제품 지속성 리스크를 판단하게 해 주는 ‘Google 묘지’ 아카이브입니다.
VIBE 코딩 보안 테이텀 시큐리티 Threads쉬운 보안을 지향하는 한국어 보안 계정으로, AI·VIBE 코딩 흐름에서 놓치기 쉬운 보안 감각을 되짚는 데 유용합니다.
VIBE 코딩 레퍼런스 웹사이트 해부도 · Website Anatomy MapAI와 웹사이트를 함께 만들 때 ‘그 부분’이 아니라 정확한 UI·웹 용어로 지시할 수 있게 돕는 영-한 시각 사전입니다.
관련 글
관련 글
Recommended
딥시크 API 싸게 쓰는 곳 | V4.1 Flash, V4 Pro 가격과 데이터 무보관 제공사 비교
딥시크(DeepSeek)는 중국 항저우의 AI 회사이자, 그 회사가 만든 대형 언어 모델 이름이에요. 모델 가중치를 공개하는 오픈 웨이트 방식이라 딥시크 본사 말고도 미국, 싱가포르, 중국, 국내의 여러 회사가 같은 모델을 자기 서버에 올려 API로 팔아요. 그래서 같은 딥시크를 쓰더라도 어디서 부르느냐에 따라 가격이 몇 배씩 차이 나고, 내가 보낸 코드와 대화가 어느 나라 서버에 남는지도 달라져요.
여기서 API는 프로그램이 인터넷으로 모델을 불러 쓰는 연결 창구이고, 요금은 토큰 단위로 매겨져요. 토큰은 모델이 글을 읽기 위해 잘게 자른 조각으로, 보통 단어보다 작은 단위예요. OpenCode나 Cursor 같은 코딩 도구에 API 키를 넣고 딥시크를 코딩 에이전트로 쓰면, 에이전트가 파일을 읽고 고칠 때마다 코드 전체가 토큰으로…
Gemini 4 Argon 드디어 공개 | 누가 쓸 수 있고 얼마인지, 윈도우에서 API·Antig…
Gemini 4 Argon(제미나이 4 아르곤)은 구글이 10월 13일(한국 시간 10월 14일 새벽 1시)에 정식으로 풀기 시작한 최상위 AI 모델이다. 지금까지 구글의 가장 강한 모델이던 Gemini 3.1 Pro 다음 세대에 해당하고, 구글은 이 모델을 코딩, 기업 업무, 사이버 보안 방어 세 분야를 겨냥해 만들었다고 설명한다. 이름 끝의 "Argon"은 크기 등급이 아니라 이번 세대 첫 모델에 붙인 이름이다. 한 번의 답변으로 최대 100만 토큰까지 길게 써 내려갈 수 있다는 점이 가장 눈에 띄는 변화다.
바이브 코딩을 하는 사람에게 중요한 질문은 세 가지다. 어디서 쓸 수 있는지, 돈이 얼마나 드는지, 내가 쓰는 도구에 바로 붙일 수 있는지다. 결론부터 말하면 무료로는 쓸 수 없다. Google AI Ultra 구독자이거나, 결제를…